LIHKG ist ein beliebtes Online-Diskussionsforum, das in Hongkong und in kantonesischsprachigen Gemeinschaften weltweit große Popularität erlangt hat.
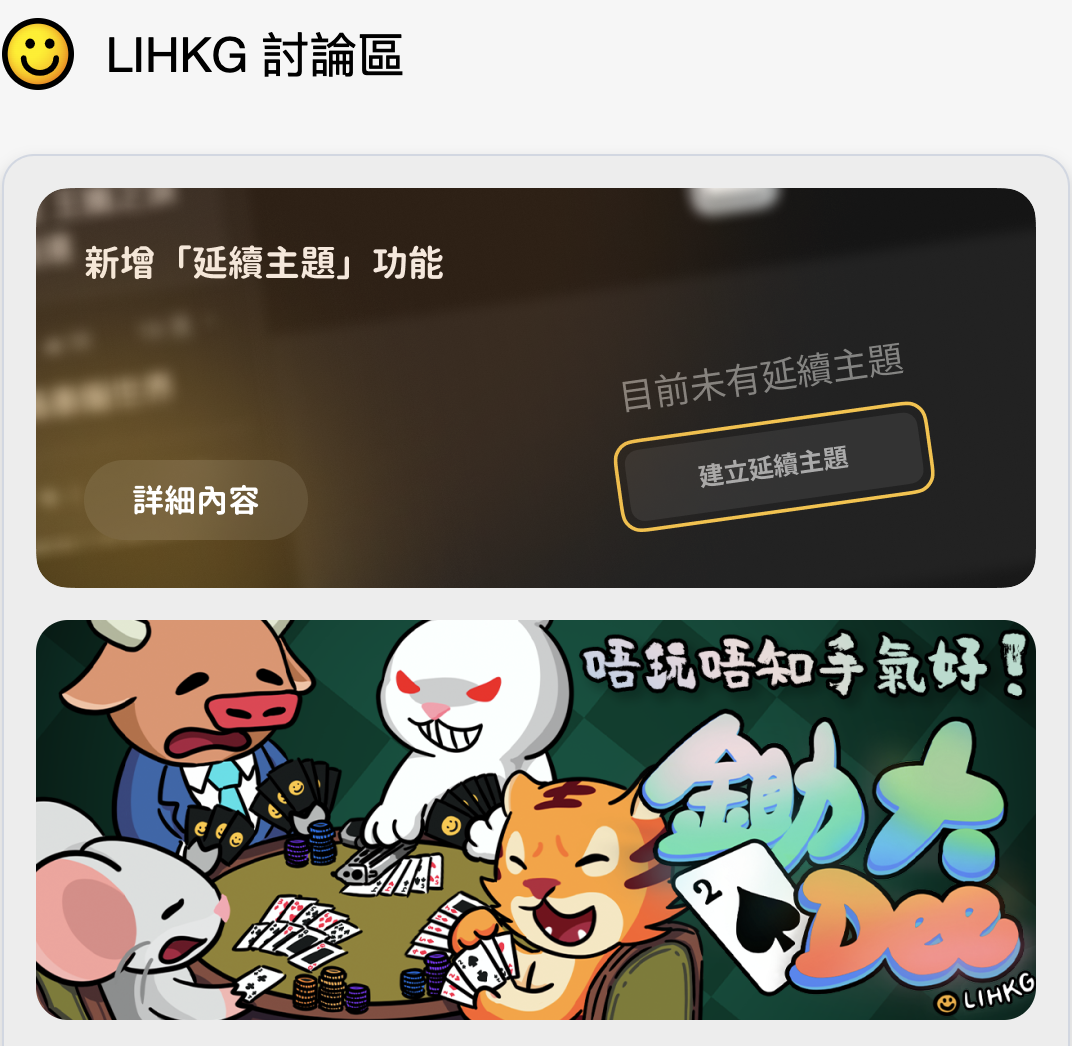
Es ist eines der größten Foren für Diskussionen über Proteste, soziale Unruhen und vieles mehr.
Diese Social-Media-Plattform, die in Wettbewerbsanalysen oft mit Reddit verglichen wird, ermöglicht es den Nutzern, eine breite Palette von Themen zu diskutieren – von Politik und aktuellen Ereignissen bis hin zu Unterhaltung und Lifestyle.
Die Geschichte des Forums zeigt einen starken Fokus auf kollektives Handeln und groß angelegte Proteste.
Mit seinen nutzergenerierten Social-Media-Inhalten und Online-Diskussionen in Echtzeit dient lihkg.com als wertvolle Ressource für Forscher, Marketingfachleute und Datenanalysten, die daran interessiert sind, die öffentliche Meinung, soziale Netzwerke und gesellschaftliche Trends zu verstehen.
Die Komplexität des Webscrapings auf lihkg.com
Auch wenn die Idee, Daten von lihkg.com zu scrapen, auf den ersten Blick einfach erscheinen mag, sieht die Realität ganz anders aus.
Die Website nutzt eine Vielzahl von Mechanismen zum Schutz ihres gut strukturierten Datensatzes, die von CAPTCHAs bis hin zu AJAX-Anfragen reichen, was sie zu einem anspruchsvollen Ziel für Web-Scraping und Netzwerke zur Erkennung von Unruhen macht.
Darüber hinaus sorgen ethische und rechtliche Überlegungen, einschließlich der Ethik der Solidarität, für eine weitere Ebene der Komplexität in diesem Prozess.
Das Verständnis dieser Feinheiten ist entscheidend für jeden, der erwägt, diese oder ähnliche Online-Plattformen zu scrapen.
Es geht nicht nur darum, Social-Media-Daten zu sammeln, sondern darum, dies verantwortungsbewusst und effektiv zu tun.
Hypothetische Tools: Geonode
Proxys und Scraper API
In einem hypothetischen Szenario, in dem man lihkg.com scrapen würde, könnten bestimmte Tools den Prozess potenziell vereinfachen.
[Geonode
](https://geonode.com) Proxys könnten genutzt werden, um IP-basierte Einschränkungen zu umgehen, was eine umfangreichere Datenerfassung ermöglicht, ohne Anti-Scraping-Maßnahmen auszulösen. Dies ist besonders nützlich für den Umgang mit Aktivitätskaskaden.
Zudem könnte [Geonode
s „scraper API
“](https://geonode.com/the-pay-as-you-go-scraper) den Scraping-Prozess automatisieren und vereinfachen und Herausforderungen wie CAPTCHAs und AJAX-Anfragen effizienter bewältigen.
Dies wäre in Echtzeit von Vorteil, insbesondere wenn ein hohes Maß an Solidarität unter den Forennutzern herrscht.
Wer sollte diesen Artikel lesen?
Wenn du dich schon einmal gefragt hast, wie man lihkg.com scrapt, ist dieses Gedankenexperiment genau das Richtige für dich.
Dieser Artikel soll Licht auf die Komplexitäten und Herausforderungen werfen, denen Sie beim Scraping von lihkg.com begegnen würden – ohne Ihnen dabei konkret beizubringen, wie es geht.
Lassen Sie uns also einen Blick auf dieses faszinierende Thema werfen und erkunden, was es so herausfordernd und zugleich so spannend macht.
Die Feinheiten von lihkg.com
Der Aufbau von lihkg.com
lihkg.com basiert in erster Linie auf einer Kombination aus HTML, CSS und JavaScript.
Während HTML und CSS für das Layout und die Gestaltung zuständig sind, ist JavaScript für die dynamischen Aspekte der Website verantwortlich, wie beispielsweise Echtzeit-Aktualisierungen und AJAX-Anfragen.
Warum die Struktur für das Scraping wichtig ist
Das Verständnis der Struktur ist der erste Schritt, um herauszufinden, wie man lihkg.com scrapt.
Wenn die Website beispielsweise stark auf JavaScript angewiesen ist, um Inhalte zu laden, funktionieren herkömmliche Scraping-Methoden, die nur den HTML-Code abrufen, möglicherweise nicht.
Man müsste fortgeschrittenere Techniken wie Headless-Browser einsetzen, um den JavaScript-Code auszuführen und die Daten abzurufen.
Herausforderungen beim Scraping dynamischer Inhalte
lihkg.com nutzt AJAX (Asynchronous JavaScript and XML), um neue Daten zu laden, ohne die gesamte Seite neu zu laden.
Dies erschwert das Scraping der Website mit einfachen HTTP-Anfragen.
In einem hypothetischen Szenario könnte man „scraper API“ von Geonode nutzen, um solche dynamischen Inhalte effizienter zu verarbeiten.
Datentypen auf lihkg.com
Was können Sie finden?
lihkg.com bietet eine Vielzahl von Inhaltstypen, die für verschiedene Interessengruppen von Interesse sein könnten. Hier sind einige der wichtigsten Datentypen, die Sie für das Scraping in Betracht ziehen könnten:
-
Benutzerbeiträge. Originelle Beiträge von Benutzern zu verschiedenen Themen, die als Ausgangspunkt für Diskussionen dienen und Text, Bilder sowie Links enthalten können.
-
Kommentare: Kommentare sind Antworten auf Nutzerbeiträge und können verschachtelte Antworten enthalten, wodurch eine threadartige Struktur entsteht.
-
Upvotes und Downvotes. Jeder Beitrag und jeder Kommentar kann positiv oder negativ bewertet werden, was Aufschluss über die Stimmung der Community gegenüber dem Inhalt gibt.
-
Nutzerprofile. Diese können Informationen wie das Beitrittsdatum des Nutzers, den Aktivitätsgrad und andere Statistiken enthalten, wobei ein Großteil dieser Daten oft anonymisiert oder pseudonymisiert ist.
Warum diese Daten wichtig sind
Marktforschung
Zu verstehen, worüber Nutzer sprechen, kann wertvolle Einblicke in das Verbraucherverhalten und aktuelle Trends liefern. Dies ist besonders nützlich für die Wettbewerbsanalyse und die Visualisierungsanalyse.
Stimmungsanalyse
Anhand der Upvotes und Downvotes lässt sich die öffentliche Meinung zu bestimmten Themen oder Ereignissen einschätzen, darunter Protestkampagnen und soziale Unruhen.
Wissenschaftliche Forschung
Wissenschaftler, die sich mit Online-Communities befassen, können die Nutzerinteraktionen und Diskussionen auf lihkg.com als reichhaltige Datenquelle für ihre gut strukturierten Datensätze nutzen.
Herausforderungen beim Web-Scraping
Das Scraping einer Website wie lihkg.com ist nicht nur eine technische Herausforderung, sondern auch ein rechtliches und ethisches Labyrinth.
Die rechtliche Lage
Web-Scraping bewegt sich in einer gewissen rechtlichen Grauzone.
Zwar gilt das Scraping öffentlich zugänglicher Beiträge im Allgemeinen als legal, doch viele Websites haben Nutzungsbedingungen, die das Scraping verbieten.
Ein Verstoß gegen diese Bedingungen kann rechtliche Konsequenzen nach sich ziehen, darunter Klagen und Geldstrafen.
Wie sich dies auf lihkg.com auswirkt
lihkg.com verfügt über eigene Nutzungsbedingungen, denen Nutzer bei der Nutzung der Website zustimmen müssen.
Diese Bedingungen enthalten häufig Klauseln, die das unbefugte Scraping der Inhalte der Website verbieten.
Daher könnte das Scraping von lihkg.com ohne ausdrückliche Genehmigung möglicherweise rechtliche Konsequenzen nach sich ziehen.
Ethische Implikationen
Über die rechtlichen Aspekte hinaus wirft das Scraping von lihkg.com auch ethische Fragen auf.
Die Plattform ist eine Community, in der Menschen ihre Gedanken und Meinungen austauschen und oft ein gewisses Maß an Privatsphäre erwarten.
Das Scraping dieser Daten ohne Zustimmung könnte als Verletzung der Privatsphäre angesehen werden, selbst wenn die Daten öffentlich zugänglich sind.
Technische Hindernisse
CAPTCHAs
Eine der gängigsten Anti-Scraping-Maßnahmen, die von Websites eingesetzt werden, ist das CAPTCHA (Completely Automated Public Turing test to tell Computers and Humans Apart).
lihkg.com nutzt CAPTCHAs, um sicherzustellen, dass der Nutzer, der mit der Website interagiert, ein Mensch und kein Bot ist. Dies stellt eine erhebliche Hürde für jegliche Scraping-Versuche dar.
AJAX-Anfragen
Wie bereits erwähnt, nutzt lihkg.com AJAX (Asynchronous JavaScript and XML), um Inhalte dynamisch zu laden.
Das bedeutet, dass die Daten, die Sie auf der Website sehen, nicht im ursprünglichen HTML-Code enthalten sind, sondern asynchron über JavaScript geladen werden.
Herkömmliche Scraping-Methoden, die lediglich den HTML-Code abrufen, können diese dynamisch geladenen Daten nicht erfassen.
IP-basierte Beschränkungen
Websites setzen häufig IP-basierte Beschränkungen ein, um den Zugriff aus bestimmten geografischen Regionen zu blockieren oder einzuschränken oder um Scraping-Aktivitäten zu verhindern.
Mehrere Anfragen von derselben IP-Adresse innerhalb kurzer Zeit können diese Beschränkungen auslösen.
Hypothetische Werkzeuge für diese Aufgabe
Geonode-Proxys als hypothetische Lösung
In einem hypothetischen Szenario, in dem man versuchen würde, lihkg.com zu scrapen, könnten Geonode-Proxys als Lösung dienen, um IP-basierte Einschränkungen zu umgehen.
Indem Sie Ihre Anfragen über mehrere IP-Adressen leiten, könnten Sie vermeiden, Anti-Scraping-Maßnahmen auszulösen, und somit eine umfangreichere Datenerfassung ermöglichen.
Die Rolle von Proxys
Beim Web-Scraping fungiert ein Proxy als Vermittler zwischen Ihrem Computer und der Website, die Sie scrapen möchten.
Er leitet Ihre Anfragen an die Website weiter und sendet die Antworten der Website an Sie zurück, wobei Ihre IP-Adresse dabei effektiv verborgen bleibt.
Geonode-Proxys für geografische Beschränkungen
Geonode bietet eine Reihe von Residential-Proxys an, mit denen sich geografische Beschränkungen umgehen lassen.
Wenn beispielsweise lihkg.com den Zugriff für Nutzer aus bestimmten Ländern einschränken würde, könnten die Proxys von Geonode Ihre Anfragen über IP-Adressen in Regionen leiten, die nicht eingeschränkt sind, und Ihnen so den Zugriff auf die Website ermöglichen.
Überwindung von Ratenbeschränkungen mit Proxys von Geonode
Ratenbegrenzung ist eine weitere gängige Anti-Scraping-Maßnahme, die die Anzahl der Anfragen begrenzt, die eine einzelne IP-Adresse innerhalb eines bestimmten Zeitraums stellen kann.
Proxys von Geonode können Ihnen dabei helfen, dieses Problem zu umgehen, indem sie Ihre Anfragen auf mehrere IP-Adressen verteilen, wodurch die Wahrscheinlichkeit sinkt, dass Sie an Ratenbegrenzungen stoßen.
Der „Scraper API“
Ein „scraper API“ ist ein Tool, das den Web-Scraping-Prozess vereinfacht, indem es viele der damit verbundenen Herausforderungen wie CAPTCHAs, AJAX-Anfragen und Ratenbegrenzungen übernimmt.
Es fungiert im Wesentlichen als Vermittler, der sich um die technischen Details kümmert, sodass Sie sich darauf konzentrieren können, was Sie mit den Daten tun, sobald diese gescrapt wurden.
Wie „Scraper API“ von Geonode den Prozess vereinfachen könnte
„scraper API“ von Geonode wurde entwickelt, um viele der Herausforderungen zu bewältigen, denen Sie beim Scraping einer komplexen Website wie lihkg.com begegnen würden. Es kann im Falle von Fehlern Wiederholungsversuche durchführen, wodurch der gesamte Prozess effizienter und weniger fehleranfällig wird.
Den Ansatz neu überdenken
„scraper API“ von Geonode regt dazu an, die Vorgehensweise beim Scraping von lihkg.com zu überdenken.
Anstatt unzählige Stunden damit zu verbringen, herauszufinden, wie man CAPTCHAs umgeht oder AJAX-Anfragen verarbeitet, könnten Sie die API nutzen, um diese Herausforderungen zu bewältigen. So können Sie sich auf die Analyse der Daten und die Ableitung von Erkenntnissen konzentrieren.
Häufig gestellte Fragen
Was ist lihkg.com?
lihkg.com ist ein beliebtes Forum in Hongkong und unter kantonesischsprachigen Nutzern weltweit, das Themen von Politik bis Popkultur abdeckt.
Es wird oft mit Reddit verglichen und ist eine wichtige Quelle, um die öffentliche Stimmung und Trends zu verfolgen, darunter auch Nachrichtenwerte und alternative Nachrichten.
Ist das Scraping von Websites legal?
Die Rechtmäßigkeit des Web-Scrapings hängt von der jeweiligen Rechtsordnung und den konkreten Umständen ab.
Im Allgemeinen gilt das Scraping öffentlich zugänglicher Informationen als legal. Viele Websites, darunter auch lihkg.com, haben jedoch Nutzungsbedingungen, die unbefugtes Scraping verbieten.
Ein Verstoß gegen diese Bedingungen kann rechtliche Konsequenzen nach sich ziehen.
Wie funktionieren Proxys beim Web-Scraping?
Beim Web-Scraping dient ein Proxy als Vermittler zwischen Ihrem Computer und der Zielwebsite. Er leitet Ihre Anfragen an die Website weiter und sendet die Antworten der Website an Sie zurück.
Dieser Vorgang verschleiert Ihre IP-Adresse effektiv, sodass es für Websites schwieriger wird, Sie zu identifizieren und zu blockieren.
Was ist ein „Scraper API“?
Ein „scraper API“ ist ein Dienst, der den Web-Scraping-Prozess vereinfacht, indem er viele der damit verbundenen Herausforderungen übernimmt.
Der Dienst „scraper API“ von Geonode könnte diese Aspekte theoretisch für Sie übernehmen, sodass Sie sich auf die Daten und deren geplante Verwendung konzentrieren können.
Fazit
Am Ende dieses Gedankenexperiments wird deutlich, dass das Scraping von lihkg.com – oder jeder anderen Website – keine einfache Aufgabe ist.
Der Prozess ist mit zahlreichen Komplexitäten verbunden, die vom Verständnis der Website-Struktur bis hin zur Bewältigung rechtlicher und ethischer Herausforderungen reichen.
Das Scraping von lihkg.com bringt eine Reihe einzigartiger Herausforderungen mit sich:
-
Technische Hürden. Die Verwendung von AJAX zum dynamischen Laden von Inhalten und von CAPTCHAs zur Abwehr von Bots macht das Scraping komplizierter als das einfache Abrufen von HTML-Inhalten.
-
Rechtliche und ethische Bedenken. Die Nutzungsbedingungen von lihkg.com verbieten ausdrücklich unbefugtes Scraping, und es gibt ethische Überlegungen hinsichtlich der Privatsphäre der Nutzer und der Datennutzung.
-
Datentypen. Das Verständnis der auf lihkg.com verfügbaren Datentypen, wie Nutzerbeiträge, Kommentare und Upvotes, erhöht die Komplexität des Scraping-Prozesses zusätzlich.
Abschließende Gedanken
Das Verständnis der Komplexitäten, die mit dem Scraping einer Website wie lihkg.com verbunden sind, ist für jeden entscheidend, der ein solches Vorhaben in Betracht zieht.
Zwar gibt es Tools, die die Aufgabe hypothetisch vereinfachen könnten, doch können sie die rechtlichen und ethischen Verantwortlichkeiten, die mit dem Web-Scraping einhergehen, nicht beseitigen.
Daher ist es unerlässlich, die Aufgabe mit einem umfassenden Verständnis dieser Komplexitäten und Herausforderungen anzugehen.
Wir hoffen, dass dieses Gedankenexperiment durch die detaillierte Untersuchung dieser Aspekte wertvolle Einblicke in die Welt des Web-Scrapings geliefert hat.
Das Bewusstsein für diese Herausforderungen wird Sie besser darauf vorbereiten, sich verantwortungsbewusst und effektiv in der komplexen Landschaft des Web-Scrapings zurechtzufinden.

