Reddit, oft als „Titelseite des Internets“ bezeichnet, ist eine riesige Plattform für nutzergenerierte Inhalte.
Mit 430 Millionen aktiven Nutzern pro Monat, die an Tausenden themenspezifischen Diskussionen teilnehmen – von den neuesten Tech-Trends bis hin zu Nischenhobbys –, ist Reddit ein wertvolles Werkzeug und eine wahre Goldgrube an Daten, die nur darauf warten, erschlossen zu werden.
Doch wie lassen sich diese Daten effizient und ethisch einwandfrei extrahieren?
In diesem Leitfaden beschäftigen wir uns eingehend mit Reddit-Scrapern, der offiziellen API, Tools, Techniken und Best Practices, um Reddit-Daten effektiv zu erfassen.
Die Bedeutung des Reddit-Scrapings
Datengestützte Erkenntnisse sind der Schlüssel zum Erfolg.
Das Extrahieren von Daten aus Reddit ermöglicht es Unternehmen, Forschern und Datenbegeisterten, die öffentliche Stimmung zu erfassen, Markttrends zu verfolgen und nutzergenerierte Inhalte zu sammeln.
Diese umfangreichen, unstrukturierten Daten bieten vielfältige Anwendungsmöglichkeiten, wie zum Beispiel:
-
Marktforschung. Die vielfältigen Communities auf Reddit, sogenannte „Subreddits“, decken nahezu jedes erdenkliche Interesse ab. Unternehmen scrapen Reddit-Beiträge, um die Stimmung der Verbraucher, ihre Vorlieben und aufkommende Trends in Echtzeit zu erfassen.
-
Produktfeedback. Nutzer diskutieren häufig über Produkte und Dienstleistungen und geben dabei offenes Feedback. Diese unschätzbaren Daten helfen Unternehmen dabei, ihre Angebote zu optimieren und auf Bedenken einzugehen.
-
Wettbewerbsanalyse. Durch die Beobachtung von Diskussionen über Wettbewerber können Unternehmen Stärken, Schwächen und Chancen auf dem Markt identifizieren.
-
Ideen für Inhalte. Content-Ersteller und Marketingfachleute nutzen Reddit, um beliebte Beiträge und Trendthemen zu entdecken und so sicherzustellen, dass ihre Inhalte relevant und ansprechend bleiben.
-
Wissenschaftliche Forschung. Forscher greifen auf den riesigen Datenpool von Reddit zurück, um Online-Verhalten, kulturelle Trends und soziale Dynamiken zu untersuchen.
-
Krisenmanagement. Marken können potenzielle PR-Krisen frühzeitig erkennen, indem sie negative Stimmungen oder Kontroversen auf Reddit beobachten.
-
Datensätze für das Training. Für Fachleute aus den Bereichen KI und maschinelles Lernen bietet Reddit umfangreiche Datensätze zum Trainieren von Modellen, insbesondere im Bereich der natürlichen Sprachverarbeitung.
Die Struktur von Reddit verstehen – für effektives Web-Scraping
Reddit ist eine komplexe Plattform mit einer einzigartigen Struktur, die sie von anderen Social-Media-Plattformen unterscheidet.
Das Verständnis dieser Struktur ist für jeden, der Daten von Reddit scrapen möchte, von entscheidender Bedeutung, da es die Extraktion relevanter und umfassender Informationen gewährleistet.
Hier eine detaillierte Betrachtung:
-
Subreddits. Dabei handelt es sich um gemeinschaftsorientierte Bereiche, die bestimmten Themen oder Interessen gewidmet sind.
Jeder Subreddit hat eine eigene URL, die oft als „r/[Subreddit-Name]“ bezeichnet wird.
Beispielsweise gibt es „Deals-Subreddits“, die sich auf Werbeaktionen und Rabatte konzentrieren.
Die Kenntnis der Struktur von Subreddit-URLs ist unerlässlich, um bestimmte Communities gezielt anzusprechen.
-
Beiträge. Nutzer können innerhalb von Subreddits Beiträge veröffentlichen. Diese reichen von ausführlichen Blogbeiträgen bis hin zu Bildern, Videos oder Links zu externen Websites.
Jeder Beitrag hat eine eigene Struktur, die oft als „Beitragswörterbuch“ bezeichnet wird und Details wie den Autor des Beitrags, den Titel sowie den aktuellen Inhalt enthält.
-
Kommentare. Jeder einzelne Beitrag kann Kommentare enthalten, was zu verschachtelten Diskussionen führt.
Das Verständnis der durchschnittlichen Anzahl von Kommentaren pro Beitrag oder die gezielte Ausrichtung auf Beiträge mit vielen Kommentaren kann reichhaltigere Daten für die Analyse liefern.
-
Nutzerprofile und App-Nutzer. Jeder Reddit-Nutzer, egal ob er die Reddit-App oder den Browser nutzt, verfügt über ein Profil, in dem seine Aktivitäten, einschließlich Beiträge und Kommentare, angezeigt werden.
Dies ist eine wahre Fundgrube an Daten, insbesondere für die Analyse des Nutzerverhaltens.
-
Digitale Produkte und App-Käufe. Reddit bietet verschiedene Vertriebsoptionen für digitale Produkte an, darunter Auszeichnungen und Reddit Premium.
Ein Verständnis dafür, wie Nutzer mit diesen interagieren – insbesondere durch App-Käufe –, kann Einblicke in das Ausgabeverhalten der Nutzer liefern.
-
App-Werbung. Reddit bietet Werbemöglichkeiten, mit denen Marken bestimmte demografische Zielgruppen oder Subreddit-Communities erreichen können.
Dies ist ein unverzichtbares Instrument für Unternehmen, die auf der Plattform werben möchten.
-
Browser-Interaktionen. Ganz gleich, ob Nutzer über eine Browsersitzung auf Reddit zugreifen oder Browser-Erweiterungen verwenden – jede Interaktion hinterlässt Daten.
Das Wissen darüber, wie man Browser-Interaktionen und Browser-Profile auswertet, kann tiefere Einblicke in das Nutzerverhalten liefern.
-
Cloud und Bereitstellung. Reddit nutzt Cloud-Dienstlösungen, und das Verständnis dieser Zusammenhänge kann entscheidend sein, insbesondere wenn die Cloud bei der Bereitstellung berücksichtigt wird.
-
Analyse und Tools. Mit den richtigen Analysetools können Unternehmen entschlüsseln, wie ein Thema in Dutzenden von Communities ankommt oder wie Nutzer mit dem „Upvote“-Button oder dem „Upvote“-Element interagieren.
-
Automatisierung und KI. Moderne Social-Media-Scraper sind mit Automatisierungsfunktionen ausgestattet. Einige nutzen sogar generative KI-Tools, um das Nutzerverhalten vorherzusagen oder Inhalte zu generieren.
-
Ethische Überlegungen. Beim Scraping ist es unerlässlich, die jeweiligen Eigentümer der Inhalte zu respektieren und sicherzustellen, dass aussagekräftige User-Agents verwendet werden, um Falschdarstellungen zu vermeiden.
Streben Sie stets die korrekte Ziel-URL an, um die benötigten Informationen zu extrahieren, ohne die Rechte der Nutzer zu verletzen.
- Weitere Elemente. Reddit ist riesig, und es gibt weitere Elemente wie das Subreddit-Verzeichnis, Beschreibungsfelder und mehr, die für detailliertere Daten ins Visier genommen werden können.
Die facettenreiche Struktur von Reddit ist ein Spielfeld für Web-Scraper. Um aussagekräftige Daten zu extrahieren, muss man ihre Feinheiten verstehen.
Ganz gleich, ob Sie Kommentare aus Subreddits analysieren, Codezeilen auf Muster untersuchen oder erforschen, wie Produkte vermarktet werden – die Kenntnis der Reddit-Struktur stellt sicher, dass Ihre Scraping-Bemühungen sowohl effizient als auch ethisch einwandfrei sind.
Scraper-Tool 1: Die offizielle Reddit-API
Manche Menschen betrachten Reddit lediglich als eine weitere Social-Media-Plattform. Doch seine einzigartige Struktur und sein demokratisches Abstimmungssystem machen es zu viel mehr.
Reddit lebt von nutzergenerierten Inhalten, die in Nischen-Communities, den sogenannten „Subreddits“, unterteilt sind.
Jeder Subreddit befasst sich mit einem bestimmten Thema und ermöglicht es den Nutzern, Diskussionen zu führen, Ressourcen zu teilen und Rat einzuholen.
Die Inhalte mit den meisten Upvotes – also die beliebtesten Beiträge – rücken ganz nach oben und machen Reddit so zu einem Echtzeit-Spiegel des öffentlichen Interesses und der öffentlichen Stimmung.
Überblick und Begriffe zur Reddit-API
Die offizielle DATA-API von Reddit ist ein leistungsstarkes Tool, das strukturierten Zugriff auf die umfangreichen Inhalte der Plattform bietet.
Sie ist ein unverzichtbares Werkzeug für Entwickler, Forscher und Unternehmen, die die umfangreichen Erkenntnisse nutzen möchten, die auf der Plattform verfügbar sind.
Die API ermöglicht es Drittentwicklern, Kommentare auszulesen, Nutzerinformationen abzurufen, auf Subreddit-Details zuzugreifen und vieles mehr – und zwar auf eine Weise, die sowohl effizient ist als auch den Richtlinien von Reddit entspricht.
Nutzungsrichtlinien, Einschränkungen und Beschränkungen
- Registrierung und Teilnahmeberechtigung. Vor dem Zugriff auf die Data API müssen sich Nutzer registrieren und sicherstellen, dass sie die Teilnahmebedingungen erfüllen. Dazu gehört, dass sie volljährig sind und ihnen die Nutzung der API nicht durch geltende Gesetze untersagt ist.
- Lizenz. Reddit gewährt eine nicht-exklusive, nicht übertragbare und widerrufbare Lizenz für den Zugriff auf und die Nutzung der Daten-API. Das bedeutet, dass Nutzer ihre API-Zugriffsrechte nicht unterlizenzieren oder an Dritte übertragen dürfen.
- Nutzerinhalte. Obwohl die Inhalte auf Reddit von Nutzern erstellt werden, bietet die API eine Möglichkeit, auf diese Inhalte zuzugreifen, ohne sie zu verändern. Bei jeder Nutzung von Nutzerinhalten müssen die Rechte der ursprünglichen Urheber gewahrt werden.
- Datenschutz und Datenverarbeitung. Entwickler müssen offenlegen, wie sie mit den über die API erfassten Daten umgehen, um Transparenz und die Einhaltung der Datenschutzgesetze zu gewährleisten.
- API-Beschränkungen. Reddit kann Beschränkungen für die API-Nutzung festlegen, beispielsweise die Anzahl der Anfragen pro Stunde. Es ist entscheidend, diese Beschränkungen zu kennen und einzuhalten, um Störungen zu vermeiden.
- Gebühren und kommerzielle Nutzung. Während die API für die grundlegende Nutzung in der Regel kostenlos ist, behält sich Reddit das Recht vor, bei höherem Nutzungsaufkommen oder bei kommerzieller Nutzung Gebühren zu erheben.
- Einhaltung der Bestimmungen. Nutzer der API müssen die Nutzungsbedingungen, die Datenschutzerklärung und alle anderen relevanten Bestimmungen von Reddit einhalten. Dadurch wird sichergestellt, dass der Datenzugriff ethisch einwandfrei bleibt und den Community-Standards von Reddit entspricht.
Das Verständnis und die Einhaltung dieser Bedingungen sind für jeden entscheidend, der die Daten von Reddit in seinen Anwendungen oder Forschungsarbeiten nutzen möchte. Dies gewährleistet einen reibungslosen, unterbrechungsfreien Datenzugriff und wahrt gleichzeitig die Integrität und die Grundwerte der Reddit-Community.
Scraper-Tool 2: Python und Selenium
Python ist eine weit verbreitete Programmiersprache, die für ihre Einfachheit und Vielseitigkeit bekannt ist.
Python bietet eine Vielzahl von Bibliotheken und Frameworks, die das Scraping vereinfachen. Ein solches Tool ist Selenium, das ursprünglich für Webtests entwickelt wurde, sich aber mittlerweile zu einer ersten Wahl für Web-Scraping-Aufgaben entwickelt hat.
Selenium automatisiert die Bedienung von Webbrowsern. Es kann menschenähnliches Surfverhalten simulieren und ermöglicht so das Scrapen von Webseiten, als würde ein echter Nutzer darauf navigieren.
In Kombination mit Python ermöglicht Selenium Entwicklern, Skripte zu schreiben, die Aufgaben wie das Einloggen in Konten, das Aufrufen bestimmter Seiten, das Anklicken von Schaltflächen und – was am wichtigsten ist – das Extrahieren von Daten ausführen können.
Für Plattformen wie Reddit, die reich an dynamischen Inhalten sind (Inhalte, die geladen oder geändert werden, ohne dass die Seite aktualisiert wird), erweist sich Selenium als unschätzbar wertvoll.
Herkömmliche Scraping-Tools könnten mit solchen Inhalten Schwierigkeiten haben, doch Selenium als Browser-Automatisierungstool kann problemlos darauf zugreifen.
Vorteile der Verwendung von Python und Selenium für das Reddit-Scraping
- Zugriff auf dynamische Inhalte. Wie bereits erwähnt, kann Selenium mit dynamischen Inhalten interagieren und so sicherstellen, dass beim Scraping keine Daten übersehen werden.
- Menschähnliche Interaktionen. Die Fähigkeit von Selenium, menschliche Interaktionen wie Scrollen oder Klicken nachzuahmen, kann dabei helfen, einige Anti-Scraping-Maßnahmen zu umgehen.
- Flexibilität. Die umfangreichen Bibliotheken von Python und die Browser-Automatisierungsfunktionen von Selenium bilden eine flexible Kombination. Ob es um den Umgang mit Cookies, die Verwaltung von Sitzungen oder den Umgang mit Pop-ups geht – Python und Selenium können all das bewältigen.
- Umfassende Browserunterstützung. Selenium unterstützt mehrere Browser, darunter Chrome, Firefox und Safari, und ermöglicht so bei Bedarf browserübergreifendes Scraping.
Mögliche Herausforderungen
- Leistung. Da Selenium einen echten Browser automatisiert, kann es langsamer sein als andere leichtgewichtige Scraping-Tools, die den Quellcode der Seite direkt abrufen.
- Komplexität. Die Einrichtung eines Selenium-basierten Scrapers kann komplexer sein als die Verwendung einfacher, auf HTTP-Anfragen basierender Tools, insbesondere für Anfänger.
- Anti-Scraping-Maßnahmen. Zwar kann Selenium einige Anti-Scraping-Techniken umgehen, doch Plattformen wie Reddit entwickeln ihre Abwehrmaßnahmen ständig weiter. Das bedeutet, dass Scraper mit Herausforderungen wie CAPTCHAs, Ratenbeschränkungen oder vorübergehenden IP-Sperren konfrontiert werden können.
- Wartung. Webseiten ändern sich im Laufe der Zeit. Sollte Reddit eine Designüberarbeitung vornehmen oder seine Struktur ändern, könnte der Scraper nicht mehr funktionieren und Aktualisierungen erfordern.
Scraper-Tool 3: PRAW (Python Reddit API Wrapper)
PRAW, kurz für „Python Reddit API Wrapper“, ist im Wesentlichen eine Brücke zwischen Python-Anwendungen und der Reddit-API.
Anstatt sich mit rohen HTTP-Anfragen zu befassen und komplexe JSON-Antworten zu analysieren, können Entwickler die intuitiven Methoden von PRAW nutzen, um Reddit-Daten abzurufen und mit ihnen zu interagieren.
Vorteile der Verwendung von PRAW
-
Einfachheit. PRAW abstrahiert die Komplexität der Reddit-API und bietet Entwicklern unkomplizierte Methoden für den Zugriff auf Daten.
So lassen sich beispielsweise die beliebtesten Beiträge aus einem Subreddit abrufen oder Kommentare aus einem bestimmten Thread auslesen – und das mit nur wenigen Zeilen Code.
-
Umgang mit Ratenbeschränkungen. Reddit legt Beschränkungen fest, wie oft auf seine API zugegriffen werden darf.
PRAW verwaltet diese Ratenbegrenzungen automatisch und stellt sicher, dass Ihre Anwendung diese nicht überschreitet und somit keine vorübergehenden Sperren riskiert.
-
Einhaltung der Nutzungsbedingungen. Durch die Verwendung von PRAW halten sich Entwickler automatisch an die Nutzungsbedingungen der Reddit-API, wodurch das Risiko von Problemen beim Datenzugriff minimiert wird.
-
Umfangreiche Dokumentation. PRAW verfügt über eine umfassende Dokumentation, die sowohl Anfängern als auch erfahrenen Entwicklern den Einstieg und die Fehlerbehebung erleichtert.
-
Aktive Community. PRAW verfügt über eine aktive Community. Das bedeutet regelmäßige Updates, eine Fülle von Online-Ressourcen und Unterstützung durch die Community bei allen auftretenden Herausforderungen.
Grundlegende Einrichtung und Anwendungsbeispiele
Einrichtung
-
Bevor Sie PRAW verwenden, registrieren Sie eine Skript-Anwendung auf dem Entwicklerportal von Reddit, um die erforderlichen API-Zugangsdaten zu erhalten.
-
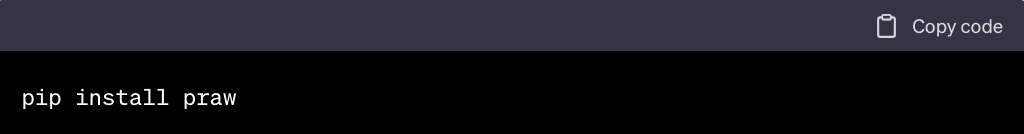
Installieren Sie PRAW über pip.
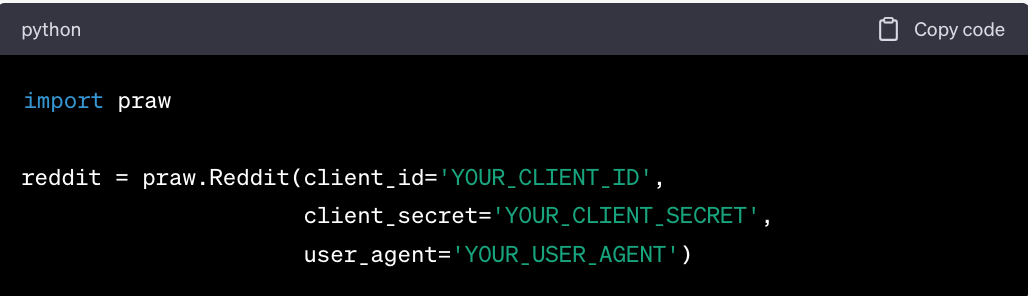
- Initialisieren Sie die Reddit-Instanz mit Ihren API-Zugangsdaten.
Anwendungsbeispiele
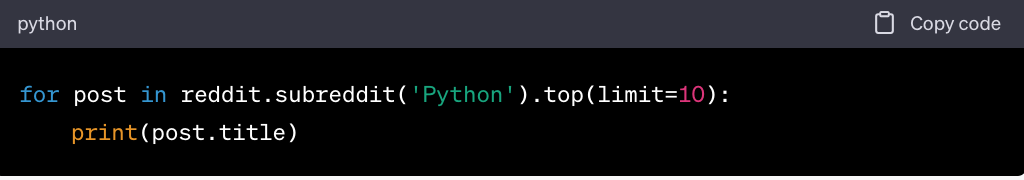
- Die 10 beliebtesten Beiträge eines Subreddits extrahieren
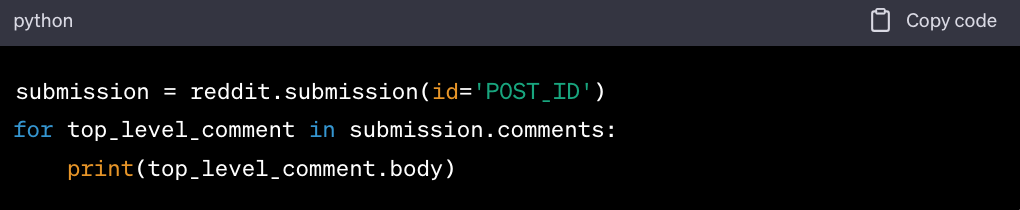
- Kommentare aus einem bestimmten Thread abrufen
- Suche nach Beiträgen, die ein bestimmtes Schlüsselwort enthalten
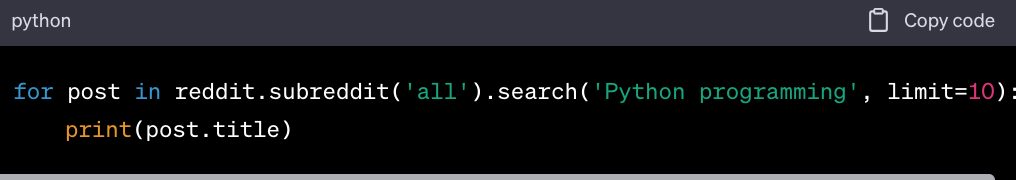
PRAW ist ein unverzichtbares Tool für alle, die sich mit Python intensiv mit Reddit-Daten beschäftigen möchten. Seine Einfachheit in Verbindung mit seiner Leistungsfähigkeit macht es zur idealen Wahl für Projekte, die von einfachen Datenextraktionsaufgaben bis hin zu komplexen Datenanalysen reichen.
Scraper-Tool 4: Das Scrapy-Framework
Scrapy ist ein in Python geschriebenes, hochentwickeltes Open-Source-Framework für Web-Crawling und Web-Scraping. Es ist für eine breite Palette von Scraping-Aufgaben ausgelegt, von einfachen einmaligen Datenextraktionen bis hin zu umfangreichen, komplexen Web-Crawling-Projekten. Scrapy ist nicht nur auf Reddit beschränkt, sondern kann zum Scraping von Daten aus beliebigen Websites verwendet werden.
Wichtigste Funktionen
-
Vielseitigkeit. Scrapy kann Daten mithilfe von CSS-Selektoren, XPath oder sogar regulären Ausdrücken aus Websites extrahieren und ist damit für verschiedene Website-Strukturen geeignet.
-
Middleware und Erweiterungen. Scrapy unterstützt Middleware und Erweiterungen, wodurch Entwickler den Scraping-Prozess anpassen, Wiederholungsversuche und User-Agents verwalten sowie sogar Proxy-Pools integrieren können.
-
Pipelining. Sobald Daten extrahiert wurden, bietet Scrapy Item-Pipelines zur Verarbeitung, Validierung und Speicherung der Daten. Dies kann in Datenbanken, Dateien oder sogar in Cloud-Speichern erfolgen.
-
Paralleles Crawling. Scrapy basiert auf der asynchronen Netzwerkbibliothek „Twisted“, wodurch es mehrere Anfragen gleichzeitig bearbeiten und so den Datenextraktionsprozess beschleunigen kann.
-
Robuste Fehlerbehandlung. Scrapy kann Fehler elegant handhaben und stellt so sicher, dass eine kleine Störung nicht den gesamten Scraping-Prozess zum Stillstand bringt.
-
Integrierte Exporter. Scrapy kann Ergebnisse in verschiedenen Formaten wie JSON, CSV und XML exportieren, ohne dass zusätzliche Plugins oder Tools erforderlich sind.
So richten Sie Scrapy für die Datenextraktion aus Reddit ein und nutzen es
Scrapy einrichten: Schritt-für-Schritt-Anleitung
-
Installiere Scrapy mit pip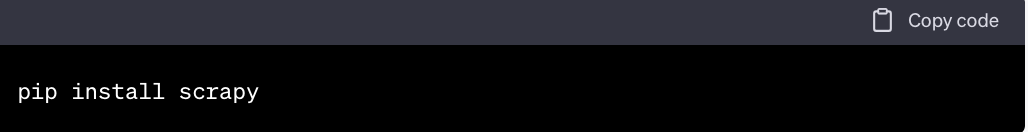
-
Erstelle ein neues Scrapy-Projekt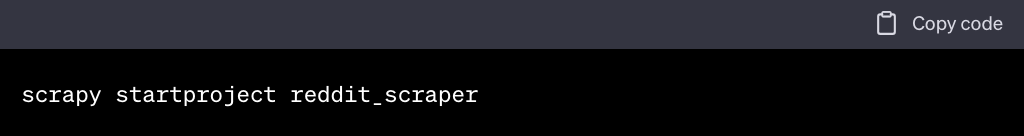
Scrapy für die Datenextraktion aus Reddit nutzen
-
Erstellen Sie einen Spider. Innerhalb Ihres Scrapy-Projekts erstellen Sie Spider – das sind Klassen, die festlegen, wie Links verfolgt und Daten extrahiert werden. Für Reddit könnten Sie beispielsweise einen Spider wie diesen erstellen: 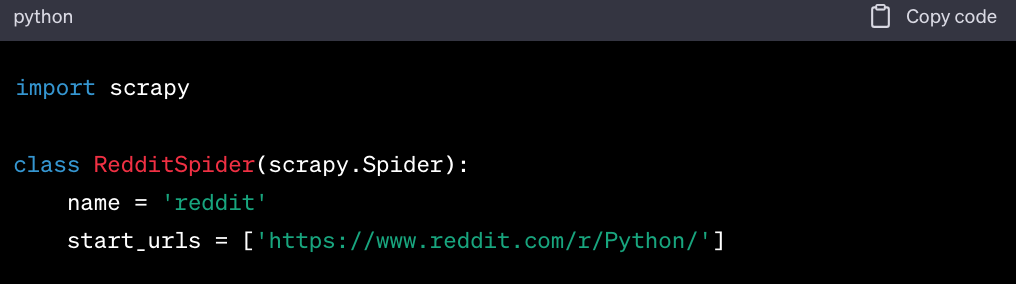
-
Definieren Sie die Extraktionslogik. Verwenden Sie CSS-Selektoren oder XPath, um Daten von der Reddit-Seite zu extrahieren. 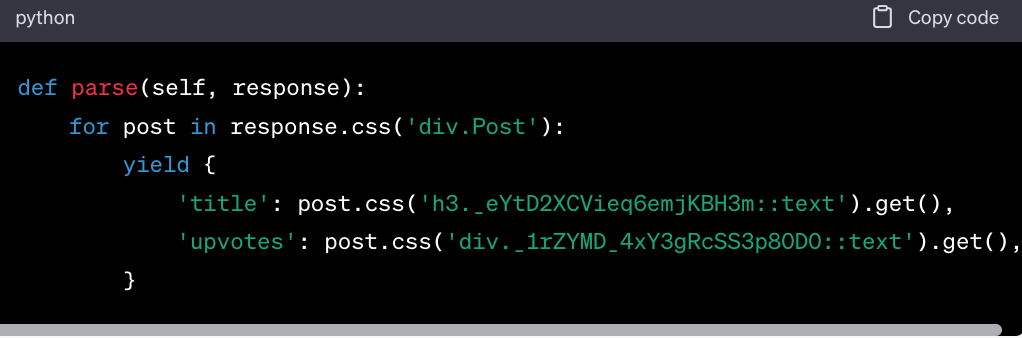
-
Paginierung verfolgen. Reddit verfügt über mehrere Seiten mit Inhalten. Scrapy kann so eingerichtet werden, dass es Links folgt und Daten über verschiedene Seiten hinweg ausliest.
-
Spider ausführen: Sobald Ihr Spider eingerichtet ist, wechseln Sie in das Projektverzeichnis und führen Sie folgenden Befehl aus: 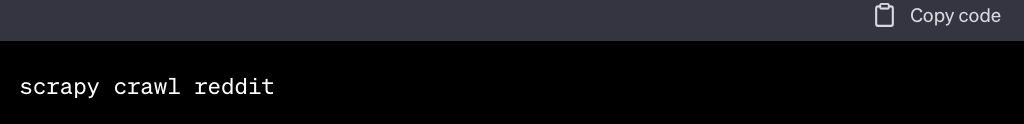
-
Daten speichern: Scrapy kann die gescrapten Daten in verschiedenen Formaten speichern. Um die Daten beispielsweise in einer JSON-Datei zu speichern: 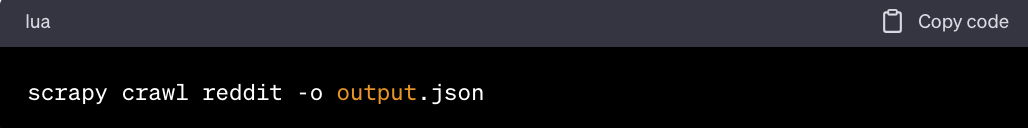
Scraper-Tool 5: GitHub-Repositorys
GitHub, die weltweit führende Plattform für Softwareentwicklung, beherbergt eine Vielzahl von Repositories, die verschiedenen Aufgaben gewidmet sind, darunter auch das Web-Scraping.
Darunter befinden sich zahlreiche Repositories, die sich speziell auf das Scraping von Reddit-Daten konzentrieren.
Diese Repositories bieten oft vorgefertigte Tools, Skripte oder Bibliotheken, die den Reddit-Scraping-Prozess vereinfachen und ihn auch für Personen mit begrenzter Programmiererfahrung zugänglich machen.
Vorteile der Nutzung von GitHub-Repositories für das Reddit-Scraping
-
Gebrauchsfertige Lösungen. Viele GitHub-Repositorys bieten Komplettlösungen, die nur minimale Einrichtung erfordern. Nutzer können das Repository klonen, den bereitgestellten Anweisungen folgen und mit dem Scraping beginnen, ohne ein Tool von Grund auf neu erstellen zu müssen.
-
Unterstützung durch die Community. Beliebte Repositorys verfügen oft über aktive Communities. Nutzer können Probleme melden, um Hilfe bitten oder sogar zum Projekt beitragen und so die Funktionen des Tools erweitern.
-
Kontinuierliche Updates. Angesichts der Dynamik von Websites benötigen Scraping-Tools regelmäßige Updates. Aktive GitHub-Repositorys werden häufig aktualisiert, um Änderungen in der Struktur der Zielwebsite zu berücksichtigen oder die Funktionalität zu verbessern.
-
Vielfältige Ansätze. Verschiedene Repositories nutzen möglicherweise unterschiedliche Techniken oder Tools für das Scraping, von Python-basierten Lösungen wie PRAW oder Scrapy bis hin zu Node.js oder sogar Docker-Anwendungen. Diese Vielfalt ermöglicht es Nutzern, ein Tool auszuwählen, das ihrem technischen Know-how und den Projektanforderungen entspricht.
-
Dokumentation und Beispiele. Die meisten seriösen Repositories bieten umfassende Dokumentationen, Einrichtungsanleitungen und Anwendungsbeispiele, sodass Nutzer ohne Hindernisse loslegen können.
GitHub nach Reddit-Scrapern durchsuchen
Eine einfache Suche auf GitHub nach dem Begriff „reddit-scraper“ liefert eine Reihe von Repositorys, die speziell für die Datenextraktion aus Reddit ausgelegt sind.
Zu den potenziellen Repositorys, die Sie finden könnten, gehören:
-
Reddit-Scraper-Bots. Hierbei handelt es sich um automatisierte Skripte, die Beiträge, Kommentare und mehr aus bestimmten Subreddits oder Threads abrufen können.
-
Reddit-API-Wrapper. PRAW ist zwar der beliebteste, doch andere Wrapper bieten möglicherweise einzigartige Funktionen oder sind auf verschiedene Programmiersprachen zugeschnitten.
-
Dockerisierte Reddit-Scraper. Für diejenigen, die nach containerisierten Lösungen suchen, bieten einige Repositorien Docker-Setups an, um konsistente und skalierbare Scraping-Vorgänge zu gewährleisten.
-
Spezialisierte Tools. Einige Reddit-Crawler-Tools konzentrieren sich möglicherweise auf bestimmte Aufgaben, wie das Herunterladen aller Bilder aus einem Subreddit, das Extrahieren von Trendthemen oder die Überwachung bestimmter Schlüsselwörter.
Schritte zur Nutzung eines GitHub-Repositorys für das Reddit-Scraping
-
Wählen Sie ein Repository aus. Navigieren Sie zum Thema „reddit-scraper“ auf GitHub und wählen Sie ein Repository aus, das Ihren Anforderungen entspricht.
-
Klonen und Einrichten. Befolgen Sie die Anweisungen des Repositorys, die in der Regel das Klonen des Repositorys und das Einrichten erforderlicher Abhängigkeiten umfassen.
-
Konfigurieren. Viele Tools erfordern eine gewisse Konfiguration, wie z. B. die Angabe des Ziel-Subreddits, das Einrichten von API-Schlüsseln oder die Festlegung von Ausgabeformaten.
-
Ausführen und Daten extrahieren. Führen Sie die bereitgestellten Skripte oder Befehle aus, um den Scraping-Vorgang zu starten.
-
Nachbearbeitung. Je nach Tool müssen Sie die extrahierten Daten möglicherweise weiterverarbeiten, z. B. durch Filtern, Bereinigen oder Konvertieren in ein gewünschtes Format.
Scraper-Tool 6: Reddit-Scraper von Drittanbietern
Die enorme Menge und Vielfalt der Daten auf Reddit hat zur Entstehung zahlreicher Scraping-Tools von Drittanbietern geführt. Diese Tools zielen darauf ab, den Scraping-Prozess zu vereinfachen und ihn einem breiteren Publikum zugänglich zu machen – von Unternehmen bis hin zu Forschern. Werfen wir einen Blick auf einige der beliebtesten Reddit-Scraper von Drittanbietern:
- Preismodell: Bietet ein flexibles „pay-as-you-go“-Modell.
- Benutzererfahrung: Intuitive Benutzeroberfläche, die sowohl für Anfänger als auch für Experten geeignet ist.
- Leistung: Schnelle und zuverlässige Datenextraktion.
- Datenschutz: Legt großen Wert auf den Datenschutz der Nutzer und gewährleistet Datenintegrität und -sicherheit.
- Automatisierung: Bietet KI-gesteuerte Automatisierung für adaptives Scraping.
- Datentransformation: Integrierte Tools zur Aufbereitung und Analyse der gescrapten Daten.
- Vielseitigkeit: Umfassende Scraping-Lösung für verschiedene Websites.
- Benutzeroberfläche: Visuelle Benutzeroberfläche für einfache Projektgestaltung.
- Erweiterte Funktionen: Unterstützt AJAX und JavaScript für eine gründliche Datenextraktion.
- Zeitplanung: Bietet Funktionen zum Einrichten wiederkehrender Scraping-Aufgaben.
- Bereitstellung: Bietet sowohl cloudbasierte als auch lokale Extraktionsoptionen.
- Benutzerfreundlichkeit: Einfache Einrichtung mit Funktionen zur Bewältigung von CAPTCHAs und IP-Sperren.
- Integration: Bietet API-Integration für nahtlosen Datentransfer.
- Einfachheit: Konzentriert sich auf die Bereitstellung vorgefertigter Module für einfaches Scraping.
- Erschwinglichkeit: Legt Wert auf kostengünstige Lösungen, die für verschiedene Budgets geeignet sind.
- Hauptdienst: Bekannt als Proxy-Anbieter mit Fachwissen im Bereich Scraping.
- Anonymität: Bietet rotierende IP-Adressen und einen umfangreichen Pool an Residential-Proxys für anonymes Web-Scraping.
- Anleitungen: Bietet detaillierte Anleitungen zum Web-Scraping, unter anderem für Reddit.
- API-basierter Ansatz: Bietet eine unkomplizierte API für die einfache Integration in bestehende Systeme.
- Skalierbarkeit: Entwickelt für die Bewältigung umfangreicher Scraping-Aufgaben ohne Einbußen bei der Geschwindigkeit.
- Anonymität: Nutzt ein rotierendes Proxy-System, um anonymes und unterbrechungsfreies Scraping zu gewährleisten.
- Vielseitigkeit: Unterstützt mehrere Plattformen, wobei Reddit zu den Spezialgebieten zählt.
Zwar bringt jeder Scraper eines Drittanbieters seine eigenen Stärken mit, doch der nutzerorientierte Ansatz und die flexible Preisgestaltung von „Geonode“ machen das Tool zu einer herausragenden Option.
Welches Tool das beste ist, hängt jedoch oft von den individuellen Anforderungen, dem technischen Know-how und dem Budget ab.
Bewährte Verfahren und ethische Überlegungen
Das Scraping von Reddit ist zwar ein leistungsstarkes Werkzeug zur Datenextraktion, bringt jedoch auch eine Reihe von Verantwortlichkeiten mit sich.
Die Einhaltung ethischer Grundsätze schützt nicht nur die Rechte der Nutzer, sondern sichert auch den langfristigen Erfolg und den guten Ruf Ihrer Scraping-Aktivitäten.
Hier finden Sie einen detaillierten Überblick über die Best Practices und ethischen Überlegungen beim Scraping von Reddit:
Die Privatsphäre der Nutzer respektieren
Das digitale Zeitalter hat zu verstärkten Bedenken hinsichtlich der Privatsphäre der Nutzer geführt. Beim Scraping von Reddit ist es entscheidend, der Privatsphäre der Nutzer der Plattform oberste Priorität einzuräumen.
-
Ethisches Scraping. Stellen Sie stets sicher, dass die Daten, die Sie extrahieren, öffentlich zugänglich sind. Vermeiden Sie das Scraping persönlicher Informationen oder Inhalte aus privaten Subreddits. Denken Sie daran: Nur weil Daten zugänglich sind, bedeutet das nicht, dass es ethisch vertretbar ist, sie zu scrapen.
-
Anonymität. Auch wenn Reddit-Nutzer unter Pseudonymen agieren, ist es unerlässlich, diese Daten mit Sorgfalt zu behandeln. Vermeiden Sie Handlungen, die Nutzer de-anonymisieren oder ihre Identität in der realen Welt preisgeben könnten.
-
Datenschutz. Wenn Sie gescrapte Daten speichern, stellen Sie sicher, dass diese verschlüsselt und sicher gespeichert werden. Implementieren Sie robuste Cybersicherheitsmaßnahmen, um unbefugten Zugriff zu verhindern.
-
Transparenz. Wenn Sie gescrapte Daten für Forschungs- oder geschäftliche Zwecke nutzen, sollten Sie transparent darüber informieren, woher die Daten stammen und wie sie verwendet werden.
Umgang mit Ratenbegrenzungen und Einschränkungen
Reddit setzt, wie viele andere Plattformen auch, Ratenbegrenzungen ein, um die Serverstabilität zu gewährleisten und Missbrauch zu verhindern.
-
Machen Sie sich mit den API-Begrenzungen vertraut. Wenn Sie die Reddit-API nutzen, machen Sie sich mit deren Ratenbegrenzungen vertraut. In der Regel sind diese auf eine bestimmte Anzahl von Anfragen pro Minute festgelegt. Das Überschreiten dieser Grenzen kann zu vorübergehenden oder dauerhaften Sperren führen.
-
Verwenden Sie Verzögerungen. Bauen Sie Verzögerungen zwischen den Scraping-Anfragen ein. Dies schont nicht nur die Server der Plattform, sondern verringert auch das Risiko, dass Ihr Scraper identifiziert und blockiert wird.
-
Wechseln Sie IP-Adressen und User-Agents mit einem zuverlässigen Proxy-Anbieter. Die Nutzung der Residential-Proxys von Geonode kann dabei helfen, Einschränkungen zu umgehen, da sie einen rotierenden Pool an IP-Adressen bereitstellen, wodurch Ihre Scraping-Aktivitäten natürlicher wirken. In Verbindung mit wechselnden User-Agents kann diese Strategie das Risiko einer Sperrung erheblich verringern. Wenden Sie diese Strategie jedoch stets ethisch an und vermeiden Sie aggressives Scraping, das den Betrieb der Plattform stört.
-
Beachten Sie die robots.txt von Reddit. Die robots.txt-Datei enthält Richtlinien dazu, was gescrapt werden darf und was nicht. Überprüfen Sie stets die Regeln von Reddit und halten Sie sich daran.
Datenspeicherung und -nutzung
Die Verantwortung endet nicht nach dem Scraping der Daten. Wie Sie diese Daten speichern und nutzen, ist ebenfalls entscheidend.
-
Sichere Speicherung. Stellen Sie sicher, dass alle gespeicherten Daten in verschlüsselten Datenbanken aufbewahrt werden. Erstellen Sie regelmäßig Backups dieser Daten und ergreifen Sie Sicherheitsmaßnahmen, um Datenlecks zu verhindern.
-
Datenminimierung. Speichern Sie nur Daten, die für Ihren Zweck notwendig sind. Vermeiden Sie es, übermäßige Mengen an Informationen anzuhäufen, insbesondere wenn es sich um sensible oder personenbezogene Daten handelt.
-
Ethische Nutzung. Wenn Sie gescrapte Daten veröffentlichen oder weitergeben, stellen Sie sicher, dass diese der Reddit-Community keinen Schaden zufügen oder sie falsch darstellen.
Holen Sie stets die Zustimmung ein, wenn Sie Daten auf eine Weise nutzen, die Nutzer oder deren Ruf beeinträchtigen könnte.
-
Bleiben Sie auf dem Laufenden: Die Nutzungsbedingungen und Community-Richtlinien von Reddit können sich ändern. Überprüfen Sie diese regelmäßig, um sicherzustellen, dass Ihre Scraping-Praktiken weiterhin konform sind.
Obwohl das Scraping auf Reddit enorme Möglichkeiten zur Datenextraktion bietet, ist es von größter Bedeutung, dabei respektvoll und verantwortungsbewusst vorzugehen.
Der Einsatz von Tools wie den Residential-Proxys von Geonode kann Ihre Scraping-Möglichkeiten verbessern, doch ethische Überlegungen sollten bei jedem Scraping-Projekt stets im Vordergrund stehen, um sicherzustellen, dass die Rechte der Nutzer und der Plattform stets gewahrt bleiben.
Häufig gestellte Fragen
F: Was ist der Unterschied zwischen der offiziellen Reddit-API und Scrapern von Drittanbietern?
A: Die offizielle Reddit-API wird von Reddit bereitgestellt und unterliegt bestimmten Ratenbeschränkungen und Nutzungsbedingungen. Scraper von Drittanbietern bieten zwar möglicherweise mehr Flexibilität, halten sich jedoch nicht immer an die Richtlinien von Reddit.
F: Wie kann ich sicherstellen, dass ich Reddit ethisch und rechtmäßig scrape?
A: Achten Sie stets auf den Datenschutz der Nutzer, halten Sie sich an die Nutzungsbedingungen von Reddit und vermeiden Sie das Scraping privater oder sensibler Informationen.
F: Fallen bei der Nutzung der Reddit-API Kosten an?
A: Der Basiszugang ist zwar kostenlos, bei höheren Anfragevolumina oder Premium-Funktionen können jedoch Kosten anfallen.
F: Wie kann ich Ratenbeschränkungen handhaben und vermeiden, gesperrt zu werden?
A: Baue Verzögerungen zwischen den Anfragen ein, beachte die „robots.txt“-Datei von Reddit und erwäge die Verwendung rotierender Proxys.
F: Was sind die besten Tools zum Scrapen von Reddit-Kommentaren und anderen Daten?
A: Zu den beliebten Tools gehören „Geonode“, „Parsehub“ und „Octoparse“, doch welches Tool am besten geeignet ist, hängt von den individuellen Anforderungen und Kenntnissen ab.
Der erste Schritt zum Reddit-Scraping
Reddit-Scraping mag auf den ersten Blick einschüchternd wirken, insbesondere angesichts der Vielzahl an Tools und Techniken, die Ihnen zur Verfügung stehen.
Denken Sie jedoch daran, dass jeder Experte einmal ein Anfänger war. Der Schlüssel zum Erfolg liegt darin, klein anzufangen und schrittweise zu expandieren, während Sie Selbstvertrauen und Verständnis gewinnen.
Egal, ob Sie als Forscher nach Erkenntnissen suchen, als Marketingfachmann Trends verfolgen oder einfach nur ein neugieriger Datenbegeisterter sind – das Scraping von Reddit kann Ihnen eine Fülle an Informationen erschließen. Es ist eine Fähigkeit, die das Sprichwort „Im Bereich der Programmierung sind die Möglichkeiten grenzenlos“ wirklich verkörpert.
Also: Krempeln Sie die Ärmel hoch und begeben Sie sich noch heute auf Ihre Reise ins Reddit-Scraping. Nehmen Sie die Herausforderungen an und denken Sie daran: Jede Hürde ist ein Sprungbrett auf dem Weg zur Meisterschaft.

