Acceder a datos inmobiliarios desde plataformas como redfin.com se ha convertido en una necesidad para muchas empresas.
Tanto si eres analista inmobiliario, científico de datos o simplemente un aficionado a la tecnología, saber cómo extraer datos de Redfin puede ofrecerte información muy valiosa.
Esta guía completa te explicará las mejores prácticas, herramientas y métodos para extraer datos de Redfin de forma eficiente y ética.
¿Por qué extraer datos de Redfin?
Redfin: una excelente fuente de anuncios inmobiliarios
Redfin es una destacada página web inmobiliaria que ofrece anuncios de viviendas en venta, datos sobre el mercado inmobiliario y otros servicios relacionados.
Fundada en 2004, Redfin ha crecido hasta convertirse en una de las plataformas líderes del sector inmobiliario, ofreciendo a los usuarios una interfaz intuitiva para buscar propiedades según diversos criterios, como el tipo de inmueble, la ubicación, el rango de precios, el número de dormitorios y mucho más.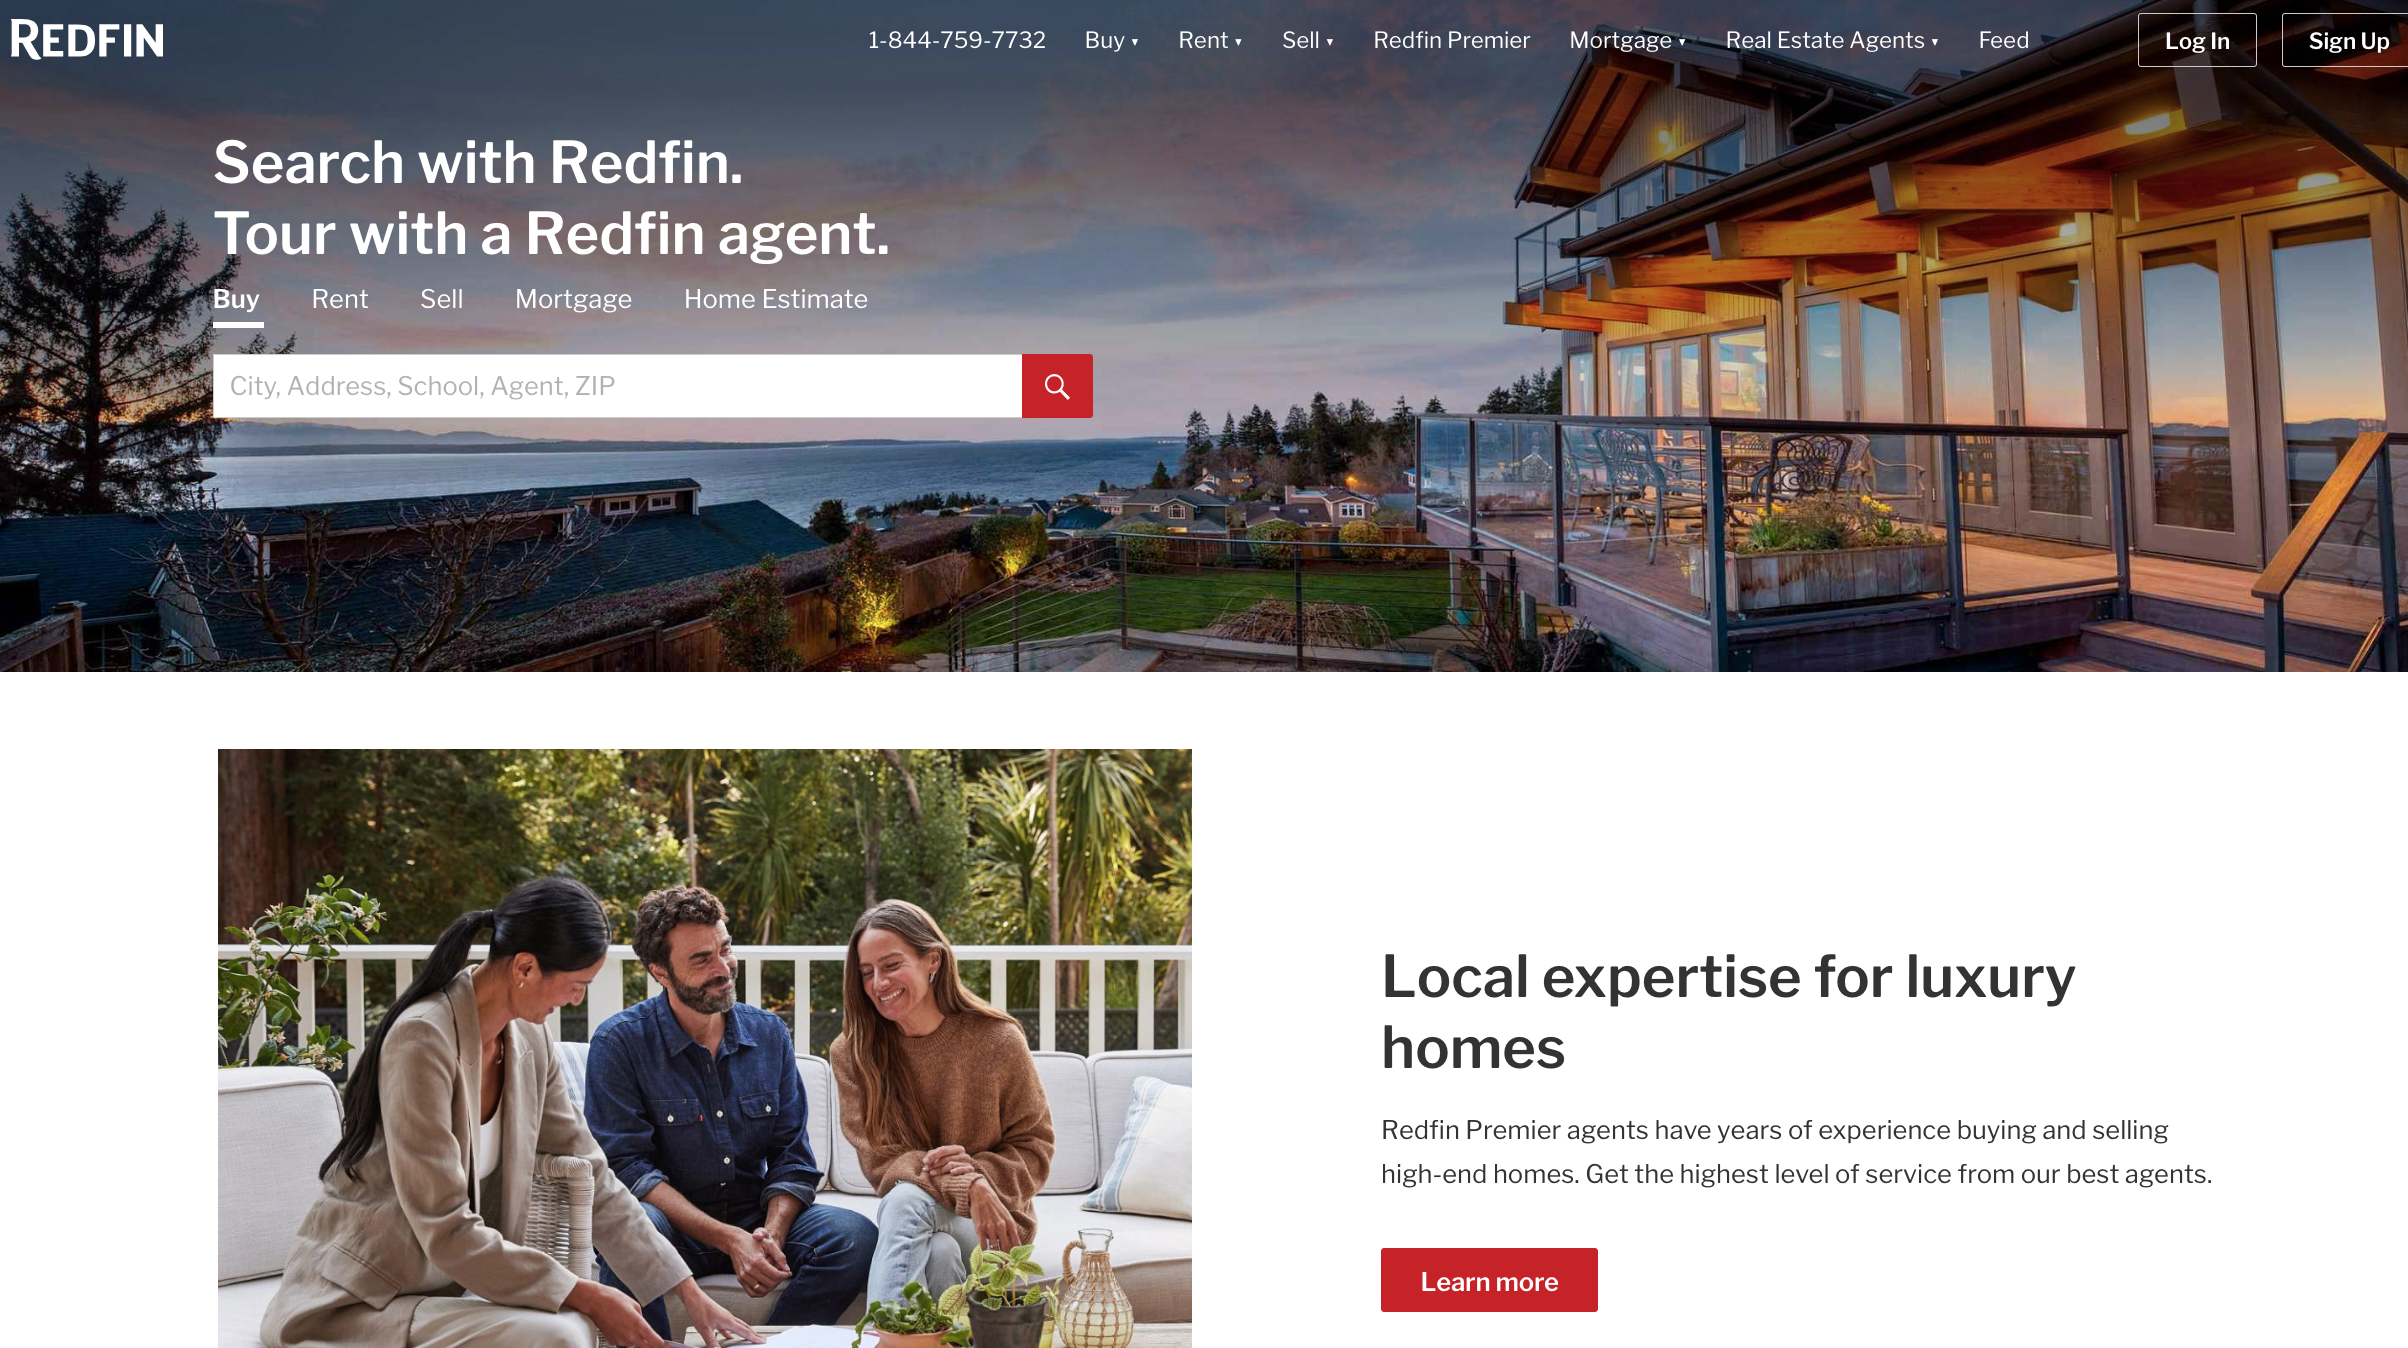
Una de las características distintivas de Redfin son sus detalladas fichas de propiedades, que ofrecen información exhaustiva sobre cada inmueble, incluyendo fotos en alta resolución, el historial de la propiedad y datos sobre el barrio.
Además, Redfin ofrece herramientas como el «Redfin Estimate», que proporciona un valor de mercado estimado para las viviendas, y búsquedas interactivas en mapas que permiten a los usuarios explorar propiedades en barrios o regiones específicos.
Para los corredores, agentes o particulares que deseen recopilar datos sobre anuncios inmobiliarios, tendencias del mercado u otros detalles de las propiedades, Redfin es un recurso muy valioso.
Importancia de los datos inmobiliarios
Los datos inmobiliarios son más que simples cifras y anuncios; son un reflejo del pulso del mercado.
Cada propiedad anunciada, cada variación de precio y cada venta cuenta una historia sobre la comunidad, la economía y el comportamiento de los consumidores.
Mediante el scraping de Redfin, una de las principales plataformas inmobiliarias, los agentes inmobiliarios y las empresas pueden acceder a un tesoro de datos.
Estos datos pueden ofrecer información sobre el valor de las propiedades, las tendencias del mercado y las preferencias de la comunidad.
En un mundo impulsado por los datos, disponer de información inmobiliaria oportuna y precisa puede suponer un punto de inflexión para muchas partes interesadas, desde inversores hasta urbanistas.
Aplicaciones del extractor de datos de Redfin en el análisis de mercado
El análisis de mercado es crucial para cualquier empresa o inversor que desee tomar decisiones fundamentadas. Con los datos inmobiliarios de Redfin, los analistas pueden:
- Detectar tendencias. Con un rastreador inmobiliario, se puede identificar qué barrios están ganando popularidad, cuáles están experimentando un descenso en el interés o dónde se están disparando los valores inmobiliarios.
- Análisis de la demanda. El rastreo web inmobiliario ayuda a los agentes a comprender qué buscan los compradores o inquilinos. Esto puede referirse al tamaño de la vivienda, las comodidades, la proximidad a colegios o lugares de trabajo, y mucho más.
- Decisiones de inversión. Para los inversores inmobiliarios, los datos pueden ofrecer opciones viables sobre dónde comprar a continuación, en qué tipo de propiedades invertir o cuándo vender.
- Elaboración de políticas. Para los ayuntamientos y los urbanistas, comprender el mercado inmobiliario puede ayudar a tomar decisiones sobre el desarrollo de infraestructuras, las normas de ordenación territorial y los proyectos de renovación urbana.
Consideraciones éticas
Aunque el scraping proporciona una gran cantidad de datos, es esencial abordarlo de forma responsable. A continuación se indican algunas directrices éticas a tener en cuenta:
Respeta el archivo robots.txt. Este archivo del sitio web de Redfin indica a qué partes del sitio se puede acceder y de las que se pueden extraer datos. Ignorarlo no solo es poco ético, sino que también puede acarrear consecuencias legales.
Evita sobrecargar los servidores. Enviar demasiadas solicitudes en poco tiempo puede ralentizar o bloquear el sitio web de Redfin. Es fundamental espaciar las solicitudes para evitar perturbar el funcionamiento del sitio.
Privacidad de los datos. Hay que tener siempre cuidado con el uso que se hace de los datos extraídos de Redfin, especialmente si contienen información personal. El uso indebido de dichos datos puede acarrear graves consecuencias legales y éticas.
Diferentes formas de extraer datos inmobiliarios de Redfin
La extracción de datos web se ha convertido en un método indispensable para obtener información valiosa de fuentes en línea como Redfin. A continuación se presentan algunas herramientas y técnicas disponibles, cada una con sus propias ventajas y limitaciones:
Uso de bibliotecas de Python
-
- Requests y BeautifulSoup. Se trata de una combinación habitual para el scraping web.
Requests recupera la página web, y BeautifulSoup analiza el contenido HTML.
- Scrapy. Un marco de trabajo de scraping más avanzado y potente, capaz de gestionar tareas complejas de scraping, incluyendo la gestión de sesiones, cookies e incluso la simulación de interacciones de usuario.
Uso de servicios de scraping web
-
- Scraper API deGeonode. Geonode ofrece un scraper API que se puede utilizar para interactuar con páginas web y extraer datos. Permite realizar acciones como hacer clic, desplazarse y escribir, lo que puede resultar útil para extraer contenido dinámico.
- Otros servicios de extracción. Existen muchos proveedores que ofrecen servicios de extracción de datos inmobiliarios de Redfin. Una búsqueda rápida te ayudará a reducir las opciones y, finalmente, a seleccionar la que mejor se adapte a tus necesidades.
Herramientas de automatización del navegador
-
- Selenium: una herramienta utilizada principalmente para probar aplicaciones web, pero que también resulta muy eficaz para el scraping web, especialmente en sitios web que cargan contenido de forma dinámica mediante JavaScript.
Proceso de extracción manual
La extracción manual consiste en copiar manualmente los datos de un sitio web y pegarlos en el formato o la herramienta deseados.
Este método, también conocido como screen scraping, requiere mucho trabajo y tiempo, pero puede utilizarse para tareas pequeñas o cuando la extracción automatizada no es viable.
Guía paso a paso para extraer datos de Redfin con Python
Paso 1: Configurar el entorno
Instalar Python. Asegúrate de tener Python instalado en tu sistema. Si no es así, descárgalo e instálalo desde la página web oficial de Python.
Instala las bibliotecas necesarias. Necesitarás algunas bibliotecas de Python que te ayudarán con el scraping. Instálalas utilizando pip. 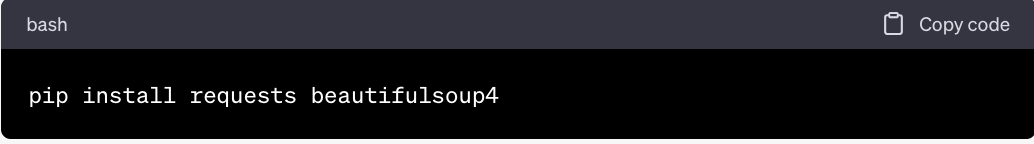
Paso 2: Identifica las URL permitidas
Aquí tienes un subconjunto de las URL de búsqueda permitidas extraídas del archivo robots.txt de Redfin: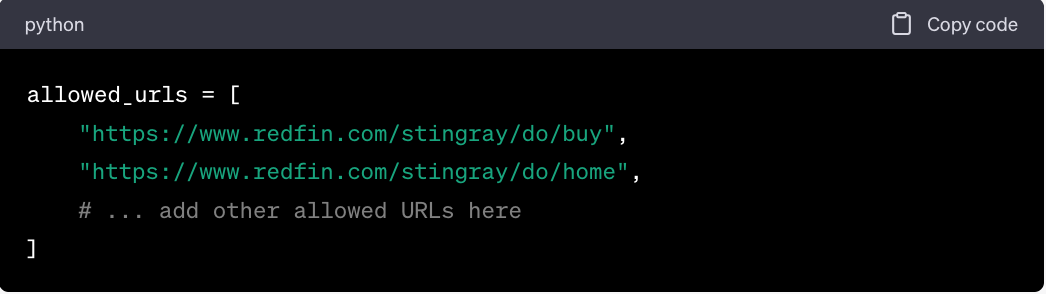
Paso 3: Escribir el programa de extracción
Importar las bibliotecas necesarias 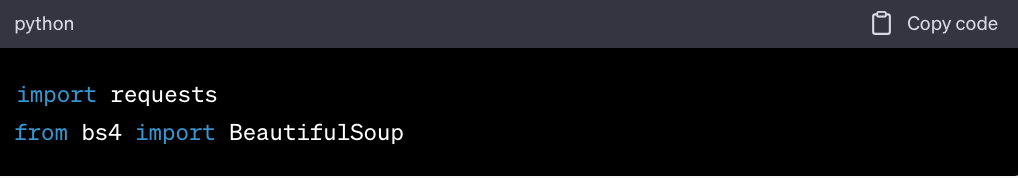
Definir la función de extracción 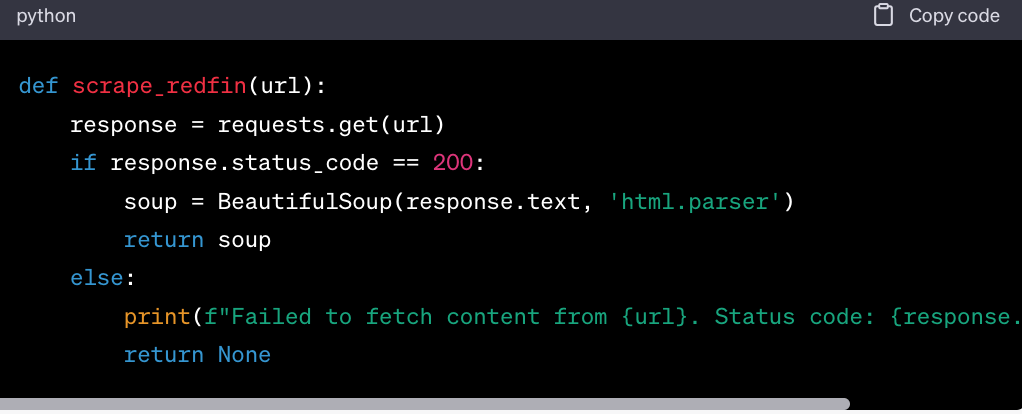
Recorrer las URL permitidas y extraer los datos 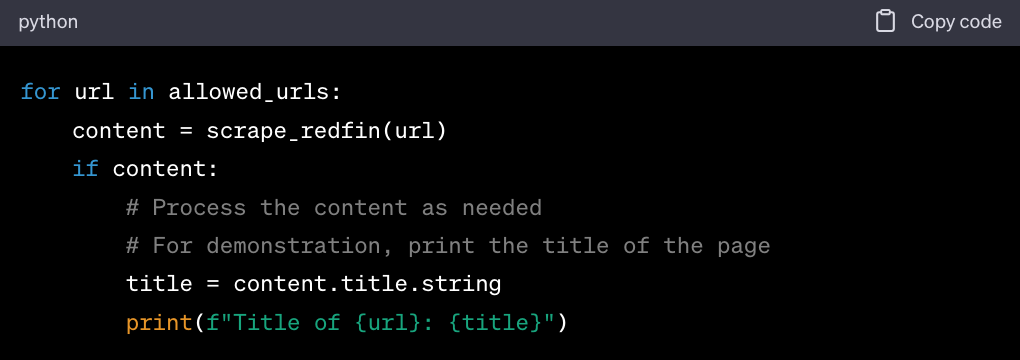
Paso 4: Procesar y almacenar los datos
Una vez extraído el contenido, puedes procesarlo según sea necesario. Por ejemplo, es posible que quieras extraer datos concretos, limpiar los datos o almacenarlos en una base de datos o en un archivo.
Extraer datos. Utiliza funciones de BeautifulSoup como find(), find_all(), etc., para extraer datos específicos del contenido extraído.
Limpiar los datos. Asegúrate de que los datos estén en el formato deseado, elimina cualquier carácter no deseado o espacio en blanco, y gestiona los datos que falten o sean incoherentes.
Almacenar los datos. Dependiendo de tus necesidades, puedes almacenar los datos en una base de datos, escribirlos en un archivo CSV o guardarlos en cualquier otro formato que desees.
Cómo utilizar Scrapy para recopilar datos de Redfin
Paso 1: Configura tu entorno
Instala Python. Si aún no lo has hecho, descarga e instala Python desde la página web oficial de Python.
Instala Scrapy.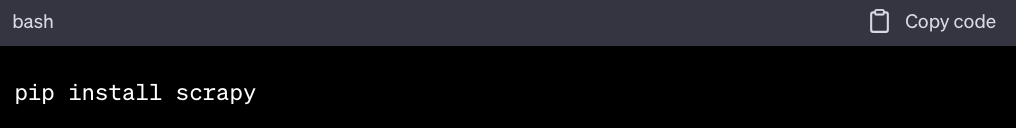
Paso 2: Crea un proyecto de Scrapy
Abre tu terminal o la línea de comandos.
Navega hasta el directorio donde quieras crear tu proyecto de Scrapy.
Ejecuta el siguiente comando: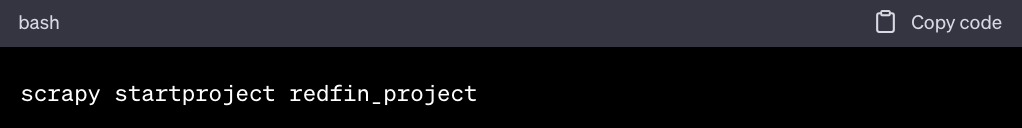
Paso 3: Definir la araña
Navega hasta el directorio «spiders» dentro de «redfin_project»: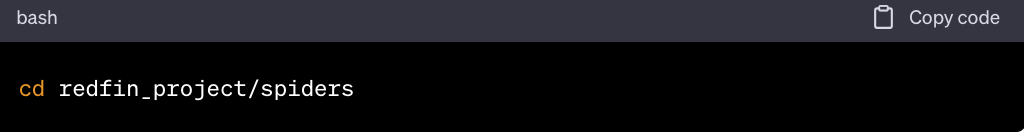
Crea un nuevo archivo llamado «redfin_spider.py».
Abre «redfin_spider.py» en tu editor de texto preferido y añade el siguiente código: 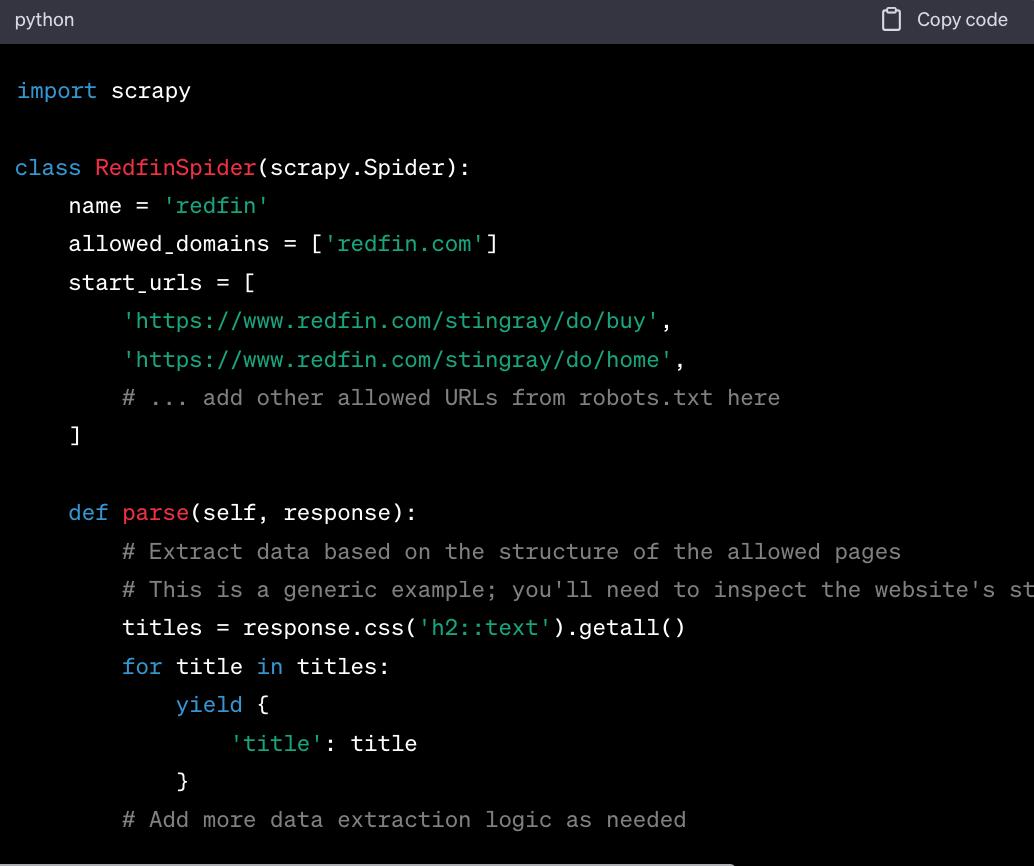
Paso 4: Configurar los ajustes de Scrapy
Vuelve a la raíz de tu proyecto de Scrapy (redfin_project).
Abre settings.py en un editor de texto.
Modifica o añade los siguientes ajustes para cumplir con la política de Redfin sobre el uso de robots (robots.txt) y evitar que te bloqueen: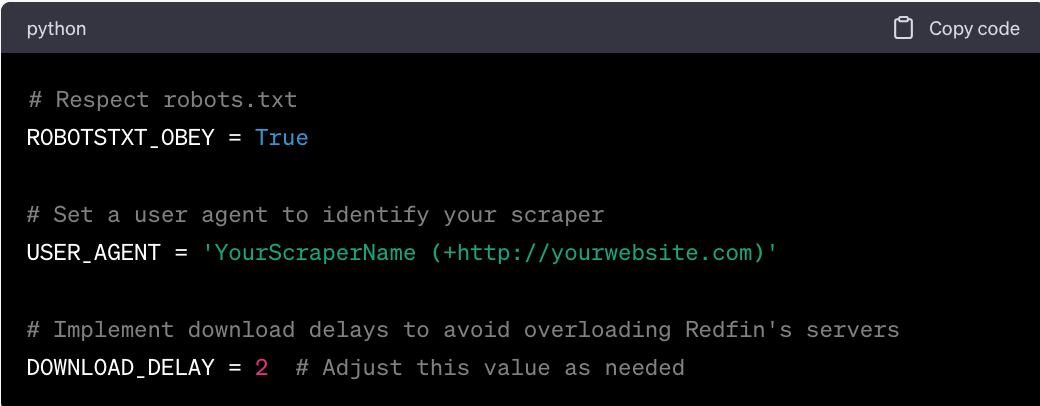
Paso 5: Ejecuta el spider
Abre tu terminal o la línea de comandos.
Navega hasta el directorio raíz de tu proyecto de Scrapy (redfin_project).
Ejecuta el spider con el siguiente comando: 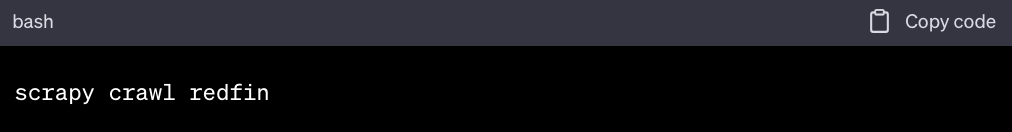
Paso 6: Guarda los datos extraídos
Por defecto, Scrapy mostrará los datos extraídos en la consola. Si quieres guardar los datos en un archivo:
Modifica el comando de la siguiente manera: 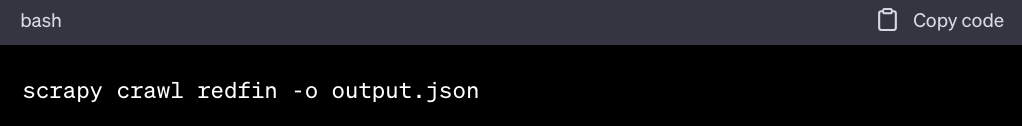
Esto guardará los datos extraídos en un archivo llamado «output.json» en formato JSON. También puedes utilizar otros formatos, como CSV, cambiando la extensión del archivo.
Cómo utilizar Geonode Scraper API para extraer datos de Redfin sin que te bloqueen
Paso 1: Configura tu entorno
Instala Python: Si aún no lo has hecho, descarga e instala Python desde la página web oficial de Python.
Instala las bibliotecas necesarias: Necesitarás la biblioteca requests para realizar llamadas a la API de Geonode's Scraper API: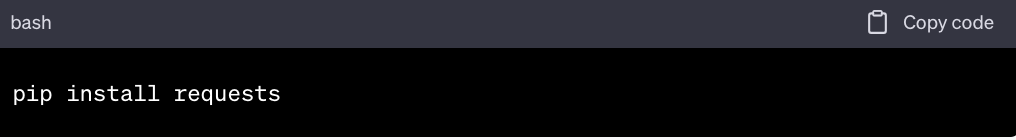
Paso 2: Obtener una clave de API de Geonode
- Regístrate o inicia sesión en Geonode.
- Accede a la configuración de tu cuenta o al panel de control para obtener tu clave API. Esta clave será necesaria para la autenticación al realizar solicitudes a Scraper API.
Paso 3: Identifica las URL permitidas de Redfin
Aquí tienes un subconjunto de URL permitidas para el scraping: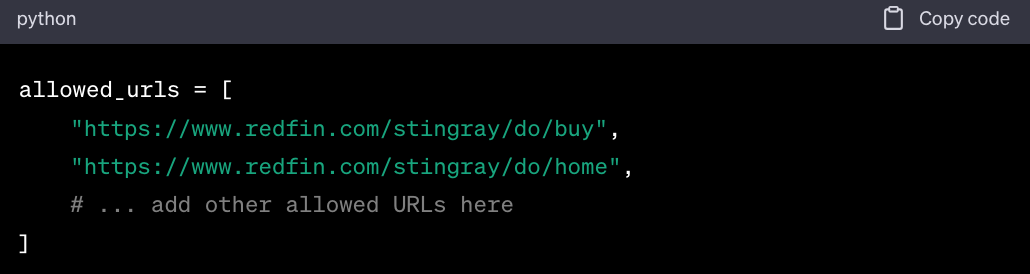
Paso 4: Escribe el script de extracción
Importa las bibliotecas necesarias:
Define la función de extracción: 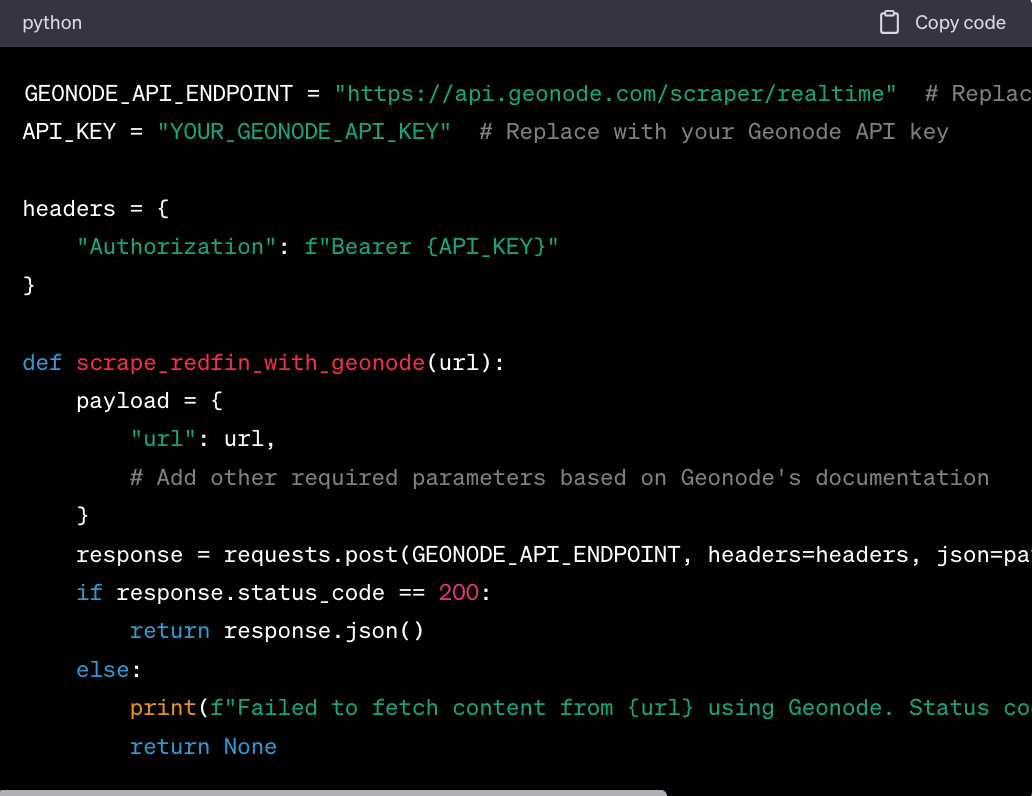
Recorre las URL permitidas y extrae los datos: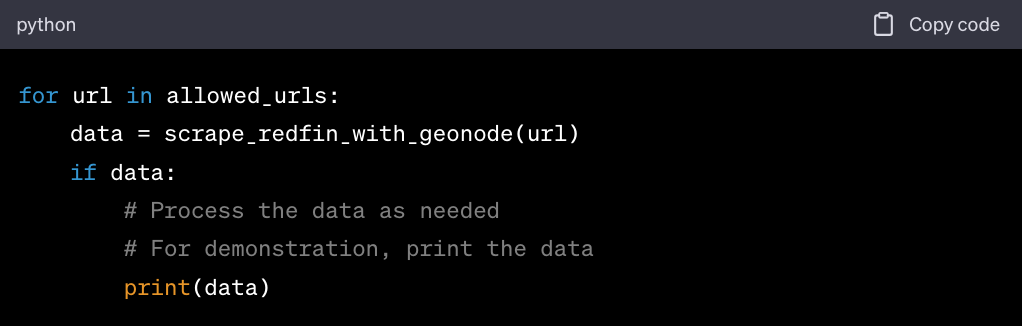
Paso 5: Procesar y almacenar los datos
Una vez extraído el contenido, puedes procesarlo según sea necesario. Por ejemplo, es posible que quieras extraer datos concretos, limpiar los datos o almacenarlos en una base de datos o en un archivo.
- Extraer datos. Dependiendo de la estructura de los datos devueltos por Geonode, es posible que tengas que analizarlos para extraer la información deseada.
- Limpiar datos. Asegúrate de que los datos estén en el formato deseado, elimina cualquier carácter no deseado o espacio en blanco y gestiona los datos que falten o sean inconsistentes.
- Almacenar datos. Dependiendo de tus necesidades, puedes almacenar los datos en una base de datos, escribirlos en un archivo CSV o guardarlos en cualquier otro formato que desees.
Pasos adicionales tras el scraping
Independientemente de la herramienta de scraping de Redfin que utilices, asegúrate de:
-
Revisar y perfeccionar los datos. Tras el rastreo inicial, revisa los datos que hayas recopilado. Asegúrate de que sean precisos y estén completos.
Perfecciona la lógica de rastreo si es necesario para capturar cualquier dato que se haya omitido o para mejorar la calidad de los datos.
-
Realiza un seguimiento periódico. Si tienes previsto extraer datos de Redfin con regularidad, supervisa el rendimiento de tu extractor y los datos que recopila.
Los sitios web pueden cambiar su estructura, lo que podría hacer que tu extractor dejara de funcionar. Un seguimiento periódico te ayudará a detectar y solucionar cualquier problema a tiempo.
Retos y soluciones en el uso de herramientas de extracción de datos inmobiliarios
El scraping web es una herramienta muy potente, pero conlleva una serie de retos, especialmente cuando se trata de sitios web complejos como Redfin.
Gestión del contenido dinámico
El reto: Los sitios web modernos como Redfin cargan el contenido de forma dinámica mediante JavaScript. Las herramientas tradicionales de scraping que solo recogen el código fuente HTML pueden pasar por alto este contenido cargado dinámicamente.
Soluciones:
-
Herramientas de automatización del navegador. Herramientas como Selenium pueden simular el comportamiento de un navegador real, lo que te permite extraer contenido que se carga dinámicamente.
Con Selenium, puedes esperar a que se carguen elementos específicos, interactuar con menús desplegables e incluso desplazarte por las páginas para activar la carga de contenido.
-
Inspeccionar las llamadas de red. Utilizando las herramientas de desarrollo del navegador, inspecciona las llamadas de red que realiza el sitio web. A menudo, el contenido dinámico se carga mediante llamadas AJAX a API internas.
Si consigues identificar estas llamadas, podrás solicitarles datos directamente, lo que te permitirá obtenerlos en un formato estructurado como JSON.
Cómo eludir las medidas anti-scraping
El reto: Redfin puede emplear medidas anti-scraping para impedir que los bots automatizados accedan a sus datos. Esto puede incluir CAPTCHAs, límites de frecuencia o incluso bloqueos de IP.
Soluciones:
-
Respeta el archivo «robots.txt.» Empieza siempre por consultar el archivo «robots.txt» del sitio web. Este archivo proporciona directrices sobre a qué partes del sitio pueden acceder los rastreadores web.
-
Rotación de User-Agent. Alterna los User-Agents para simular diferentes navegadores y dispositivos. Esto puede ayudar a eludir las restricciones dirigidas a User-Agents específicos.
-
Rotación de direcciones IP. Utiliza Geonode proxies residenciales para rotar las direcciones IP. Si se bloquea una IP, el rastreador puede cambiar a otra.
-
Limitación de frecuencia. Introduce retrasos entre las solicitudes para evitar enviar demasiadas en un breve espacio de tiempo. Esto puede ayudar a evitar el bloqueo de direcciones IP y a mostrar respeto hacia los servidores del sitio web.
-
Gestión de CAPTCHAs. Herramientas como 2Captcha o Anti-Captcha ofrecen servicios para resolver CAPTCHAs. Como alternativa, considera utilizar herramientas de automatización del navegador para resolver manualmente los CAPTCHAs cuando aparezcan.
Garantizar la precisión e integridad de los datos
El reto: El web scraping puede dar lugar en ocasiones a datos incompletos o inexactos, especialmente si cambia la estructura del sitio web o si hay inconsistencias en la forma en que se presentan los datos.
Soluciones:
-
Supervisión periódica. Supervisa continuamente el rendimiento de tu rastreador. Si detectas datos que faltan o son inexactos, podría deberse a cambios en la estructura del sitio web.
-
Gestión de errores. Implementa un sistema robusto de gestión de errores en tu scraper. Si el scraper detecta un error, debería ser capaz de registrarlo y continuar o volver a intentar la solicitud, garantizando que los problemas temporales no provoquen la pérdida de datos.
-
Validación de datos. Tras el scraping, valida los datos para asegurarte de que cumplen determinados criterios o formatos. Por ejemplo, si extraes precios de inmuebles, asegúrate de que los datos sean numéricos y se encuentren dentro de un rango razonable.
-
Copias de seguridad. Mantén siempre copias de seguridad de los datos extraídos. Si detectas un problema con tu rastreador o con los datos que está recopilando, disponer de copias de seguridad te permitirá volver a un estado anterior.
Al comprender y abordar estos retos, podrás garantizar que tus iniciativas de rastreo web sean más exitosas, éticas y resistentes al panorama de la web, en constante evolución.
La evolución del web scraping
El web scraping comenzó como un método sencillo para extraer contenido estático de páginas web.
Los primeros sitios web eran sencillos, y extraer información de ellos apenas requería descargar el código HTML y analizarlo.
Hoy en día, sitios web como Redfin son dinámicos, interactivos y están repletos de funciones. Carguen contenido sobre la marcha, responden a las interacciones de los usuarios e incluso personalizan el contenido en función del comportamiento de estos.
Esta evolución ha hecho que el scraping resulte más complicado, pero también más gratificante. Las herramientas y técnicas modernas, desde la automatización de navegadores hasta el aprendizaje automático, han surgido para hacer frente a estos retos.
El futuro de la extracción de datos inmobiliarios
El mercado inmobiliario es dinámico, y los anuncios y las tendencias de precios cambian rápidamente. La demanda de datos en tiempo real y de información útil impulsará las innovaciones en las tecnologías de scraping, lo que propiciará una extracción de datos más rápida y frecuente.
A medida que los datos adquieran mayor valor, las consideraciones legales y éticas en torno a la extracción de datos pasarán a primer plano.
Cabe esperar que se establezcan directrices y normativas más claras que regulen qué se puede y qué no se puede extraer, garantizando que la extracción de datos respete la privacidad y los derechos de propiedad intelectual.
Mantener la ética
El web scraping es una herramienta muy potente, pero ese poder conlleva la responsabilidad de utilizarla de forma ética. Cuando extraigas datos de sitios web como Redfin para tus diversas necesidades, da siempre prioridad al respeto, la integridad y la equidad.
Al realizar el scraping, te aseguras de que la búsqueda de datos nunca ponga en peligro los valores que unen a la comunidad digital.

