L'accès aux données immobilières provenant de plateformes telles que redfin.com est devenu une nécessité pour de nombreuses entreprises.
Que vous soyez analyste immobilier, data scientist ou simplement passionné de technologie, savoir comment extraire des données de Redfin peut vous apporter des informations précieuses.
Ce guide complet vous présentera les meilleures pratiques, les outils et les méthodes permettant d'extraire efficacement et de manière éthique des données de Redfin.
Pourquoi extraire les données de Redfin ?
Redfin : une excellente source d’annonces immobilières
Redfin est un site immobilier de premier plan qui propose des annonces de biens à vendre, des données sur le marché immobilier et d’autres services connexes.
Fondé en 2004, Redfin s'est développé pour devenir l'une des principales plateformes du secteur immobilier, offrant à ses utilisateurs une interface conviviale leur permettant de rechercher des biens en fonction de divers critères tels que le type de bien, l'emplacement, la fourchette de prix, le nombre de chambres, et bien plus encore 
L'une des caractéristiques distinctives de Redfin réside dans ses fiches immobilières détaillées, qui fournissent des informations complètes sur chaque bien, notamment des photos en haute résolution, l'historique du bien et des informations sur le quartier.
De plus, Redfin propose des outils tels que le « Redfin Estimate », qui fournit une estimation de la valeur marchande des logements, ainsi que des recherches cartographiques interactives permettant aux utilisateurs d’explorer les biens situés dans des quartiers ou des régions spécifiques.
Pour les courtiers, les agents immobiliers ou les particuliers cherchant à recueillir des données sur les annonces immobilières, les tendances du marché ou d’autres détails relatifs aux biens, Redfin constitue une ressource précieuse.
Importance des données immobilières
Les données immobilières ne se résument pas à de simples chiffres et annonces ; elles reflètent le pouls du marché.
Chaque bien mis en vente, chaque variation de prix et chaque vente raconte une histoire sur la communauté, l’économie et le comportement des consommateurs.
En effectuant du scraping sur Redfin, l’une des principales plateformes immobilières, les agents immobiliers et les entreprises peuvent accéder à une mine d’informations.
Ces données peuvent fournir des informations précieuses sur la valeur des biens, les tendances du marché et les préférences des communautés.
Dans un monde régi par les données, disposer d’informations immobilières précises et actualisées peut changer la donne pour de nombreux acteurs, des investisseurs aux urbanistes.
Applications du scraper Redfin dans l’analyse de marché
L’analyse de marché est cruciale pour toute entreprise ou tout investisseur cherchant à prendre des décisions éclairées. Grâce aux données immobilières de Redfin, les analystes peuvent :
- Identifier les tendances. Grâce à un scraper immobilier, il est possible de déterminer quels quartiers gagnent en popularité, lesquels suscitent un intérêt en baisse ou encore où les valeurs immobilières montent en flèche.
- Analyser la demande. Le web scraping immobilier aide les agents à comprendre ce que recherchent les acheteurs ou les locataires. Cela peut concerner la taille du bien, les équipements, la proximité des écoles ou des lieux de travail, et bien plus encore.
- Prise de décisions d’investissement. Pour les investisseurs immobiliers, les données peuvent offrir des options viables quant à l’emplacement de leur prochain achat, au type de biens dans lesquels investir ou au moment opportun pour vendre.
- Élaboration des politiques. Pour les collectivités locales et les urbanistes, la compréhension du marché immobilier peut faciliter la prise de décisions concernant le développement des infrastructures, les règlements d’urbanisme et les projets de rénovation urbaine.
Considérations éthiques
Bien que le scraping fournisse une mine de données, il est essentiel de l’aborder de manière responsable. Voici quelques principes éthiques à prendre en compte :
Respectez le fichier robots.txt. Ce fichier, présent sur le site web de Redfin, indique les parties du site auxquelles il est possible d’accéder et d’extraire des données. Le ne pas respecter n’est pas seulement contraire à l’éthique, mais peut également entraîner des conséquences juridiques.
Évitez de surcharger les serveurs. Envoyer trop de requêtes en peu de temps peut ralentir ou faire planter le site de Redfin. Il est essentiel d’espacer les requêtes pour ne pas perturber le fonctionnement du site.
Confidentialité des données. Faites toujours preuve de prudence quant à l’utilisation des données Redfin, en particulier celles issues du scraping, surtout si elles contiennent des informations personnelles. Une utilisation abusive de ces données peut entraîner de graves conséquences juridiques et éthiques.
Différentes méthodes pour extraire les données immobilières de Redfin
Le web scraping est devenu une méthode incontournable pour extraire des informations précieuses à partir de sources en ligne telles que Redfin. Voici quelques outils et techniques disponibles, chacun présentant ses propres avantages et limites :
Utilisation des bibliothèques Python
-
- Requests et BeautifulSoup. Il s’agit d’une combinaison courante pour le scraping Web.
Requests récupère la page Web, tandis que BeautifulSoup analyse le contenu HTML.
- Scrapy. Un framework de scraping plus avancé et plus puissant, capable de gérer des tâches complexes, notamment la gestion des sessions, des cookies et même la simulation d’interactions utilisateur.
Utilisation de services de scraping Web
-
- ** Scraper API deGeonode. Geonode** propose un scraper API permettant d’interagir avec des pages Web et d’extraire des données. Il permet d’effectuer des actions telles que cliquer, faire défiler et saisir du texte, ce qui peut s’avérer utile pour le scraping de contenu dynamique.
- Autres services d’extraction. Il existe de nombreux prestataires proposant des services de scraping des données immobilières de Redfin. Une recherche rapide vous aidera à affiner vos choix et, à terme, à sélectionner celui qui correspond le mieux à vos besoins.
Outils d’automatisation des navigateurs
-
- Selenium : un outil principalement utilisé pour tester des applications web, mais qui s’avère également très performant pour le scraping, en particulier pour les sites web qui chargent du contenu de manière dynamique à l’aide de JavaScript.
Processus de scraping manuel
Le scraping manuel consiste à copier manuellement des données depuis un site web et à les coller dans le format ou l’outil souhaité.
Cette méthode, également appelée screen scraping, est fastidieuse et chronophage, mais peut être utilisée pour de petites tâches ou lorsque le scraping automatisé n’est pas envisageable.
Guide étape par étape pour extraire des données de Redfin avec Python
Étape 1 : Configurer votre environnement
Installez Python. Assurez-vous que Python est bien installé sur votre système. Si ce n'est pas le cas, téléchargez-le et installez-le depuis le site officiel de Python.
Installez les bibliothèques requises. Vous aurez besoin de quelques bibliothèques Python pour faciliter le scraping. Installez-les à l'aide de pip. 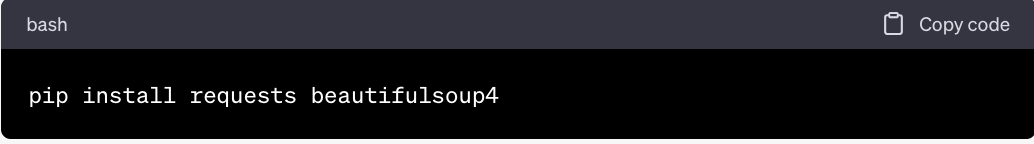
Étape 2 : Identifiez les URL autorisées
Voici une sélection d'URL de recherche autorisées tirées du fichier robots.txt de Redfin :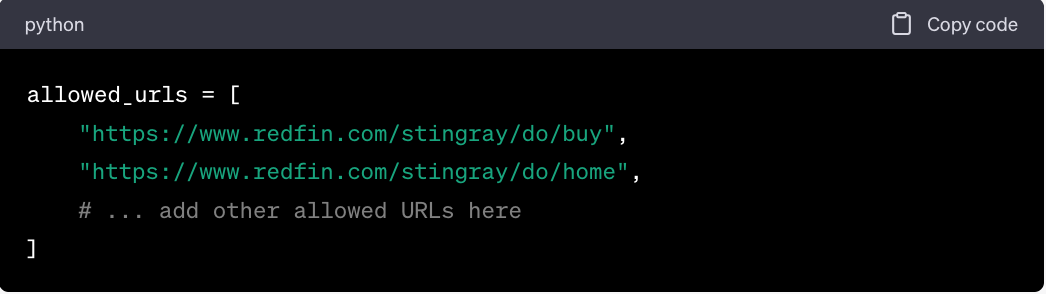
Étape 3 : Écrire le programme de scraping
Importer les bibliothèques nécessaires 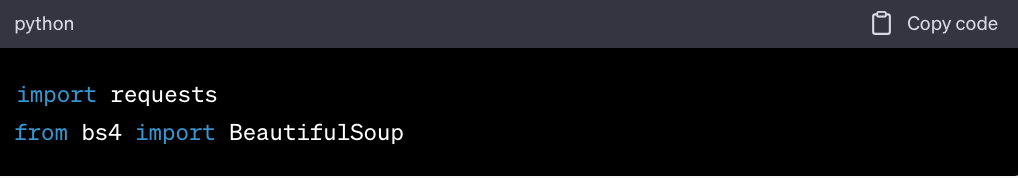
Définir la fonction de scraping 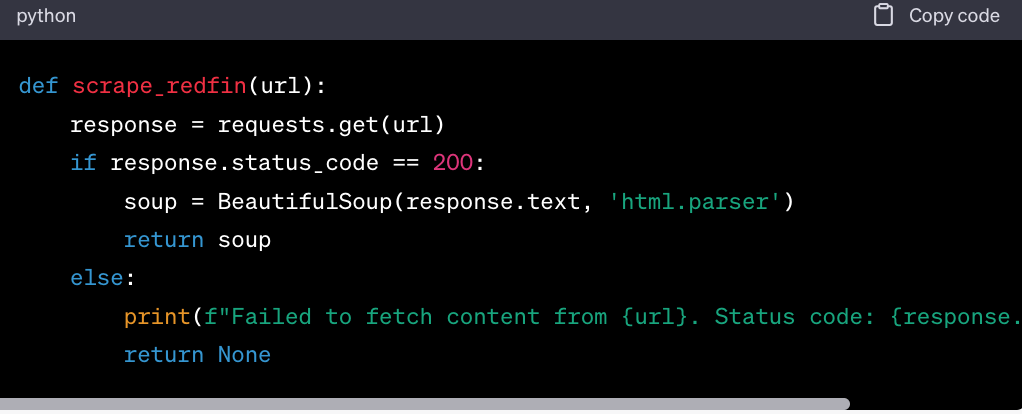
Parcourir les URL autorisées et effectuer le scraping 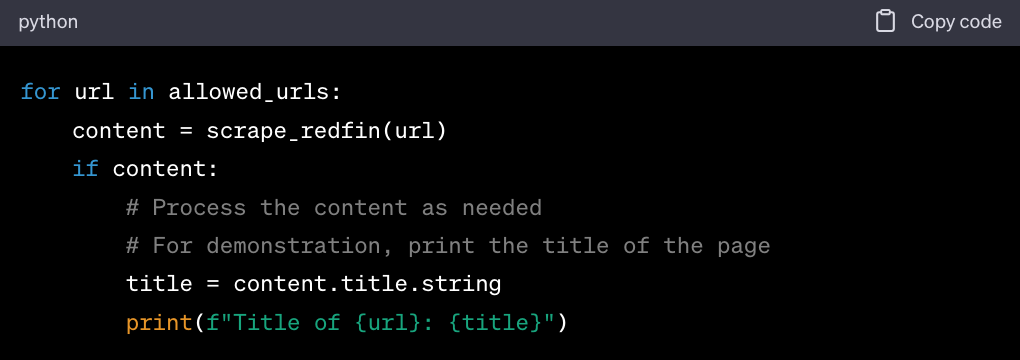
Étape 4 : Traiter et stocker les données
Une fois le contenu extrait, vous pouvez le traiter selon vos besoins. Par exemple, vous pouvez extraire des éléments spécifiques, nettoyer les données ou les stocker dans une base de données ou un fichier.
Extraire les données. Utilisez les fonctions de BeautifulSoup telles que find(), find_all(), etc., pour extraire des données spécifiques du contenu récupéré.
Nettoyer les données. Assurez-vous que les données sont au format souhaité, supprimez les caractères indésirables ou les espaces, et traitez les données manquantes ou incohérentes.
Stocker les données. En fonction de vos besoins, vous pouvez stocker les données dans une base de données, les enregistrer dans un fichier CSV ou les sauvegarder dans tout autre format souhaité.
Comment utiliser Scrapy pour collecter des données sur Redfin
Étape 1 : Configurer votre environnement
Installez Python. Si ce n'est pas déjà fait, téléchargez et installez Python depuis le site officiel de Python.
Installez Scrapy.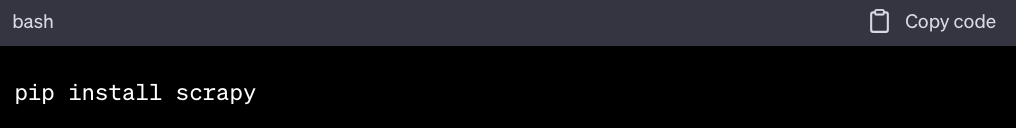
Étape 2 : Créer un projet Scrapy
Ouvrez votre terminal ou votre invite de commande.
Accédez au répertoire dans lequel vous souhaitez créer votre projet Scrapy.
Exécutez la commande suivante :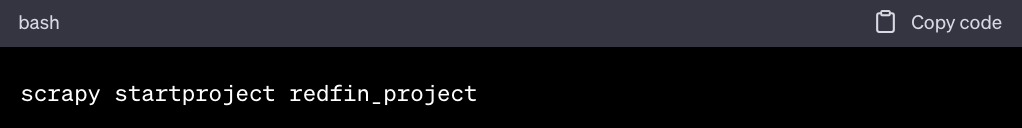
Étape 3 : Définir le spider
Accédez au répertoire « spiders » situé dans le répertoire « redfin_project » :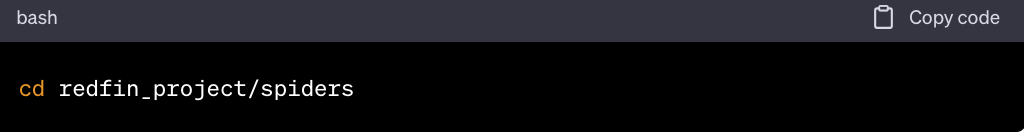
Créez un nouveau fichier nommé « redfin_spider.py ».
Ouvrez le fichier « redfin_spider.py » dans votre éditeur de texte préféré et ajoutez le code suivant : 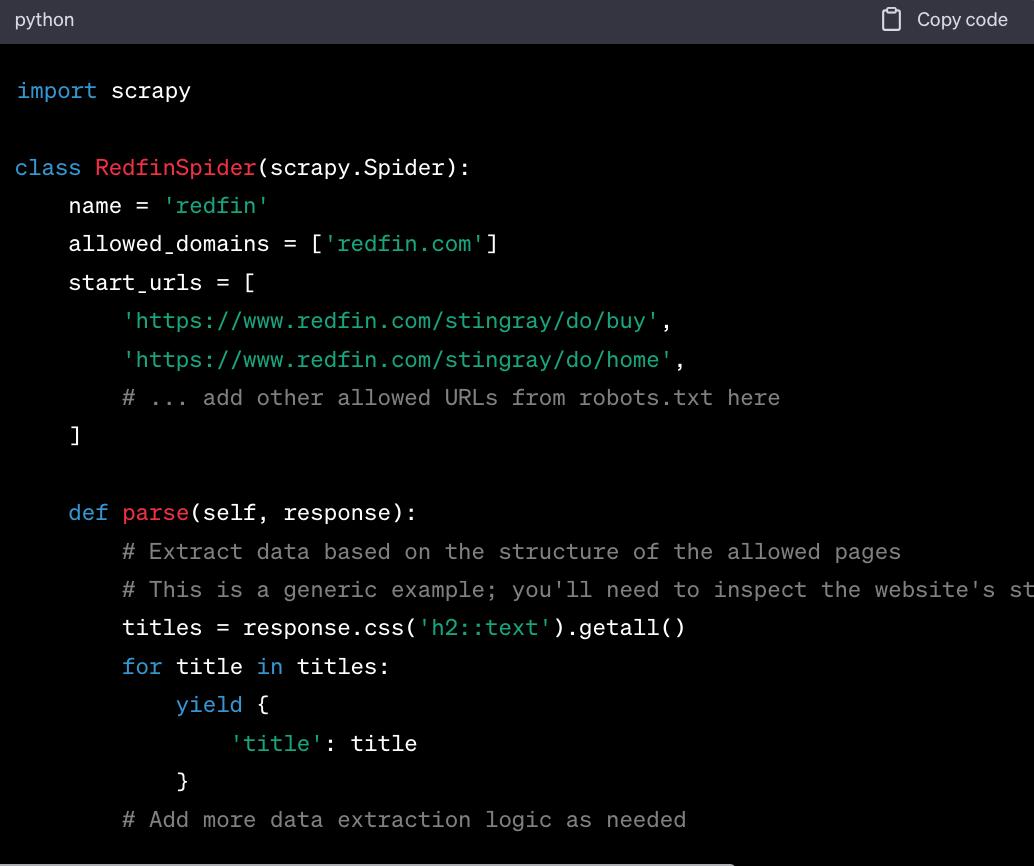
Étape 4 : Configurer les paramètres de Scrapy
Revenez à la racine de votre projet Scrapy (redfin_project).
Ouvrez le fichier settings.py dans un éditeur de texte.
Modifiez ou ajoutez les paramètres suivants afin de respecter la politique de Redfin en matière de robots.txt et d’éviter d’être banni :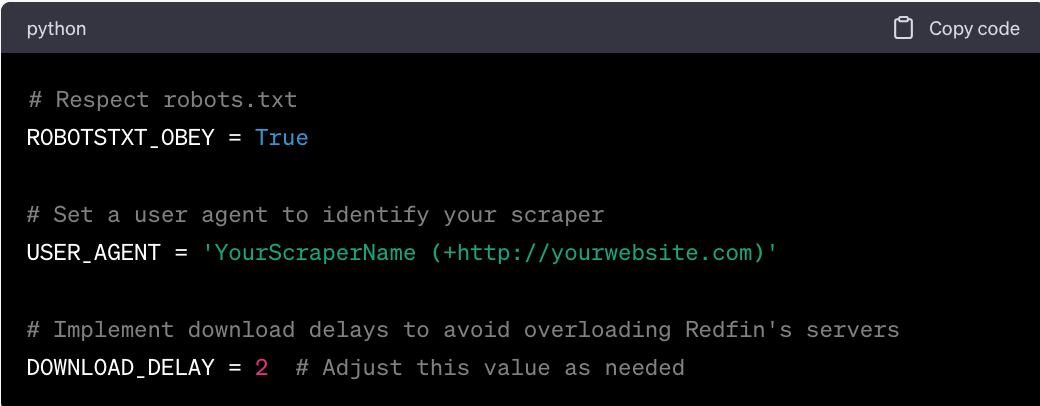
Étape 5 : Lancer le spider
Ouvrez votre terminal ou votre invite de commande.
Accédez au répertoire racine de votre projet Scrapy (redfin_project).
Lancez le spider à l’aide de la commande suivante : 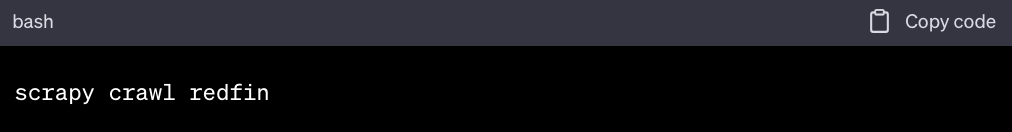
Étape 6 : Enregistrer les données extraites
Par défaut, Scrapy affiche les données extraites dans la console. Si vous souhaitez enregistrer les données dans un fichier :
Modifiez la commande comme suit : 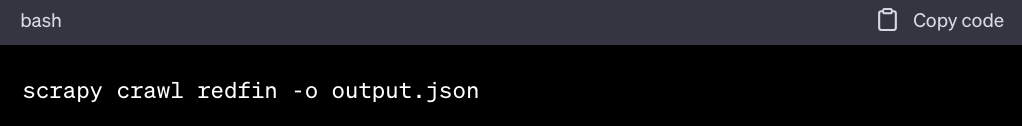
Cela permettra d'enregistrer les données extraites dans un fichier nommé « output.json » au format JSON. Vous pouvez également utiliser d'autres formats, tels que le CSV, en modifiant l'extension du fichier.
Utiliser Geonode Scraper API pour extraire des données de Redfin sans se faire bannir
Étape 1 : Configurer votre environnement
Installer Python : si ce n'est pas déjà fait, téléchargez et installez Python depuis le site officiel de Python.
Installer les bibliothèques requises : vous aurez besoin de la bibliothèque requests pour effectuer des appels API vers l'API de Geonode : Scraper API: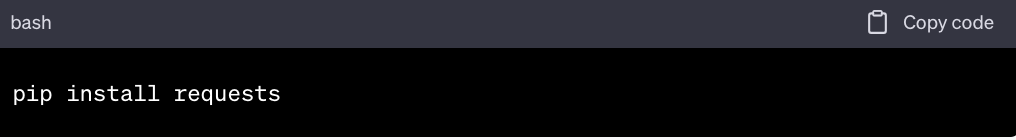
Étape 2 : Obtenir une clé API d’Geonode
- Inscrivez-vous ou connectez-vous sur Geonode.
- Accédez aux paramètres de votre compte ou à votre tableau de bord pour obtenir votre clé API. Cette clé sera nécessaire pour l’authentification lors de l’envoi de requêtes à l’Scraper API.
Étape 3 : Identifier les URL autorisées par Redfin
Voici une liste partielle des URL autorisées pour le scraping :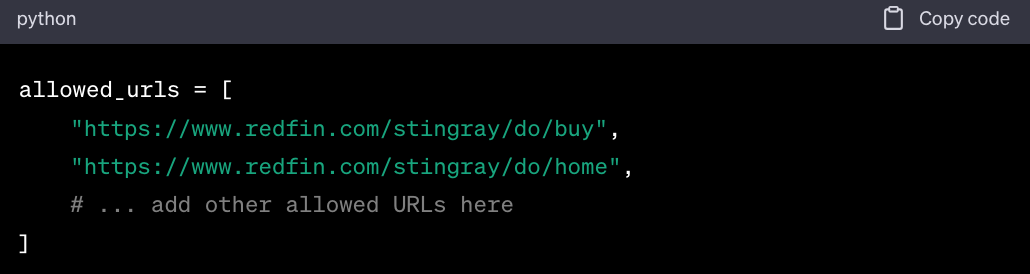
Étape 4 : Écrire le script de scraping
Importer les bibliothèques nécessaires :
Définir la fonction de scraping : 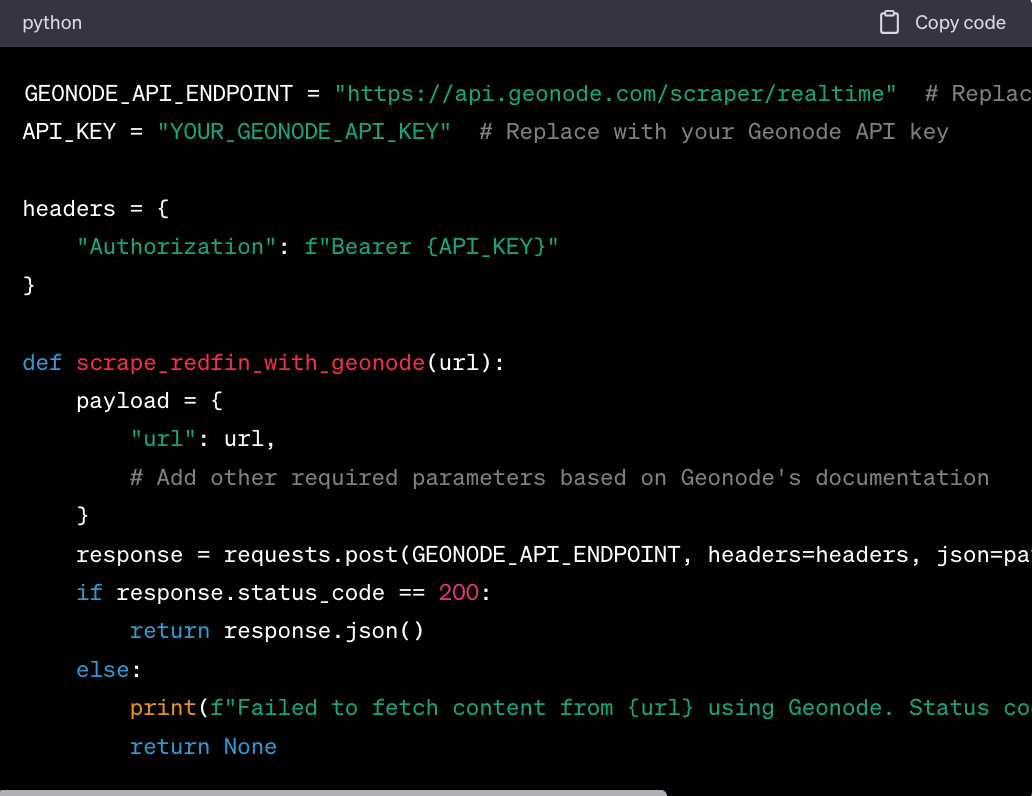
Parcourir les URL autorisées et effectuer le scraping :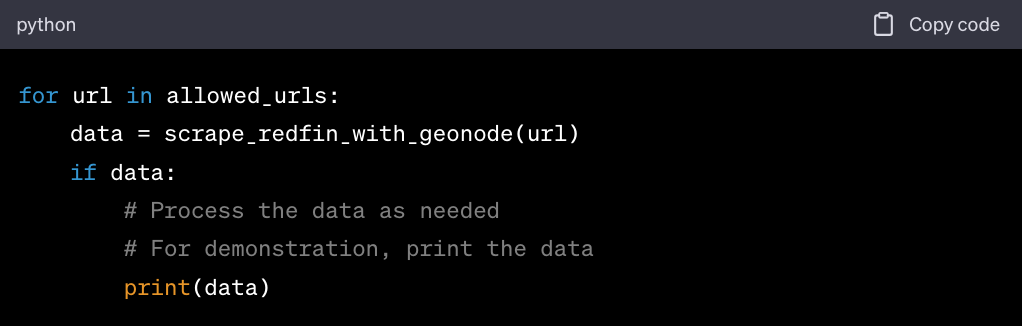
Étape 5 : Traiter et stocker les données
Une fois le contenu extrait, vous pouvez le traiter selon vos besoins. Vous pouvez par exemple extraire des données spécifiques, nettoyer les données ou les stocker dans une base de données ou un fichier.
- Extraire les données. En fonction de la structure des données renvoyées par Geonode, vous devrez peut-être les analyser pour extraire les informations souhaitées.
- Nettoyer les données. Assurez-vous que les données sont au format souhaité, supprimez les caractères indésirables ou les espaces vides, et traitez les données manquantes ou incohérentes.
- Enregistrer les données. En fonction de vos besoins, vous pouvez enregistrer les données dans une base de données, les exporter vers un fichier CSV ou les sauvegarder dans tout autre format de votre choix.
Étapes supplémentaires après le scraping
Quel que soit l'outil de scraping Redfin que vous utilisez, veillez à :
-
Vérifier et affiner les données. Après votre premier extraction, examinez les données que vous avez collectées. Assurez-vous qu’elles sont exactes et complètes.
Affinez votre logique d’extraction si nécessaire pour récupérer les données manquantes ou améliorer la qualité des données.
-
Effectuez un suivi régulier. Si vous prévoyez d’extraire régulièrement des données de Redfin, surveillez les performances de votre outil d’extraction et les données qu’il collecte.
Les sites web peuvent modifier leur structure, ce qui pourrait perturber le fonctionnement de votre outil d’extraction. Un suivi régulier vous aidera à détecter et à résoudre rapidement tout problème éventuel.
Défis et solutions liés à l'utilisation des outils de collecte de données immobilières
Le web scraping est un outil puissant, mais il comporte son lot de défis, en particulier lorsqu'il s'agit de cerner des sites web complexes comme Redfin.
Gestion du contenu dynamique
Le défi : les sites web modernes comme Redfin chargent leur contenu de manière dynamique à l'aide de JavaScript. Les outils de scraping traditionnels, qui se contentent de récupérer le code source HTML, risquent de passer à côté de ce contenu chargé dynamiquement.
Solutions :
-
Outils d’automatisation de navigateur. Des outils tels que Selenium peuvent simuler le comportement d’un véritable navigateur, ce qui vous permet d’extraire du contenu chargé dynamiquement.
Avec Selenium, vous pouvez attendre le chargement d’éléments spécifiques, interagir avec des menus déroulants et même faire défiler les pages pour déclencher le chargement du contenu.
-
Inspecter les appels réseau. À l’aide des outils de développement du navigateur, inspectez les appels réseau effectués par le site web. Souvent, le contenu dynamique est chargé via des appels AJAX vers des API internes.
Si vous parvenez à identifier ces appels, vous pouvez leur demander directement des données, ce qui vous permettra éventuellement d’obtenir des données dans un format structuré tel que JSON.
Contourner les mesures anti-scraping
Le défi : Redfin peut mettre en place des mesures anti-scraping pour empêcher les bots automatisés d’accéder à ses données. Il peut s’agir de CAPTCHA, de limitations de débit, voire de blocages d’adresses IP.
Solutions :
-
Respecter le fichier robots.txt. Commencez toujours par consulter le fichier robots.txt du site web. Ce fichier fournit des directives sur les parties du site auxquelles les robots d’indexation peuvent accéder.
-
Rotation des user-agents. Alternez les user-agents pour imiter différents navigateurs et appareils. Cela peut aider à contourner les restrictions ciblant des user-agents spécifiques.
-
Rotation des adresses IP. Utilisez Geonode des proxys résidentiels pour alterner les adresses IP. Si une adresse IP est bannie, le scraper peut passer à une autre.
-
Limitation du débit. Introduisez des délais entre les requêtes pour éviter d’en envoyer trop en peu de temps. Cela permet d’éviter les blocages d’adresses IP et de respecter les serveurs du site web.
-
Gestion des CAPTCHA. Des outils tels que 2Captcha ou Anti-Captcha proposent des services permettant de résoudre les CAPTCHA. Vous pouvez également envisager d’utiliser des outils d’automatisation du navigateur pour résoudre manuellement les CAPTCHA lorsqu’ils apparaissent.
Garantir l’exactitude et l’intégrité des données
Le défi : le web scraping peut parfois aboutir à des données incomplètes ou inexactes, en particulier si la structure du site web change ou s’il existe des incohérences dans la manière dont les données sont présentées.
Solutions :
-
Surveillance régulière. Surveillez en permanence les performances de votre scraper. Si vous constatez des données manquantes ou inexactes, cela peut être dû à des modifications de la structure du site web.
-
Gestion des erreurs. Intégrez une gestion robuste des erreurs dans votre outil de scraping. Si celui-ci rencontre une erreur, il doit être capable de l'enregistrer et de passer à la suite ou de réessayer la requête, afin de garantir que des problèmes temporaires n’entraînent pas de perte de données.
-
Validation des données. Après le scraping, validez les données pour vous assurer qu’elles répondent à certains critères ou formats. Par exemple, si vous récupérez les prix de biens immobiliers, assurez-vous que les données sont numériques et se situent dans une fourchette raisonnable.
-
Sauvegarde. Conservez toujours des sauvegardes de vos données récupérées. Si vous constatez un problème avec votre scraper ou les données qu’il collecte, disposer de sauvegardes vous permettra de revenir à un état antérieur.
En comprenant et en relevant ces défis, vous pouvez vous assurer que vos opérations de web scraping sont plus efficaces, plus éthiques et mieux adaptées à l’environnement web en constante évolution.
L'évolution du web scraping
À ses débuts, le web scraping était un simple moyen d'extraire du contenu statique à partir de pages web.
Les premiers sites web étaient simples, et leur extraction ne nécessitait guère plus que de télécharger le code HTML et de l'analyser.
Aujourd’hui, les sites web comme Redfin sont dynamiques, interactifs et regorgent de fonctionnalités. Ils chargent du contenu à la volée, réagissent aux interactions des utilisateurs et vont même jusqu’à personnaliser le contenu en fonction du comportement de ces derniers.
Cette évolution a rendu le scraping plus difficile, mais aussi plus gratifiant. Des outils et techniques modernes, allant de l’automatisation des navigateurs à l’apprentissage automatique, ont vu le jour pour relever ces défis.
L’avenir de l’extraction de données immobilières
Le marché immobilier est dynamique, les annonces et les tendances des prix évoluant rapidement. La demande de données en temps réel et d’informations exploitables stimulera les innovations dans les technologies de scraping, favorisant une extraction de données plus rapide et plus fréquente.
À mesure que les données gagneront en valeur, les considérations juridiques et éthiques liées à leur extraction prendront une place prépondérante.
Nous pouvons nous attendre à des directives et réglementations plus claires régissant ce qui peut et ne peut pas être extrait, garantissant ainsi que l’extraction des données respecte la vie privée et les droits de propriété intellectuelle.
Respecter l'éthique
Le web scraping est un outil puissant, mais cette puissance s'accompagne de la responsabilité de l'utiliser de manière éthique. Lorsque vous effectuez du scraping sur des sites web tels que Redfin pour répondre à vos différents besoins, privilégiez toujours le respect, l'intégrité et l'équité.
En pratiquant le web scraping, vous vous assurez que la recherche de données ne compromet jamais les valeurs qui unissent la communauté numérique.

