redfin.com などのプラットフォームから不動産データにアクセスすることは、多くの企業にとって不可欠となっています。
不動産アナリスト、データサイエンティスト、あるいは単にテクノロジー愛好家であるかに関わらず、Redfinからデータをスクレイピングする方法を理解することは、計り知れないほどの洞察をもたらすでしょう。
この包括的なガイドでは、Redfinから効率的かつ倫理的にデータをスクレイピングするためのベストプラクティス、ツール、および手法について詳しく解説します。

Maricor Bunal
更新日:2026年10月7日
公開日:2023年8月29日
Redfin.comのデータスクレイピングに関する究極のガイドをご紹介します。貴重な不動産データをスムーズに抽出するための、専門家の知見、ツール、テクニックを詳しく解説します。
redfin.com などのプラットフォームから不動産データにアクセスすることは、多くの企業にとって不可欠となっています。
不動産アナリスト、データサイエンティスト、あるいは単にテクノロジー愛好家であるかに関わらず、Redfinからデータをスクレイピングする方法を理解することは、計り知れないほどの洞察をもたらすでしょう。
この包括的なガイドでは、Redfinから効率的かつ倫理的にデータをスクレイピングするためのベストプラクティス、ツール、および手法について詳しく解説します。
Redfinは、販売中の住宅物件情報、不動産市場データ、その他の関連サービスを提供する、著名な不動産ウェブサイトです。
2004年に設立されたRedfinは、不動産業界をリードするプラットフォームの一つへと成長し、物件の種類、立地、価格帯、寝室の数など、さまざまな条件に基づいて物件を検索できる使いやすいインターフェースをユーザーに提供しています。
Redfinの特徴の一つは、詳細な物件ページです。ここには、高解像度の写真、物件の履歴、近隣の詳細情報など、物件に関する包括的な情報が掲載されています。
さらに、Redfinは住宅の推定市場価格を算出する「Redfin Estimate」や、特定の近隣地域やエリアの物件を探索できるインタラクティブな地図検索機能などのツールも提供しています。
不動産仲介業者、エージェント、あるいは物件情報、市場動向、その他の不動産詳細に関するデータを収集したい個人にとって、Redfinは貴重な情報源となっています。
不動産データは単なる数字や物件情報にとどまらず、市場の鼓動そのものを映し出すものです。
掲載されているすべての物件、価格の変動、そして成約の1件1件が、地域社会、経済、消費者の行動に関する物語を語っています。
主要な不動産プラットフォームの一つであるRedfinからデータをスクレイピングすることで、不動産エージェントや企業は、貴重なデータの宝庫にアクセスできます。
このデータは、物件価値、市場動向、地域の嗜好に関する洞察を提供してくれます。
データ主導の現代において、タイムリーかつ正確な不動産情報を得ることは、投資家から都市計画担当者まで、多くの関係者にとって状況を一変させる要因となり得ます。
市場分析は、情報に基づいた意思決定を行おうとするあらゆる企業や投資家にとって不可欠です。Redfinの不動産データを活用することで、アナリストは以下のことが可能になります:
スクレイピングは豊富なデータを提供しますが、責任を持って取り組むことが不可欠です。考慮すべき倫理的ガイドラインを以下に示します:
robots.txt を尊重する。 Redfinのウェブサイトにあるこのファイルは、サイトのどの部分にアクセスし、スクレイピングできるかを示しています。これを無視することは非倫理的であるだけでなく、法的措置につながる可能性もあります。
サーバーへの過度な負荷を避ける。 短時間に過度のリクエストを送信すると、Redfinサイトの動作が遅くなったり、クラッシュしたりする可能性があります。 サイトの運営に支障をきたさないよう、リクエストの間隔を空けることが不可欠です。
データのプライバシー。 特にスクレイピングで取得した Redfin データ、とりわけ個人情報が含まれている場合は、その取り扱いには常に細心の注意を払ってください。こうしたデータを悪用すると、深刻な法的および倫理的な結果を招く恐れがあります。
Webスクレイピングは、Redfinなどのオンライン情報源から貴重な知見を抽出するために欠かせない手法となっています。ここでは、それぞれ独自の強みと制限を持つ、利用可能なツールや手法をいくつか紹介します。
Requestsがウェブページを取得し、BeautifulSoupがHTMLコンテンツを解析します。手動によるスクレイピングとは、ウェブサイトからデータを手作業でコピーし、目的の形式やツールに貼り付ける作業のことです。
スクリーンスクレイピングとも呼ばれるこの方法は、手間と時間がかかりますが、小規模な作業や、自動スクレイピングが実施できない場合に利用できます。
Python をインストールします。 システムに Python がインストールされていることを確認してください。インストールされていない場合は、Python の公式サイトからダウンロードしてインストールしてください。
必要なライブラリをインストールします。 スクレイピングを行うには、いくつかのPythonライブラリが必要です。pipを使用してインストールしてください。
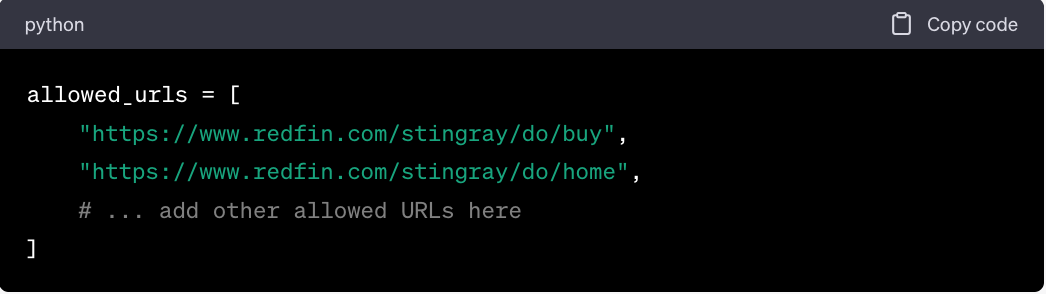
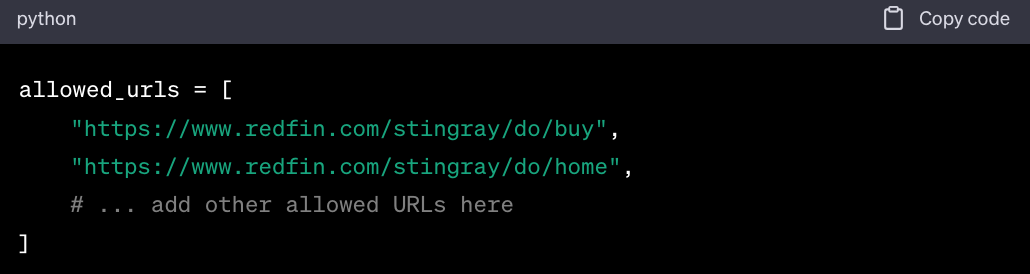
以下は、Redfinのrobots.txtに記載されている、許可された検索URLの一部です:
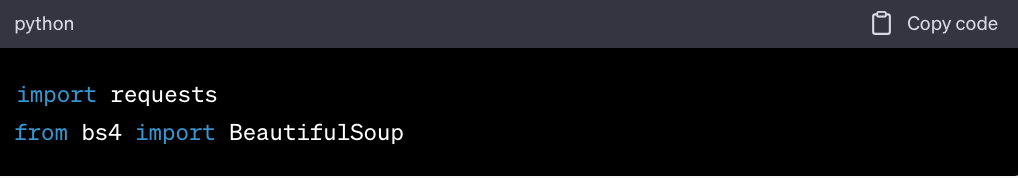
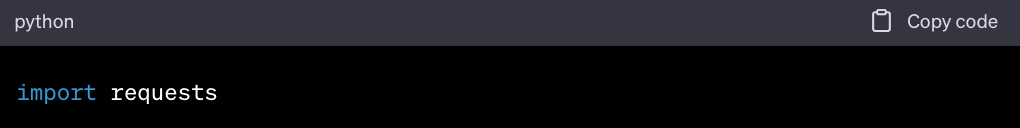
必要なライブラリをインポートする
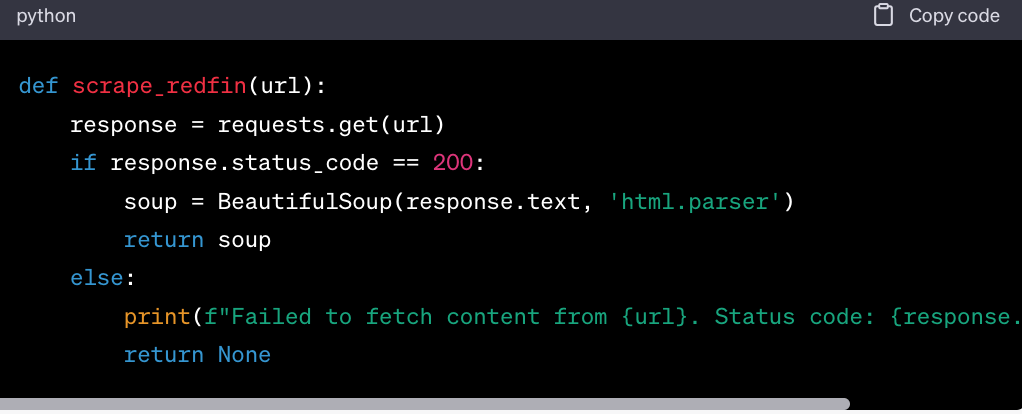
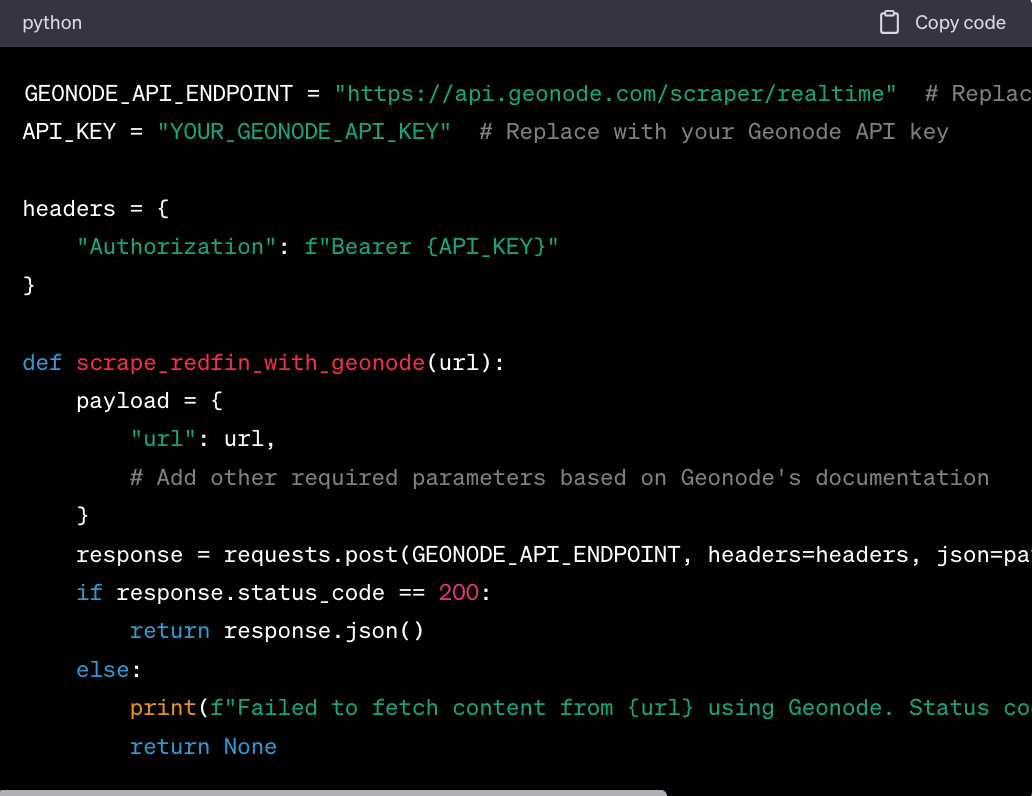
スクレイパー関数を定義する
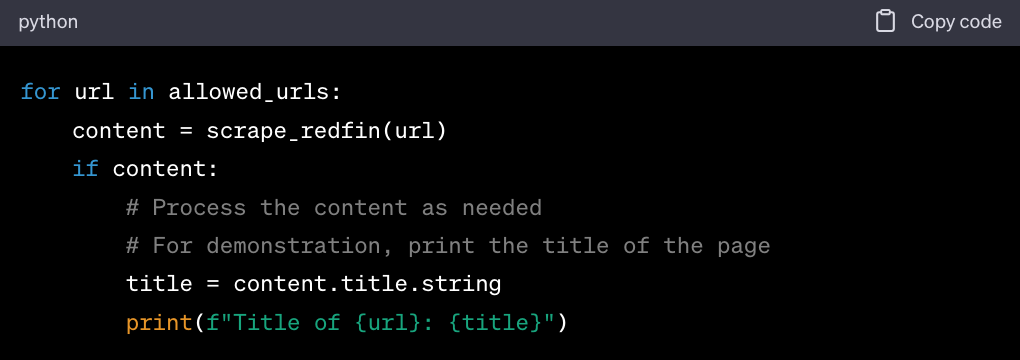
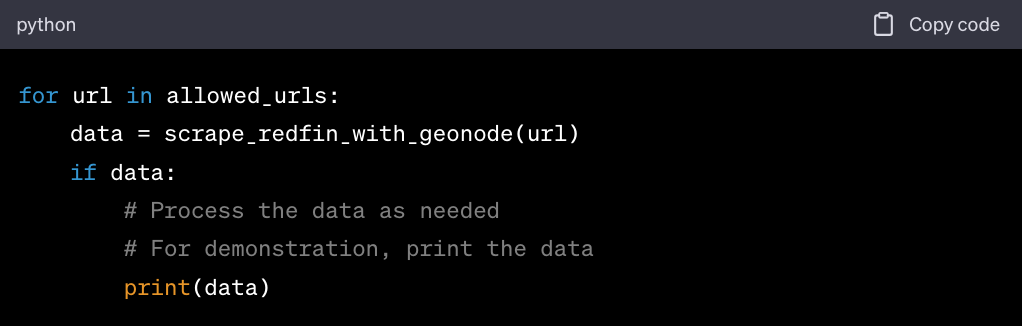
許可された URL を順に処理してスクレイピングを行う
コンテンツをスクレイピングしたら、必要に応じて処理を行います。例えば、特定のデータポイントを抽出したり、データをクレンジングしたり、データベースやファイルに保存したりすることができます。
データの抽出。 BeautifulSoupのfind()、find_all()などの関数を使用して、スクレイピングしたコンテンツから特定のデータを抽出します。
データのクリーニング。 データが所望の形式になっていることを確認し、不要な文字や空白を削除し、欠落しているデータや不整合なデータに対処します。
データの保存。 必要に応じて、データをデータベースに保存したり、CSVファイルに書き込んだり、その他の任意の形式で保存したりできます。
Python をインストールします。 まだインストールしていない場合は、Python の公式サイト から Python をダウンロードしてインストールしてください。
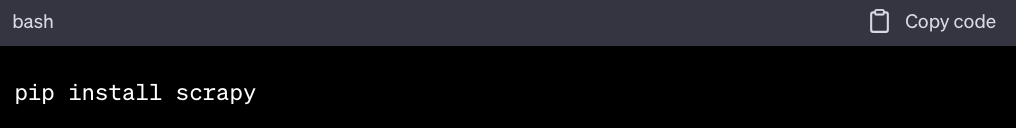
Scrapyをインストールします。
ターミナルまたはコマンドプロンプトを開きます。
Scrapyプロジェクトを作成したいディレクトリに移動します。
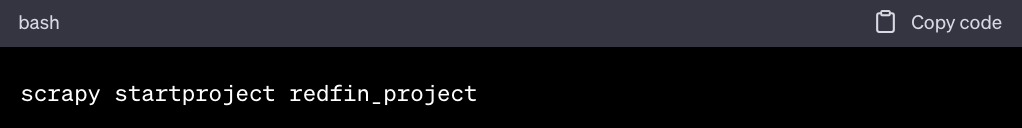
次のコマンドを実行します:
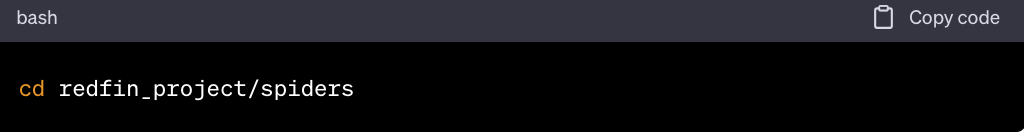
redfin_project内のspidersディレクトリに移動します:
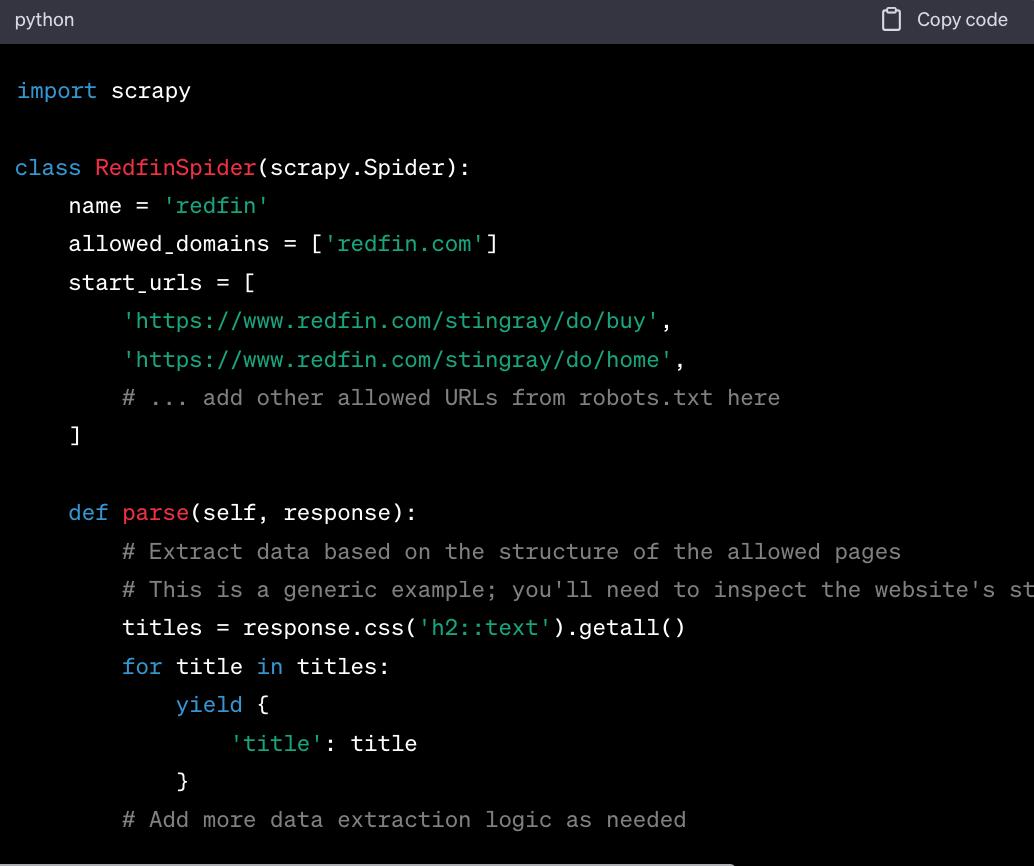
redfin_spider.pyという名前の新しいファイルを作成します。
お好みのテキストエディタでredfin_spider.pyを開き、以下のコードを追加します:
Scrapy プロジェクトのルートディレクトリ(redfin_project)に戻ります。
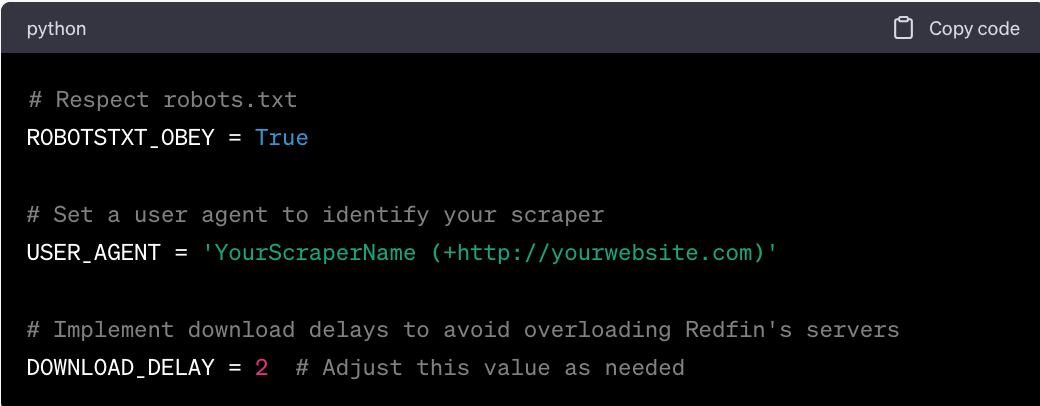
テキストエディタで settings.py を開きます。
Redfin の robots.txt に準拠し、利用停止処分を避けるために、以下の設定を変更または追加してください:
ターミナルまたはコマンドプロンプトを開きます。
Scrapy プロジェクトのルートディレクトリ(redfin_project)に移動します。
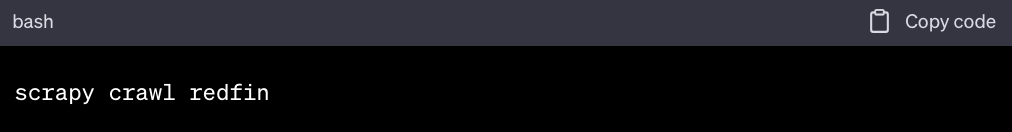
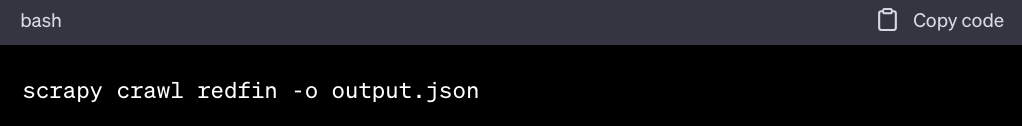
次のコマンドでスパイダーを実行します:
デフォルトでは、Scrapyはスクレイピングしたデータをコンソールに出力します。データをファイルに保存したい場合は:
コマンドを次のように変更してください:
これにより、スクレイピングしたデータが「output.json」という名前のファイルにJSON形式で保存されます。ファイル拡張子を変更することで、CSVなどの他の形式を使用することも可能です。
Pythonのインストール: まだインストールしていない場合は、Pythonの公式サイトからPythonをダウンロードしてインストールしてください。
必要なライブラリのインストール: GeonodeのScraper API: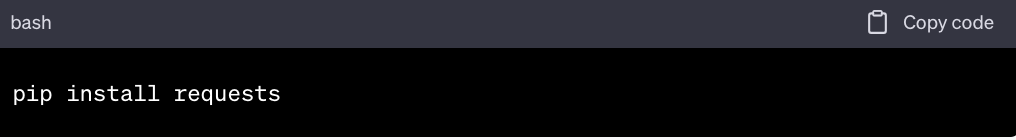
requestsライブラリが必要です。
以下は、スクレイピングが許可されているURLの一部です:
必要なライブラリのインポート:
スクレイパー関数の定義:
許可された URL をループ処理してスクレイピング:
コンテンツをスクレイピングしたら、必要に応じて処理を行います。例えば、特定のデータポイントを抽出したり、データをクレンジングしたり、データベースやファイルに保存したりすることができます。
使用するRedfinスクレイピングツールに関わらず、必ず以下の点を確認してください:
データを確認・精査する。 最初のスクレイピングが完了したら、収集したデータを確認してください。データが正確かつ完全であることを確認してください。
必要に応じてスクレイピングロジックを調整し、取り逃したデータを取得したり、データの品質を向上させたりしてください。
定期的なモニタリングを行う。 Redfinから定期的にデータをスクレイピングする予定の場合は、スクレイパーのパフォーマンスと収集されたデータをモニタリングしてください。
ウェブサイトの構造が変更されると、スクレイパーが正常に動作しなくなる可能性があります。定期的なモニタリングを行うことで、問題を早期に発見し、修正することができます。
ウェブスクレイピングは強力なツールですが、特にRedfinのような複雑なウェブサイトを対象とする場合、特有の課題も伴います。
課題:Redfinのような現代のウェブサイトは、JavaScriptを使用してコンテンツを動的に読み込みます。 HTMLソースのみを取得する従来のスクレイピングツールでは、この動的に読み込まれるコンテンツを取り逃してしまう可能性があります。
解決策:
ブラウザ自動化ツール。 Seleniumのようなツールは、実際のブラウザの動作をシミュレートできるため、動的に読み込まれるコンテンツをスクレイピングすることが可能です。
Selenium を使えば、特定の要素が読み込まれるのを待ったり、ドロップダウンメニューを操作したり、ページをスクロールしてコンテンツの読み込みをトリガーしたりすることも可能です。
ネットワークリクエストの調査。 ブラウザの開発者ツールを使用して、ウェブサイトが行うネットワークリクエストを調査します。 多くの場合、動的コンテンツは内部APIへのAJAX呼び出しを通じて読み込まれます。
これらの呼び出しを特定できれば、そこから直接データをリクエストでき、JSONのような構造化された形式でデータを入手できる可能性があります。
課題:Redfinは、自動化されたボットによるデータへのアクセスを防ぐため、スクレイピング対策を採用している可能性があります。これには、CAPTCHA、レート制限、さらにはIPブロックなどが含まれます。
解決策:
robots.txt. を尊重する まず、ウェブサイトの robots.txt ファイルを確認することから始めましょう。 このファイルには、ウェブクローラーがアクセスできるサイト内の領域に関するガイドラインが記載されています。
ユーザーエージェントのローテーション。 ユーザーエージェントをローテーションさせ、さまざまなブラウザやデバイスを模倣します。これにより、特定のユーザーエージェントを対象とした制限を回避できる場合があります。
IPローテーション。 Geonode 住宅用プロキシ を使用して、IPアドレスをローテーションさせます。あるIPがブロックされても、スクレイパーは別のIPに切り替えることができます。
レート制限。 短時間に過度なリクエストを送信しないよう、リクエスト間に遅延を設けます。 これにより、IPアドレスのブロックを防ぎ、ウェブサイトのサーバーへの配慮を示すことができます。
CAPTCHAの処理。 2CaptchaやAnti-Captchaなどのツールは、CAPTCHAを解くサービスを提供しています。あるいは、CAPTCHAが表示された際に手動で解くために、ブラウザ自動化ツールの使用を検討してください。
課題:ウェブスクレイピングでは、特にウェブサイトの構造が変更された場合や、データの表示方法に一貫性がない場合、不完全または不正確なデータが得られることがあります。
解決策:
定期的な監視。 スクレイパーのパフォーマンスを継続的に監視してください。データの欠落や不正確さに気づいた場合は、ウェブサイトの構造変更が原因である可能性があります。
エラー処理。 スクレイパーに堅牢なエラー処理を実装します。スクレイパーがエラーに遭遇した場合、それをログに記録して処理を続行するか、リクエストを再試行できるようにし、一時的な問題によってデータが失われることのないようにします。
データの検証。 スクレイピング後、データが特定の基準や形式を満たしているか検証します。例えば、不動産価格をスクレイピングする場合は、データが数値であり、妥当な範囲内にあることを確認します。
バックアップ。 スクレイピングしたデータのバックアップは常に保持してください。 スクレイパーや収集したデータに問題が見つかった場合、バックアップがあれば以前の状態に戻すことができます。
これらの課題を理解し、適切に対処することで、ウェブスクレイピングの取り組みをより成功させ、倫理的かつ、絶えず変化し続けるウェブ環境に対しても強靭なものにすることができます。
ウェブスクレイピングは、当初、ウェブページから静的なコンテンツを抽出するための単純な手段として始まりました。
初期のウェブサイトは単純明快であり、スクレイピングにはHTMLをダウンロードして解析するだけで事足りた。
今日、Redfinのようなウェブサイトは動的でインタラクティブであり、豊富な機能を備えています。コンテンツをオンザフライで読み込み、ユーザーの操作に応答し、さらにはユーザーの行動に基づいてコンテンツをパーソナライズすることさえ可能です。
こうした進化により、スクレイピングはより困難になりましたが、その分、得られる成果も大きくなりました。ブラウザの自動化から機械学習に至るまで、最新のツールや技術がこれらの課題に対応するために登場しています。
不動産市場はダイナミックであり、物件情報や価格動向は急速に変化しています。リアルタイムのデータや実用的なインサイトへの需要が、スクレイピング技術の革新を牽引し、より高速かつ頻繁なデータ抽出を促進していくでしょう。
データの価値が高まるにつれ、データ抽出をめぐる法的・倫理的な考慮事項が前面に出てくるでしょう。
何がスクレイピングの対象となり、何が対象とならないかを規定する、より明確なガイドラインや規制が策定され、データ抽出がプライバシーや知的財産権を尊重するよう確保されることが予想されます。
ウェブスクレイピングは強力なツールですが、その力には倫理的に使用するという責任が伴います。Redfinなどのウェブサイトをさまざまな目的でスクレイピングする際は、常に敬意、誠実さ、公平性を最優先にしてください。
スクレイピングを行うことで、データの収集が、デジタルコミュニティを結びつける価値観を決して損なうことのないようにすることができます。