

Scrapy adalah kerangka kerja perayapan web sumber terbuka yang dapat digunakan secara gratis oleh siapa saja di internet. Scrapy terutama digunakan untuk perayapan web dan penggalian data web. Ini merupakan cara yang cepat dan mudah untuk mengekstrak data dari halaman web mana pun, dan saat ini Zyte yang mengelolanya.
Menginstal Scrapy
Untuk menginstal Scrapy, Anda memerlukan Python versi 3.7 atau yang lebih baru. Disarankan juga untuk menginstalnya di lingkungan virtual (virtualenv) khusus, sehingga Anda dapat menghindari konflik yang mungkin timbul dengan paket-paket sistem Anda.
Unduh Scrapy di platform pilihan Anda.
Untuk menginstal Scrapy, Anda perlu menginstal Anaconda atau Miniconda, buka Python, lalu jalankan perintah berikut:
conda install -c conda-forge scrapy
Sebagai alternatif, Anda juga dapat menjalankan:
pip install Scrapy
Jika Anda menggunakan sistem Ubuntu, maka Anda perlu menginstal semua dependensi berikut terlebih dahulu:
sudo apt-get install python3 python3-dev python3-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
Jika Anda menggunakan sistem macOS, Anda perlu menginstal alat baris perintah Xcode. Buka jendela terminal dan jalankan perintah berikut:
xcode-select --install
Selamat! Anda telah berhasil menginstal Scrapy di perangkat Anda. Sekarang, kita dapat mencoba melakukan web crawling pada sebuah situs web dan mengekstrak datanya.
Memulai Proyek Scrapy
Untuk memulai proyek Scrapy baru, Anda perlu menentukan direktori tempat kode Anda akan disimpan. Jalankan perintah berikut:
scrapy startproject scrapetest
Menjalankan perintah ini akan membuat direktori bernama “scrapetest” dan di dalamnya akan terdapat:
_scrapetest/ scrapy.cfg # berkas konfigurasi
scrapetest/             # modul Python proyek, Anda akan mengimpor kode Anda dari sini
    __init__.py

    items.py

    middlewares.py

    pipelines.py

    settings.py

    spiders/          # direktori tempat Anda nantinya akan meletakkan spider Anda
        __init__.py
_
Setelah Anda memulai proyek Scrapy, kini Anda perlu membuat Spider. Spider diperlukan karena inilah yang digunakan Scrapy untuk mengekstrak informasi dari halaman web. Sebagai contoh, kita akan melakukan scraping pada situs web “quotes.toscrape.com”.
Pertama-tama, Anda perlu menjalankan kode berikut:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" # Nama Spider harus unik untuk setiap Spider yang Anda buat
def start_requests(self):
    urls = [
        'https://quotes.toscrape.com/page/1/',
        # Ubah URL ini menjadi
halaman web yang ingin Anda scrape 'https://quotes.toscrape.com/page/2/', ] for url in urls: yield scrapy.Request(url=url, callback=self.parse)
def parse(self, response):
    page = response.url.split("/")[-2]
    filename = f'quotes-{page}.html'
    with open(filename, 'wb') as f:
        f.write(response.body)
    self.log(f'Berkas {filename} telah disimpan')
_
Agar spider mulai merayapi, Anda perlu menjalankan:
scrapy crawl test
Anda kemudian akan mendapatkan output yang menunjukkan bahwa Anda telah merayapi situs web “quotes.toscrape.com”.
Jika Anda ingin mengekstrak data tertentu dari halaman web, Anda dapat menggunakan kata kunci Python “yield”, dan menjalankan kode berikut:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', 'https://quotes.toscrape.com/page/2/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }
_
Kode ini mengekstrak teks, penulis, dan tag dari halaman web yang Anda kumpulkan, yang akan ditampilkan di log.
Jika Anda ingin mengumpulkan semua halaman di sebuah situs web, bukan hanya halaman tertentu, maka Anda dapat menjalankan:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }

    next_page = response.css('li.next a::attr(href)').get()
    if next_page is not None:
        next_page = response.urljoin(next_page)
        yield scrapy.Request(next_page, callback=self.parse)
_
Sekarang, Anda perlu menyimpan data yang telah diekstraksi oleh spider. Untuk menyimpan data yang telah di-scrape, cukup jalankan:
scrapy crawl test -O test.json
Jika Anda ingin menambahkan konten baru ke file yang sudah ada, Anda dapat menjalankan kode ini sebagai gantinya:
scrapy crawl quotes -o quotes.jsonl
Selamat! Anda telah selesai mengekstrak dan menyimpan data yang Anda kumpulkan dengan Scrapy. Anda masih dapat menambahkan sesuatu untuk memastikan bahwa pengumpulan data web dengan Scrapy berjalan dengan sukses, yaitu dengan memanfaatkan proxy Scrapy.
Mengonfigurasi Proksi Scrapy
Proksi Scrapy akan menangani semua permintaan web Anda, sehingga situs web mana pun yang Anda scrape hanya akan melihat alamat IP server proksi. Alamat IP Anda akan tersembunyi sepenuhnya. Dengan terus-menerus mengganti alamat IP dan memanfaatkan proksi residensial, situs web akan tertipu sehingga mengira bahwa permintaan Anda berasal dari pengguna asli, bukan hanya seseorang yang menggunakan bot pengikis web seperti Scrapy.
Sebagai contoh, kami akan menggunakan proksi Geonode. Anda dapat langsung menuju bagian “Mendapatkan Detail Server Proksi dengan Geonode” jika Anda belum mendapatkan detail proksi Geonode.
Ada dua metode untuk mengatur proxy di Scrapy.
Metode pertama adalah menggunakan middleware Scrapy yang disebut HTTPProxyMiddleware, yang secara otomatis mengatur parameter proxy Anda sebagai proxy default.
Anda dapat menjalankan:
_def start_requests(self): for url in self.start_urls: return Request(url=url, callback=self.parse, headers={"User-Agent": "My UserAgent"}, meta={"proxy": "premium-residential.geonode.com:9001"}) _
Metode kedua adalah dengan membuat middleware Anda sendiri. Metode ini lebih terisolasi dan memberi Anda kebebasan yang lebih besar.
Anda dapat menjalankan:
_from w3lib.http import basic_auth_header
DOWNLOADER_MIDDLEWARES = { 'myproject.middlewares.CustomProxyMiddleware': 350, 'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 400, }
class CustomProxyMiddleware(object): def process_request(self, request, spider): request.meta[“proxy”] = "premium-residential.geonode.com:9001" request.headers[“Proxy-Authorization”] = basic_auth_header(“geonode_xbYe9H2LYr”, “9806022c-cd4a-4776-a053-73fee44344dd”) _
Selamat! Anda telah menambahkan server proxy saat melakukan scraping pada situs web apa pun dengan Scrapy. Jika Anda ingin memverifikasi apakah proxy Anda berfungsi, Anda dapat mengunjungi https://www.geonode.com/what-is-my-ip.
Mendapatkan Detail Server Proksi Melalui Geonode
Langkah 1. Kunjungi **Geonode
** dan masuk menggunakan akun yang sudah ada atau daftar untuk membuat akun baru.
Langkah 2. Di Halaman Beranda, klik “Layanan Perumahan”.

Langkah 3. Gulir ke bawah hingga Anda melihat “Titik Akhir”.
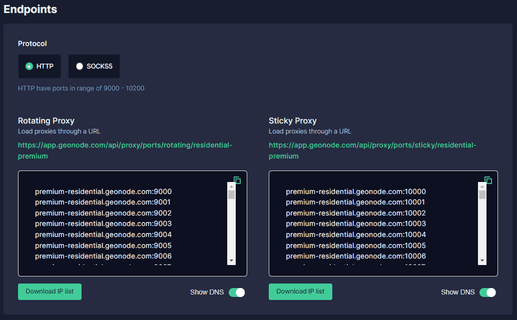
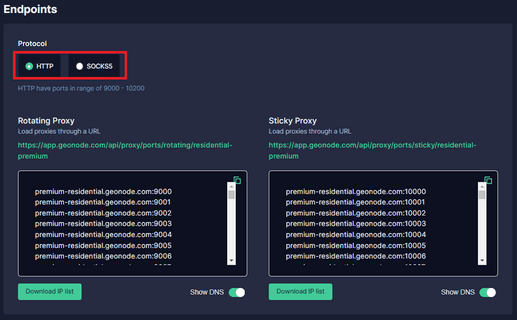
Langkah 4. Pilih “Protokol Proxy” mana yang ingin Anda gunakan: “Protokol HTTP” atau **“[Protokol SOCKS5
](https://geonode.com/blog/beginners-guide-to-socks5-proxies)”**.
Langkah 5. Pilih "Jenis Sesi" yang ingin Anda gunakan: “Proxy Berputar” atau Proxy Sticky.
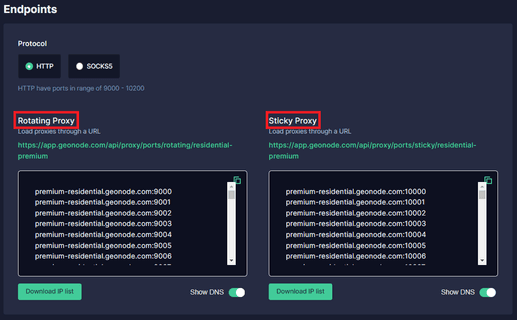
Langkah 6. Pilih proxy mana yang ingin Anda gunakan. Sebagai contoh, kita akan menggunakan proxy yang disorot, yaitu **“premium-residential.geonode
.com:9001”**.
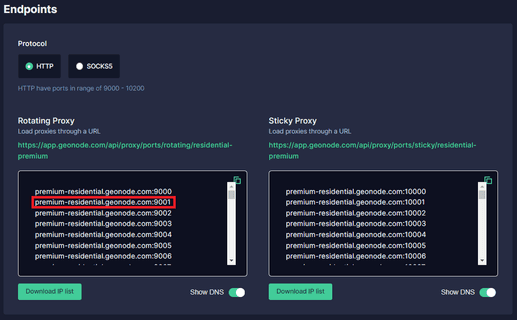
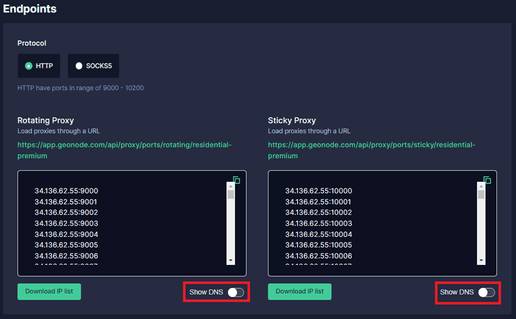
Jika Anda ingin menggunakan alamat IP alih-alih DNS, cukup nonaktifkan tombol “Tampilkan DNS”, dan alamat IP akan muncul.
Langkah 7. Sekarang Anda memerlukan “Rincian Otentikasi” akun proxy Anda. Untuk Geonode
, informasi ini terdapat di halaman beranda akun Anda.
