Imagina o seguinte: com apenas algumas linhas de código, podes aceder a uma enorme quantidade de dados do Subito.it, o principal mercado online da Itália.
Isto não é apenas um truque tecnológico interessante; é um passo revolucionário para quem leva a sério as decisões baseadas em dados.
Quer pretenda compreender o comportamento do consumidor, manter-se na vanguarda com preços dinâmicos ou superar a concorrência, a extração de dados do Subito.it é o seu trunfo.
Mergulhe neste guia para descobrir como pode elevar a sua estratégia de negócio ao explorar o mundo rico em dados do Subito.it.
O que é o Subito.it?
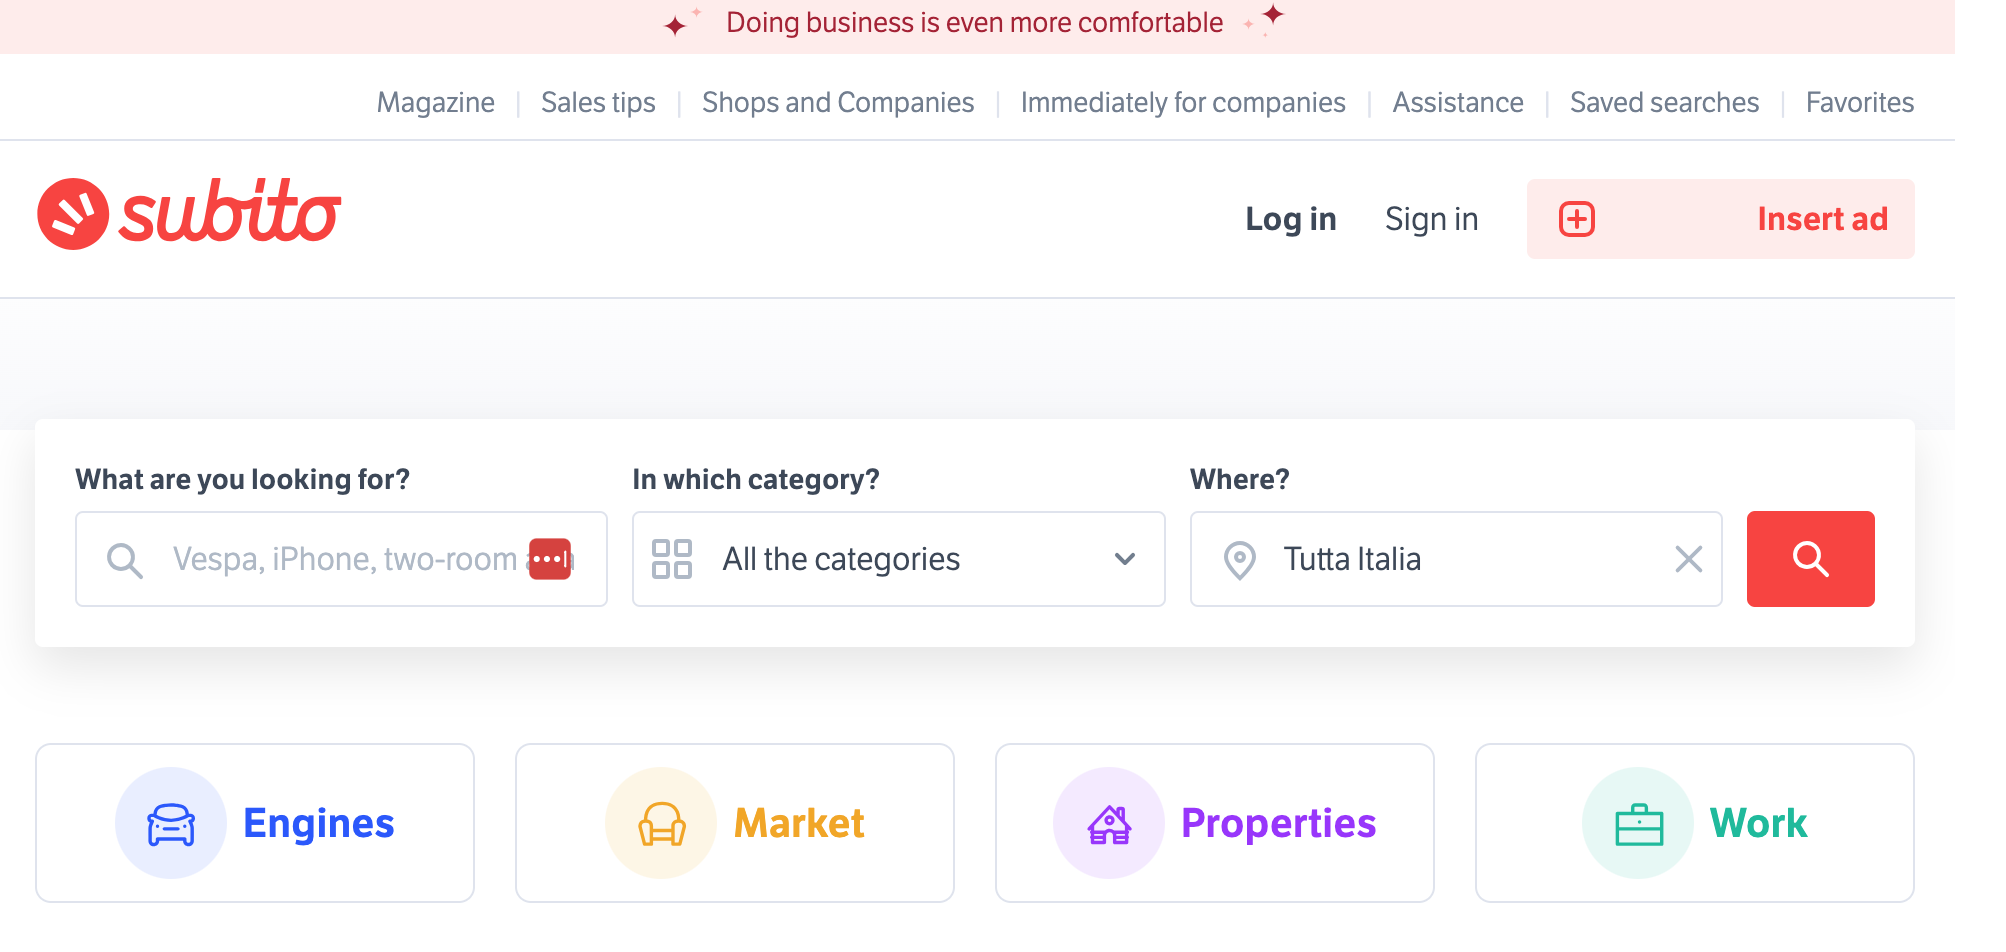
O Subito.it é uma plataforma online italiana onde os utilizadores podem comprar e vender artigos novos e usados.
O site oferece uma vasta gama de categorias, incluindo automóveis, mercado, imobiliário e emprego.
Os utilizadores podem publicar anúncios locais de carros, casas, eletrónica, mobiliário, animais de estimação e muito mais.
A plataforma disponibiliza também várias funcionalidades para tornar as transações mais seguras e convenientes, tais como envios com acompanhamento e opções de pagamento seguras.
Porquê fazer web scraping no Subito.it?
O web scraping tornou-se uma ferramenta essencial no panorama empresarial moderno e o Subito.it, enquanto um dos maiores mercados online de Itália, oferece uma grande quantidade de dados que podem ser inestimáveis para diversas aplicações.
Importância dos dados do Subito.it no comércio eletrónico
O Subito.it não é apenas mais um mercado online; é uma mina de ouro de dados para qualquer pessoa no comércio eletrónico.
Com milhões de anúncios em categorias como automóveis, imobiliário, emprego e bens de consumo, a plataforma oferece uma visão abrangente das tendências de mercado, das preferências dos consumidores e das estratégias de preços.
Ao extrair dados do Subito.it, as empresas podem aceder a esta informação em tempo real, o que permite uma tomada de decisões mais ágil e informada.
Por exemplo, se for um retalhista online, pode extrair dados do Subito.it para compreender o preço médio de produtos semelhantes aos seus e ajustar a sua estratégia de preços em conformidade.
Da mesma forma, as imobiliárias podem extrair anúncios para avaliar o valor de mercado de imóveis em diferentes regiões.
Os dados do Subito.it também podem ser utilizados para análise de sentimentos, ajudando as empresas a compreender o que os clientes procuram e o que pensam sobre determinados produtos ou serviços.
Casos de utilização da extração de dados do Subito.it
- Estudo de mercado. Compreender as tendências do mercado é crucial para qualquer empresa.
Ao extrair dados do Subito.it, pode recolher informações sobre os produtos mais populares, as tendências sazonais e as exigências dos consumidores, o que o ajuda a adaptar a sua oferta em conformidade.
- Análise da concorrência. Manter-se atento aos seus concorrentes é mais fácil do que nunca com o web scraping. Extraia dados sobre listagens de produtos, avaliações de clientes e estratégias de preços para ver como se posiciona face à concorrência.
- Preços dinâmicos. Num mercado em rápida evolução, os preços estáticos podem ser uma desvantagem. O scraping do Subito.it permite-lhe monitorizar as tendências de preços em tempo real, permitindo-lhe ajustar os seus preços em tempo real para maximizar os lucros ou a quota de mercado.
- Geração de leads. Para setores baseados em serviços ou empresas B2B, o Subito.it pode ser uma fonte de potenciais leads. Recolha detalhes de contacto e pedidos de serviço para construir um funil de vendas direcionado.
- Análise de sentimento. As avaliações e comentários dos clientes no Subito.it podem ser recolhidos para análise de sentimento, fornecendo informações sobre a opinião pública e áreas a melhorar.
Estudos de caso e exemplos reais
-
Concessionária automóvel. Uma concessionária automóvel local pode utilizar os dados do Subito.it para compreender a procura por carros elétricos na sua região. Ao extrair anúncios e consultas de clientes, pode abastecer-se dos modelos mais procurados, resultando num aumento de 20% nas vendas.
-
Retalhista de moda. Um retalhista de moda pode extrair dados do Subito.it para analisar a popularidade de diferentes marcas e estilos de vestuário. Esta abordagem baseada em dados permite adaptar o seu inventário, levando a um sistema de gestão de stock mais eficiente e a um aumento das vendas.
-
Empresa imobiliária. Uma empresa imobiliária pode extrair dados do Subito.it para recolher informações sobre os preços dos imóveis em vários bairros. Esta informação pode ser utilizada para desenvolver um modelo de preços dinâmico que ajuste os preços dos imóveis com base nas condições do mercado em tempo real, otimizando significativamente as suas receitas.
Ao compreender a importância, os casos de utilização e as aplicações no mundo real da extração de dados do Subito.it, torna-se claro que esta prática não é apenas um exercício técnico, mas uma necessidade estratégica para as empresas modernas.
Formas de extrair dados do Subito.it
A extração de dados do Subito.it pode ser abordada de várias formas, cada uma com as suas próprias vantagens e limitações.
Quer seja um principiante em programação ou um programador experiente, existe um método adequado às suas necessidades.
Extração manual
O que é: A extração manual é o método mais simples, não exigindo conhecimentos de programação.
Consiste em visitar manualmente o site do Subito.it e copiar os dados de que necessita.
Como fazê-lo:
-
- Abra o navegador. Aceda ao Subito.it no seu navegador.
- Pesquise anúncios. Utilize a barra de pesquisa ou os filtros de categoria para encontrar os anúncios que lhe interessam.
- Copie os dados. Copie e cole manualmente os dados numa folha de cálculo ou num documento.
Prós e contras:
-
- Prós: Fácil de fazer, não requer competências técnicas.
- Contras: Extremamente demorado, pouco prático para conjuntos de dados de grande dimensão, sujeito a erros humanos.
Ideal para: Projetos de pequena escala ou tarefas rápidas e pontuais de recuperação de dados.
Escrever código
O que é: Envolve escrever scripts para automatizar o processo de extração de dados. As linguagens mais utilizadas para este fim são o Python e o JavaScript.
Como fazê-lo:
-
- Escolha uma biblioteca. Bibliotecas como o BeautifulSoup para Python ou o Puppeteer para JavaScript são escolhas populares.
- Inspecione os elementos. Utilize as ferramentas de desenvolvimento do seu navegador para inspecionar os elementos HTML que contêm os dados que pretende.
- Escreva o código. Escreva um script para aceder ao Subito.it, localizar os pontos de dados e extraí-los.
- Execute o script. Execute o script para recolher os dados.
Prós e contras:
-
- Prós: Altamente personalizável, consegue lidar com grandes conjuntos de dados, minimiza o erro humano.
- Contras: Requer competências de programação, pode exigir manutenção à medida que as estruturas dos sites mudam.
Ideal para: Projetos de média a grande escala onde a personalização e a escalabilidade são necessárias.
Utilização de scrapers de terceiros
O que é: Trata-se de software ou plataformas pré-construídas, concebidas para extrair dados de sites.
Como fazê-lo:
-
- Escolha um scraper. Pesquise e selecione um scraper de terceiros que se adapte às suas necessidades.
- Configure. A maioria destas ferramentas oferece uma interface gráfica (GUI) onde pode apontar e clicar nos dados que pretende extrair.
- Execute o scraper. Inicie o processo de extração. Algumas ferramentas oferecem soluções baseadas na nuvem, pelo que não é necessário executar o scraper no seu computador.
Prós e contras:
-
- Prós: Fácil de utilizar, não requer programação, muitas vezes inclui funcionalidades integradas, como a rotação de IP.
- Contras: Pode ser dispendioso, menos personalizável do que programar a sua própria solução.
Ideal para: Quem precisa de uma forma mais simples e menos técnica de extrair dados em grande escala.
Ao compreender estes métodos, pode escolher aquele que melhor se adapta ao âmbito do seu projeto e à sua proficiência técnica. Cada um tem as suas vantagens e desvantagens, mas todos são formas viáveis de aceder aos ricos recursos de dados que o Subito.it oferece.
Ferramentas necessárias
Escrever código é uma das formas mais comuns de extrair dados do Subito.it, pois permite um elevado grau de personalização.
No entanto, a programação é apenas uma parte da equação. Para extrair dados de um site de forma eficaz, vai precisar de um conjunto de ferramentas capazes de lidar com vários aspetos do processo de extração.
Esta secção fornece um guia geral sobre as ferramentas essenciais de que vai precisar para extrair dados do Subito.it.
Bibliotecas de extração de dados da Web
As bibliotecas de extração de dados da Web são pacotes de código pré-escritos que simplificam o processo de extração de dados de sites.
Elas tratam dos pormenores técnicos da navegação em HTML e HTTP, permitindo-lhe concentrar-se nos dados que pretende.
Bibliotecas Python para extrair dados do Subito.it:
- Beautiful Soup. Ideal para principiantes, o Beautiful Soup facilita a extração de informações de páginas web, fornecendo expressões típicas do Python para iterar, pesquisar e modificar a árvore de análise.
- Scrapy. Mais adequado para a extração de dados da Web em grande escala, o Scrapy é um framework de código aberto que fornece todas as ferramentas necessárias para rastrear sites e extrair dados.
- Selenium. Embora não seja estritamente uma biblioteca de extração de dados da Web, o Selenium é útil para sites que carregam dados dinamicamente com JavaScript.
Proxies Premium
Os proxies atuam como intermediários entre o seu computador e o site que está a extrair, ocultando o seu endereço IP. Os proxies Geonode são conhecidos pela sua eficiência e segurança.
Como os proxies Geonode podem tornar a sua extração mais eficiente e segura:
- Rotação de IP. Os proxies Geonode alternam automaticamente os endereços IP, reduzindo o risco de ser bloqueado pelo Subito.it.
- Velocidade. O Geonode oferece proxies de alta velocidade que garantem que as suas tarefas de scraping sejam concluídas rapidamente.
- Segurança. Com Geonode, os seus dados são encriptados, proporcionando uma camada adicional de segurança.
Geonode dispõe de um painel de controlo onde pode configurar as suas definições de proxy. Depois de configurados, pode integrá-los no seu código de scraping.
Extensões essenciais para o navegador
As extensões de navegador podem auxiliar no processo de web scraping, ajudando-o a compreender a estrutura de um site ou automatizando algumas tarefas manuais.
- Web Scraper: Esta extensão do Chrome permite-lhe configurar um plano e extrair dados diretamente a partir do seu navegador.
- Data Miner: Útil para extrair tabelas ou listas, o Data Miner pode poupar-lhe tempo quando estiver a fazer pesquisa preliminar.
- Selector Gadget: Esta extensão ajuda-o a encontrar rapidamente seletores CSS, o que pode ser útil ao escrever o seu código de scraping.
Estas extensões podem ser encontradas na Chrome Web Store. Basta procurar a extensão e clicar em «Adicionar ao Chrome».
Ao equipar-se com estas ferramentas essenciais, estará no bom caminho para extrair dados do Subito.it de forma eficaz e eficiente. Quer seja um principiante ou um programador experiente, estas ferramentas fornecem a base de que necessita para extrair dados valiosos do Subito.it.
Configurar o seu ambiente
Antes de avançar para o processo de scraping propriamente dito, é fundamental configurar um ambiente propício que permita um scraping da Web eficiente e eficaz. Esta secção serve como um guia geral para o ajudar a preparar o seu sistema para o scraping do Subito.it.
Instalação do software necessário
Para extrair dados do Subito.it, vai precisar de um editor de código, um ambiente Python e bibliotecas específicas que facilitem a extração de dados da Web.
Configuração do software para a extração de dados do Subito.it:
-
Editor de código. Escolha um editor de código onde irá escrever o seu script de extração. As opções mais populares incluem o Visual Studio Code, o PyCharm ou o Jupyter Notebook para projetos mais centrados em dados.
-
Ambiente Python. Se ainda não tiver o Python instalado, descarregue-o e instale-o a partir do site oficial. Certifique-se de que instala também o pip (o instalador de pacotes do Python).
-
Bibliotecas de extração de dados da Web: Instale as bibliotecas Python que irá utilizar para a extração de dados. Abra o seu terminal e execute os seguintes comandos: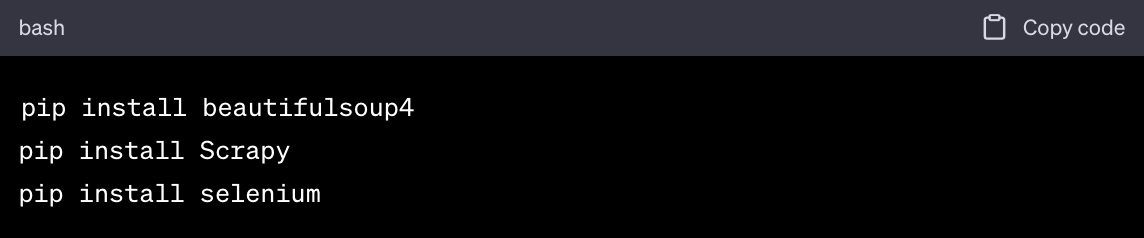
-
Navegador e driver: Se estiver a utilizar o Selenium, também precisará de um driver web correspondente ao seu navegador (por exemplo, o ChromeDriver para o Google Chrome).
Passos de instalação:
- Descarregue o editor de código que escolheu e siga as instruções de instalação.
- Instale o Python e certifique-se de que marca a caixa que adiciona o Python ao seu PATH.
- Abra o terminal e execute os comandos pip para instalar as bibliotecas de web scraping.
- Descarregue o web driver para o Selenium e coloque-o num diretório que esteja no PATH do seu sistema.
Configurar os proxies dGeonode
-
Registe-se no Geonode. Visite o site do Geonode e crie uma conta. Escolha um plano que se adapte às suas necessidades.
-
Aceda ao Painel de Controlo. Inicie sessão na sua conta Geonode e aceda ao painel de controlo.
-
Crie um conjunto de proxies. No painel de controlo, procure a opção para criar um novo conjunto de proxies. Siga as instruções para configurar o seu conjunto, especificando os países ou cidades de onde pretende que os endereços IP provenham.
-
Obter detalhes do proxy. Assim que o conjunto estiver configurado, ser-lhe-á fornecida uma lista de endereços IP e portas de proxy. Copie estes detalhes.
-
Integre no código. No seu código de scraping, terá de configurar a sua biblioteca de web scraping para encaminhar os pedidos através do proxy Geonode. Por exemplo, se estiver a utilizar a biblioteca requests do Python, faria algo semelhante a isto: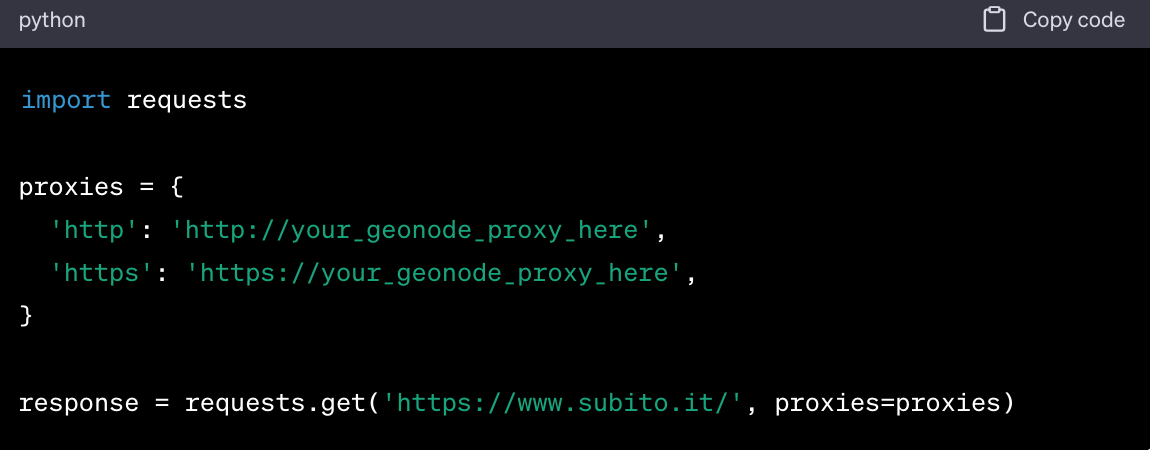
Seguindo estes passos, terá um ambiente robusto configurado para extrair dados do Subito.it. Com o software e os proxies adequados instalados, estará bem equipado para começar a recolher os dados de que necessita.
O Processo de Scraping
Assim que o seu ambiente estiver configurado, estará pronto para mergulhar no processo de scraping propriamente dito.
Identificação dos Pontos de Dados
O primeiro passo em qualquer projeto de web scraping é identificar exatamente quais os dados que pretende recolher. Estes podem variar desde preços e descrições de produtos até opiniões de utilizadores e muito mais.
Que dados extrair do Subito.it:
- Listagens de produtos. Informações como nome do produto, preço e descrição.
- Informações do vendedor. Detalhes como nome do vendedor, informações de contacto e avaliações.
- Avaliações dos utilizadores. Classificações e comentários dos utilizadores.
- Resultados de pesquisa. Dados das páginas de resultados de pesquisa, incluindo métricas de classificação e relevância.
Como identificar estes dados:
- Inspecione o site. Navegue pelo Subito.it e identifique as páginas que contêm os dados que lhe interessam.
- Utilize as ferramentas de programador. Abra as ferramentas de programador do seu navegador para inspecionar a estrutura HTML e identificar as tags que contêm os dados pretendidos.
Escrever o código de scraping
Isto envolve escrever um script em Python (ou outra linguagem) que irá navegar até à página web e extrair os pontos de dados que identificou.
Eis um fragmento de código Python simplificado que utiliza o BeautifulSoup para extrair nomes e preços de produtos de uma página hipotética do Subito.it: 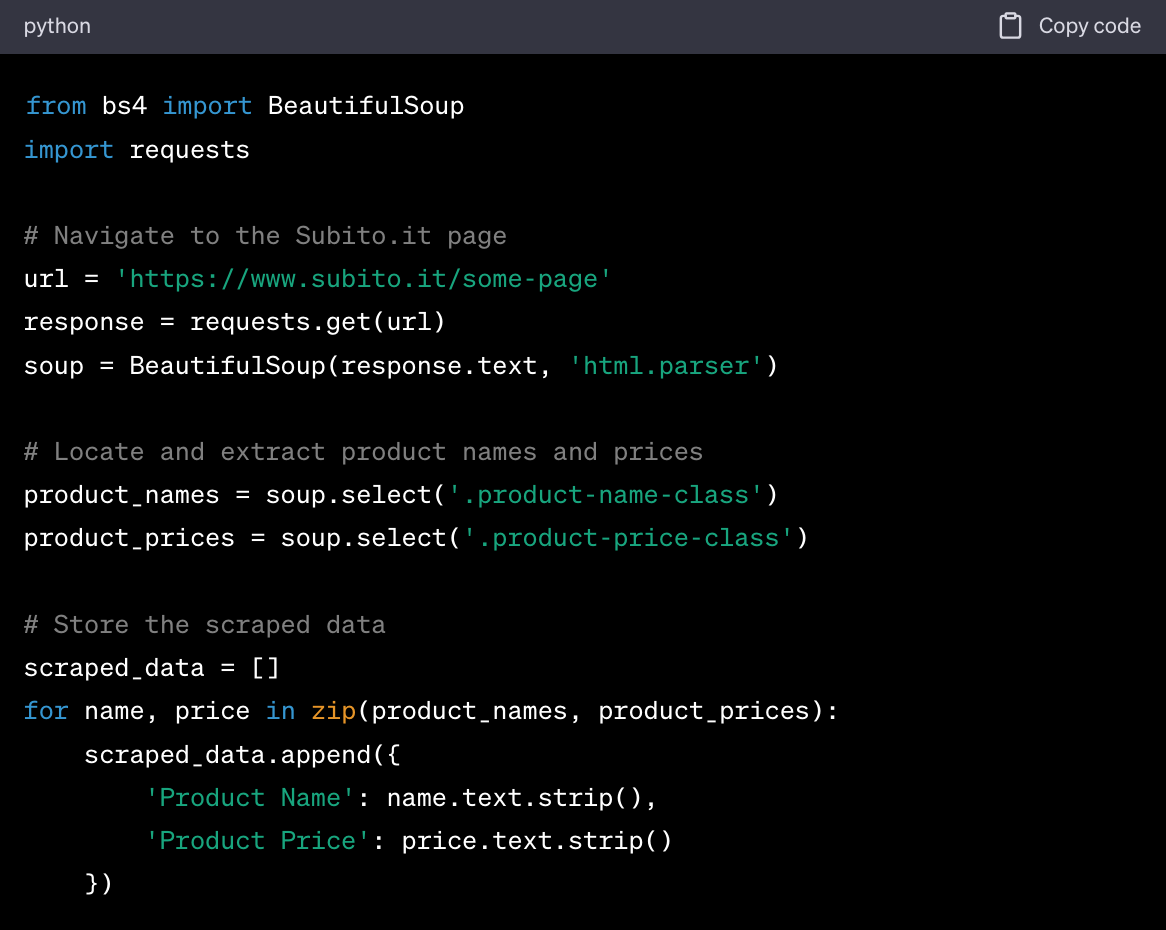
Executar o scraper
Esta é a fase em que executa o seu código de scraping para recolher os dados que selecionou.
Como executar o seu código de scraping e recolher dados
- Teste em pequena escala. Antes de executar o seu scraper em centenas de páginas, teste-o em algumas para se certificar de que está a funcionar conforme o esperado.
- Execute o código. Execute o seu script Python. Normalmente, isto pode ser feito diretamente a partir do seu editor de código ou da linha de comandos, executando «
python your_script_name.py».
- Monitorize o processo. Fique atento ao script enquanto este está a ser executado para garantir que não há erros nem problemas.
- Armazene os dados. Certifique-se de que o seu script está configurado para armazenar os dados extraídos num formato útil, como um ficheiro CSV ou uma base de dados.
Seguindo estes passos, estará no bom caminho para extrair com sucesso dados valiosos do Subito.it. Com a preparação e execução adequadas, a extração de dados da Web pode fornecer-lhe as informações necessárias para tomar decisões informadas.
Melhores práticas e considerações legais
Ao fazer scraping do Subito.it ou de qualquer outro site, é fundamental estar ciente tanto das melhores práticas como das considerações legais.
Isto garante que as suas atividades de scraping sejam éticas e estejam em conformidade com as leis e regulamentos relevantes. Esta secção irá aprofundar estes aspetos em pormenor.
Respeitar o ficheiro robots.txt
O ficheiro robots.txt é um padrão utilizado pelos sites para comunicar com rastreadores da Web e outros agentes automatizados, indicando quais as partes do site que não devem ser processadas ou rastreadas.
Ignorar as diretrizes estabelecidas no ficheiro robots.txt pode levar ao bloqueio do seu endereço IP e poderá potencialmente resultar em consequências legais.
Limitação de taxa e rotação de IP
A limitação de taxa consiste na restrição do número de pedidos que pode efetuar a um site num determinado período de tempo. A rotação de IP envolve a alteração periódica do seu endereço IP para evitar a deteção e o bloqueio.
Como os proxies dGeonode podem ajudar na limitação de taxa e na rotação de IP:
- Rotação de IP. Os proxies dGeonode fazem a rotação automática do seu endereço IP, dificultando que os sites o identifiquem e bloqueiem.
- Limitação de taxa. A utilização de vários endereços IP através de Geonode permite-lhe distribuir os seus pedidos, contornando eficazmente os limites de taxa definidos pelo site.
- Configuração. Os proxies de Geonode têm definições que lhe permitem controlar a frequência e o padrão dos seus pedidos, ajudando-o a fazer o scraping de forma responsável.
O não cumprimento dos limites de taxa ou a não rotação de IPs pode resultar no bloqueio do seu scraper, tornando os seus esforços de scraping ineficazes.
Armazenamento e utilização de dados
Depois de ter extraído os dados, a forma como os armazena e utiliza está sujeita a considerações tanto éticas como legais.
- Armazenamento. Armazene os dados num ambiente seguro para impedir o acesso não autorizado. Recomenda-se frequentemente a encriptação.
- Utilização. Os dados que extraiu devem ser utilizados de forma responsável. A utilização indevida de dados para enviar spam, cometer fraudes ou qualquer forma de assédio não só é antiética como também ilegal.
- Partilha. Se pretender partilhar os dados extraídos, certifique-se de que tem o direito legal de o fazer. Alguns sites têm termos de serviço que proíbem a partilha de dados extraídos.
- Atribuição. Se estiver a utilizar os dados para investigação ou elaboração de relatórios, é boa prática citar a fonte.
O armazenamento inadequado ou a utilização antiética dos dados extraídos podem levar a repercussões legais e prejudicar a sua reputação.
Ao seguir estas melhores práticas e considerações legais, pode garantir que as suas atividades de web scraping sejam conduzidas de forma responsável e ética. Isto não só minimiza o risco de problemas legais, como também contribui para a integridade e fiabilidade dos seus projetos de web scraping.
Resolução de problemas e perguntas frequentes
Mesmo com a melhor preparação, poderá deparar-se com problemas ao extrair dados do Subito.it. Esta secção tem como objetivo abordar erros comuns e perguntas frequentes para o ajudar a resolver eficazmente os problemas nas suas atividades de extração de dados.
Erros comuns e soluções
Resolução de problemas relacionados com a extração de dados do Subito.it:
-
IP bloqueado. Se verificar que os seus pedidos estão a ser recusados, é provável que o seu IP tenha sido bloqueado.
- Solução: Utilize um serviço de proxy, como o Geonode, para alternar os seus endereços IP.
-
Limite de taxa excedido. Se estiver a efetuar demasiadas solicitações num curto período de tempo, poderá atingir o limite de taxa.
- Solução: Implemente um intervalo entre as suas solicitações ou distribua-as utilizando vários endereços IP.
-
Dados incompletos ou imprecisos. Por vezes, o scraper pode não recolher todos os dados necessários ou pode recolher dados incorretos.
- Solução: Verifique novamente o seu código para garantir que está a selecionar os elementos HTML corretos.
-
Erros de tempo limite. O seu scraper pode atingir o tempo limite se uma página demorar demasiado tempo a carregar.
- Solução: Aumente o limite de tempo no seu código ou tente otimizar o seu scraper para que funcione mais rapidamente.
As pessoas também perguntam
Perguntas frequentes e respetivas respostas:
-
Como fazer scraping do Subito.it sem ser bloqueado?
- Utilize proxies para alternar os seus endereços IP e implemente limitação de taxa para evitar efetuar demasiados pedidos num curto período de tempo. Além disso, respeite as diretrizes contidas no ficheiro «
robots.txt» do Subito.it.
-
É legal fazer scraping do Subito.it?
- Embora o scraping de dados públicos seja, em geral, legal, é fundamental respeitar os termos de serviço do site e as diretrizes de «
robots.txt». O uso indevido dos dados extraídos pode acarretar consequências legais.
-
Como posso extrair dados do Subito.it mais rapidamente?
- Para acelerar o processo de extração, pode utilizar uma biblioteca ou framework de extração mais eficiente. Além disso, a utilização de um serviço de proxy como o Geonode pode ajudar a distribuir os seus pedidos por vários endereços IP, contornando eficazmente os limites de taxa.
Ao estar ciente destas questões comuns e perguntas frequentes, poderá preparar-se melhor para os desafios associados à extração de dados da Web. Uma resolução adequada de problemas pode poupar-lhe tempo e recursos, tornando o seu projeto de extração mais eficiente e eficaz.
Conclusão
A extração de dados do Subito.it oferece uma infinidade de oportunidades para empresas, investigadores e analistas de dados.
Ao automatizar o processo de recolha de dados, é possível obter informações valiosas sobre as tendências do mercado, o comportamento dos consumidores e o panorama da concorrência.
Quer pretenda otimizar a sua estratégia de preços, compreender o seu público-alvo ou tomar decisões baseadas em dados, a extração de dados do Subito.it fornece-lhe a matéria-prima de que necessita.
Este guia abordou tudo, desde a configuração do seu ambiente e a escolha das ferramentas certas até às melhores práticas e à resolução de problemas.
O objetivo foi dotá-lo do conhecimento e das competências necessárias para extrair dados do Subito.it de forma eficaz e responsável.
O que fazer com os dados que extraiu e como aproveitá-los para o sucesso do seu negócio:
-
Limpeza de dados: O primeiro passo após a extração é limpar e organizar os dados. Isto envolve remover duplicados, tratar valores em falta e converter tipos de dados sempre que necessário.
-
Análise de dados. Utilize métodos estatísticos ou algoritmos de aprendizagem automática para analisar os dados. Isto poderá ajudá-lo a identificar padrões, correlações ou tendências que possam ser benéficos para o seu negócio.
-
Implementação estratégica. Aplique os insights obtidos com a análise às suas estratégias de negócio. Por exemplo, se tiver extraído dados de preços, poderá utilizá-los para otimizar a sua própria estratégia de preços.
-
Monitorização e atualização. A Web é dinâmica e os dados podem ficar desatualizados rapidamente. Adote o hábito de executar o seu scraper periodicamente para manter os dados atualizados.
-
Conformidade e ética. Certifique-se sempre de que a utilização dos dados extraídos cumpre os regulamentos legais e as normas éticas. Isto inclui o respeito pelas leis de privacidade e pelos direitos de propriedade intelectual.
-
Partilhar conclusões. Se for adequado, considere partilhar as suas conclusões com a sua equipa, partes interessadas ou mesmo com a comunidade em geral. Isto não só acrescenta valor como também consolida a sua experiência na área.
Seguindo estes passos, poderá transformar os dados brutos que recolheu em insights úteis, tirando assim partido deles para o sucesso do negócio.
Com a abordagem certa e práticas responsáveis, a recolha de dados da Web pode ser uma ferramenta poderosa no seu arsenal de tomada de decisões baseadas em dados.

