

Scrapy, internetteki herkes tarafından ücretsiz olarak kullanılabilen açık kaynaklı bir web tarama çerçevesidir. Scrapy, esas olarak web taraması ve web veri toplama için kullanılır. Herhangi bir web sayfasından veri çıkarmak için hızlı ve kolay bir yöntemdir ve şu anda Zyte tarafından geliştirilmektedir.
Scrapy'yi Yükleme
Scrapy'yi yüklemek için Python 3.7 veya daha yeni bir sürüme ihtiyacınız vardır. Ayrıca, sistem paketlerinizle ortaya çıkabilecek olası çakışmaları önlemek için, Scrapy'yi özel bir virtualenv ortamına yüklemeniz önerilir.
İndir Scrapy'yi tercih ettiğiniz platformda.
Scrapy'yi kurmak için Anaconda veya Miniconda kurmanız, Python'u açmanız ve şu komutu çalıştırmanız gerekir:
conda install -c conda-forge scrapy
Alternatif olarak şunu da çalıştırabilirsiniz:
pip install Scrapy
Ubuntu sistemi kullanıyorsanız, önce şu bağımlılıkların tümünü yüklemeniz gerekir:
sudo apt-get install python3 python3-dev python3-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
macOS sistemi kullanıyorsanız, Xcode komut satırı araçlarını yüklemeniz gerekir. Bir terminal penceresi açıp şu komutu çalıştırmanız gerekir:
xcode-select --install
Tebrikler! Cihazınıza Scrapy'yi yüklediniz. Artık bir web sitesini tarayıp verilerini çıkarmayı deneyebiliriz.
Bir Scrapy Projesi Başlatma
Yeni bir Scrapy projesi başlatmak için, kodunuzun depolanmasını istediğiniz bir dizin belirtmeniz gerekir. Şu komutu çalıştırmanız gerekir:
scrapy startproject scrapetest
Bu komutu çalıştırdığınızda “scrapetest” adlı bir dizin oluşturulur ve içinde şunlar bulunur:
_scrapetest/ scrapy.cfg # dağıtım yapılandırma dosyası
scrapetest/             # projenin Python modülü; kodunuzu buradan içe aktaracaksınız
    __init__.py

    items.py

    middlewares.py

    pipelines.py

    settings.py

    spiders/          # daha sonra örümceklerinizi yerleştireceğiniz dizin
        __init__.py
_
Bir Scrapy projesi başlattıktan sonra, şimdi bir Örümcek oluşturmanız gerekiyor. Örümcek, Scrapy'nin bir web sayfasından bilgi çıkarmak için kullandığı araç olduğu için gereklidir. Örnek olarak, “quotes.toscrape.com” web sitesini tarayacağız.
Öncelikle şu kodu çalıştırmanız gerekir:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" # Spider adları, oluşturduğunuz her spider için benzersiz olmalıdır
def start_requests(self):
    urls = [
        'https://quotes.toscrape.com/page/1/',
        # Bu URL'leri,
veri toplamak istediğiniz web sayfalarına göre değiştirin 'https://quotes.toscrape.com/page/2/', ] for url in urls: yield scrapy.Request(url=url, callback=self.parse)
def parse(self, response):
    page = response.url.split("/")[-2]
    filename = f'quotes-{page}.html'
    with open(filename, 'wb') as f:
        f.write(response.body)
    self.log(f'{filename} dosyası kaydedildi')
_
Örümceğin taramaya başlaması için şunu çalıştırmanız gerekir:
scrapy crawl test
Ardından, “quotes.toscrape.com” web sitesini taradığınızı gösteren bir çıktı almalısınız.
Bir web sayfasından belirli verileri çıkarmak istiyorsanız, Python'daki “yield” anahtar sözcüğünü kullanabilir ve şu kodu çalıştırabilirsiniz:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', 'https://quotes.toscrape.com/page/2/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }
_
Bu kod, taradığınız web sayfasından metinleri, yazarı ve etiketleri çıkarır; bunlar günlüğünde gösterilir.
Sadece belirli sayfalar yerine bir web sitesindeki tüm sayfaları taramak istiyorsanız, şunu çalıştırabilirsiniz:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }

    next_page = response.css('li.next a::attr(href)').get()
    if next_page is not None:
        next_page = response.urljoin(next_page)
        yield scrapy.Request(next_page, callback=self.parse)
_
Şimdi, örümceğin çıkardığı verileri kaydetmeniz gerekiyor. Kazınan verileri kaydetmek için şu komutu çalıştırmanız yeterlidir:
scrapy crawl test -O test.json
Zaten mevcut bir dosyaya yeni içerik eklemek istiyorsanız, bunun yerine şu kodu çalıştırabilirsiniz:
scrapy crawl quotes -o quotes.jsonl
Tebrikler! Scrapy ile kazıdığınız verileri ayıklama ve kaydetme işlemini tamamladınız. Scrapy ile web kazımanın başarılı olmasını sağlamak için bir şey daha ekleyebilirsiniz: Scrapy proxy'lerini kullanmak.
Scrapy Proxy'lerini Yapılandırma
Bir Scrapy proxy'si, tüm web isteklerinizi sizin adınıza yönetecektir; böylece veri topladığınız herhangi bir web sitesi, yalnızca proxy sunucusunun IP adresini görebilecektir. IP adresiniz tamamen gizlenecektir. IP adreslerini sürekli değiştirerek ve ev tipi proxy'leri kullanarak, web siteleri, isteklerinizin Scrapy gibi bir web kazıma botu kullanan birinden değil, gerçek kullanıcılardan geldiğini sanacaklardır.
Örnek olarak, bir Geonode proxy kullanacağız. Henüz Geonode proxy bilgilerinizi almadıysanız, “Geonode ile Proxy Sunucusu Bilgilerini Alma” bölümüne geçebilirsiniz.
Scrapy’de proxy kurmak için iki yöntem vardır.
İlk yöntem, HTTPProxyMiddleware adlı Scrapy ara yazılımını kullanmaktır; bu, proxy parametrenizi otomatik olarak varsayılan proxy olarak ayarlar.
Şu komutu çalıştırabilirsiniz:
_def start_requests(self): for url in self.start_urls: return Request(url=url, callback=self.parse, headers={"User-Agent": "My UserAgent"}, meta={"proxy": "premium-residential.geonode.com:9001"}) _
İkinci yöntem ise kendi ara yazılımınızı oluşturmaktır. Bu yöntem daha izole bir yapıya sahiptir ve size daha fazla özgürlük sağlar.
Şu komutu çalıştırabilirsiniz:
_from w3lib.http import basic_auth_header
DOWNLOADER_MIDDLEWARES = { 'myproject.middlewares.CustomProxyMiddleware': 350, 'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 400, }
class CustomProxyMiddleware(object): def process_request(self, request, spider): request.meta[“proxy”] = "premium-residential.geonode.com:9001" request.headers[“Proxy-Authorization”] = basic_auth_header(“geonode_xbYe9H2LYr”, “9806022c-cd4a-4776-a053-73fee44344dd”) _
Tebrikler! Scrapy ile herhangi bir web sitesinden veri toplarken bir proxy sunucusu eklediniz. Proxy'nizin çalışıp çalışmadığını doğrulamak isterseniz, https://www.geonode.com/what-is-my-ip adresini ziyaret edebilirsiniz.
Geonode
ile Proxy Sunucu Bilgilerini Alma ### Adım 1. **Geonode
** adresine gidin ve mevcut hesabınızla giriş yapın veya yeni bir hesap oluşturmak için kaydolun.
Adım 2. Ana Sayfada, “Konut Hizmetleri” seçeneğine tıklayın.

Adım 3. “Uç Noktalar” seçeneğini görene kadar aşağı kaydırın.
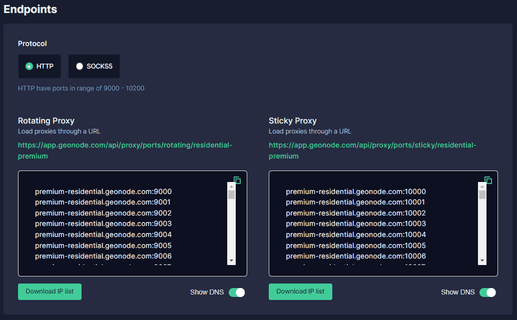
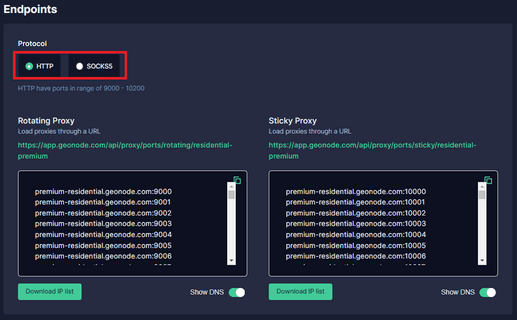
Adım 4. Hangi “Proxy Protokolü”’nü kullanmak istediğinizi seçin: “HTTP Protokolü” veya **“[SOCKS5
Protokolü](https://geonode.com/blog/beginners-guide-to-socks5-proxies)”**.
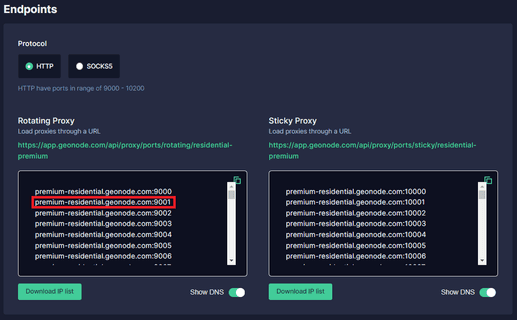
Adım 5. Hangi "Oturum Türü"'nü kullanmak istediğinizi seçin: “Dönen Proxy” veya Sabit Proxy.
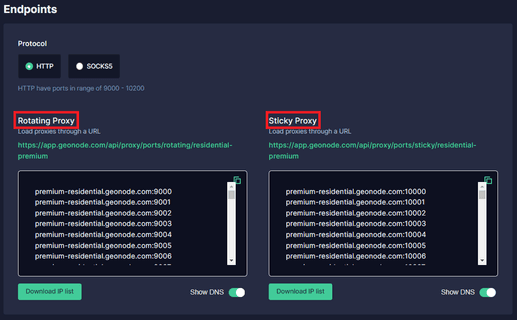
Adım 6. Hangi proxy'yi kullanmak istediğinizi seçin. Örnek olarak, vurgulanan **“premium-residential.geonode
.com:9001”** proxy'sini kullanacağız.
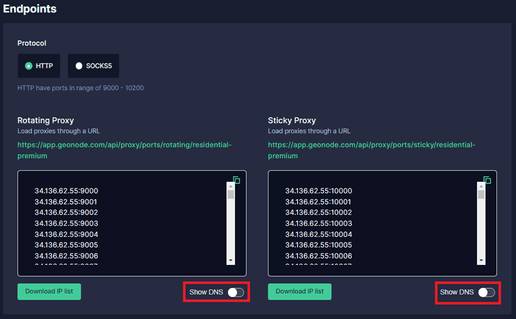
DNS yerine bir IP adresi kullanmak istiyorsanız, “DNS’yi Göster” düğmesini kapatmanız yeterlidir; IP adresleri görünecektir.
7. Adım. Şimdi proxy hesabınızın “Kimlik Doğrulama Bilgileri”ne ihtiyacınız var. Geonode
için bu bilgiler, hesabınızın ana sayfasında yer alır.
