Haben Sie es satt, auf SeatGeek manuell nach Veranstaltungstickets zu suchen? Wünschen Sie sich, es gäbe eine Möglichkeit, diesen Vorgang zu optimieren und Zeit zu sparen?
Angesichts der riesigen Auswahl an verfügbaren Tickets kann die manuelle Suche nach den besten Angeboten schnell überwältigend werden. Mithilfe von Web-Scraping-Techniken können Sie diesen Vorgang jedoch automatisieren und alle benötigten Ticketinformationen innerhalb weniger Minuten zusammenstellen.
Web-Scraping ist eine wertvolle Fähigkeit, mit der Sie Daten aus Websites extrahieren und für verschiedene Zwecke nutzen können. Durch das Scraping von SeatGeek.com erhalten Sie Zugriff auf aktuelle Ticketpreise, Verfügbarkeiten und andere wichtige Details.
Ganz gleich, ob Sie regelmäßig Konzerte besuchen oder Tickets weiterverkaufen – wenn Sie lernen, wie man SeatGeek.com scrapt, verschaffen Sie sich einen Wettbewerbsvorteil und stellen sicher, dass Sie nie wieder die besten Angebote verpassen.
Was ist SeatGeek?
SeatGeek.com ist ein beliebter Online-Ticketmarktplatz, auf dem Nutzer Tickets für verschiedene Veranstaltungen wie Konzerte, Kinofilme, Sportveranstaltungen und Theateraufführungen kaufen und verkaufen können.
Die Plattform ermöglicht es Einzelpersonen, die besten Angebote zu finden und Preise verschiedener Anbieter zu vergleichen.
SeatGeek bietet außerdem interaktive Sitzplanansichten, Ticketangebote in Echtzeit und eine mobile App für den einfachen Zugriff von unterwegs.
Die Website hat aufgrund ihrer benutzerfreundlichen Oberfläche und ihrer zuverlässigen Ticketdienste an Beliebtheit gewonnen und ist damit für viele Veranstaltungsbesucher zur ersten Anlaufstelle geworden.
Warum ist SeatGeek so beliebt?
SeatGeek, eine der größten Aggregator-Websites für Live- und Online-Veranstaltungen, hebt sich von anderen Ticket-Websites durch eine benutzerfreundliche Oberfläche, transparente Preisgestaltung und ein „Deal Score“-System ab, das Ticketangebote anhand von Preis und Sitzplatzqualität bewertet.
 Foto von Pexels
Im Vergleich zu anderen Ticketplattformen wie Ticketmaster, StubHub und Vivid Seats bietet SeatGeek oft einen anschaulicheren Sitzplatzauswahlprozess mit interaktiven Veranstaltungsortplänen und bündelt Angebote aus verschiedenen Quellen, wodurch Nutzer einen umfassenderen Überblick über verfügbare Tickets erhalten.
Während Ticketmaster jedoch in erster Linie als Primärverkäufer von Tickets (direkt vom Veranstalter) auftritt, sind SeatGeek, StubHub und Vivid Seats hauptsächlich auf dem Sekundärmarkt tätig, auf dem Tickets weiterverkauft werden – oft zu Preisen, die sich nach der Nachfrage richten.
Warum SeatGeek scrapen?
SeatGeek ist eine führende Online-Plattform, die Tickets für eine Vielzahl von Veranstaltungen sammelt und auflistet. Daher verfügt sie über eine Fülle von Informationen, die für verschiedene Interessengruppen aus unterschiedlichen Gründen von Interesse sein können, beispielsweise:
• Marktforschung und -analyse. Durch das Scraping von SeatGeek können Unternehmen und Analysten Daten zu Ticketpreistrends, der Beliebtheit von Veranstaltungen, der Kapazität von Veranstaltungsorten und vielem mehr sammeln. Diese Daten können Einblicke in die Dynamik der Unterhaltungsbranche liefern und Unternehmen dabei helfen, fundierte Entscheidungen zu treffen.
• Wettbewerbsanalyse. Konkurrierende Plattformen oder Veranstalter möchten möglicherweise die Ticketpreise, Veranstaltungslisten und andere Angebote von SeatGeek verstehen, um ihre eigenen Dienste besser zu positionieren oder potenzielle Partnerschaftsmöglichkeiten zu identifizieren.
 Foto von Pexels
• Veranstaltungssuche. Content-Aggregatoren oder Plattformen für Veranstaltungsempfehlungen könnten SeatGeek auswerten und so Zugriff auf Veranstaltungsdetails erhalten, um ihren Nutzern eine umfassende Liste bevorstehender Veranstaltungen in einer bestimmten Region zur Verfügung zu stellen.
• Preisüberwachung. Durch regelmäßiges Scraping von SeatGeek kann man den ursprünglichen Preis ermitteln und den Kaufpreis für bestimmte Veranstaltungen festlegen. Dies kann für Ticket-Wiederverkäufer, Veranstalter oder sogar Verbraucher, die nach erschwinglichen Preisen und den besten Angeboten suchen, von großem Nutzen sein.
• Datenintegration. Unternehmen, die im Veranstaltungs- oder Unterhaltungssektor tätig sind, möchten möglicherweise die Daten von SeatGeek in ihre Plattformen integrieren, um ihren Nutzern verbesserte Dienste anzubieten, wie beispielsweise Veranstaltungsempfehlungen oder Vorschläge für Reisepakete auf Basis von Veranstaltungen.
• Wissenschaftliche Forschung. Forscher, die sich mit der Unterhaltungsbranche, dem Verbraucherverhalten oder dem Veranstaltungsmanagement befassen, könnten SeatGeek-Daten auswerten, um Informationen für ihre Studien zu sammeln.
• Benachrichtigungsdienste. Entwickler können Dienste erstellen, die Nutzer benachrichtigen, sobald Tickets für bestimmte Veranstaltungen oder in einer bestimmten Preisklasse verfügbar sind. Dies ist besonders nützlich bei stark nachgefragten Veranstaltungen, die schnell ausverkauft sind.
• Trendprognosen. Durch die Analyse historischer Daten von SeatGeek lassen sich potenziell zukünftige Trends in der Unterhaltungsbranche vorhersagen, beispielsweise welche Arten von Veranstaltungen an Beliebtheit gewinnen oder verlieren.
Die Gründe für das Scraping von SeatGeek sind vielfältig und erstrecken sich über verschiedene Branchen und Interessengebiete. Ob für Business Intelligence, akademische Forschung oder den privaten Gebrauch – die auf SeatGeek verfügbaren Daten bieten wertvolle Einblicke in die Welt der Veranstaltungen und der Unterhaltungsbranche.
Die Struktur der SeatGeek-Website verstehen
SeatGeek ist eine Online-Plattform, die einen Sekundärmarkt bietet, auf dem Nutzer Tickets für verschiedene Veranstaltungen kaufen und verkaufen können. Um Daten von SeatGeek effektiv zu scrapen, ist es unerlässlich, die Struktur der Website und die Elemente zu verstehen, die extrahiert werden können.
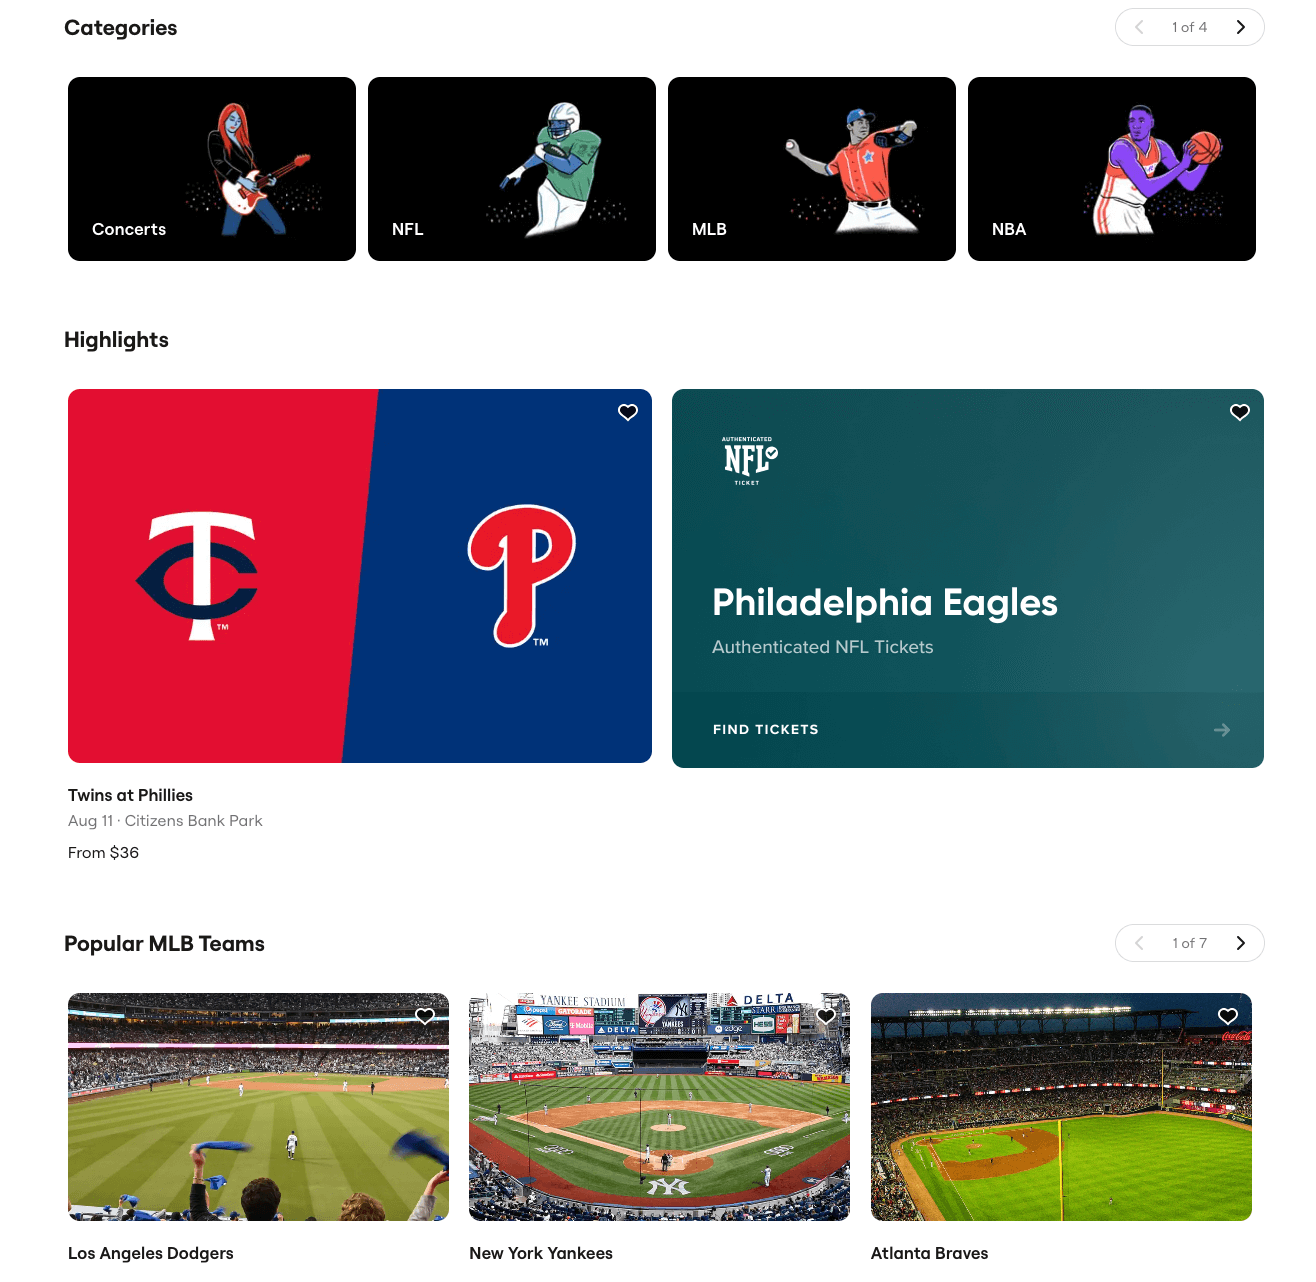
Veranstaltungsdetails
Veranstaltungsname. Der Name oder Titel der Veranstaltung.
Veranstaltungsbeschreibung. Eine kurze Beschreibung oder Zusammenfassung der Veranstaltung; kann auch kurze Veranstaltungsdetails enthalten.
Veranstaltungskategorie. Die Art oder Kategorie der Veranstaltung (z. B. Konzert, Theaterstück, Spiel).
Veranstaltungsplan. Mit der Veranstaltung verbundene Termine und Uhrzeiten.
Barrierefreie Einrichtungen. Einrichtungen oder Dienstleistungen, die am Veranstaltungsort verfügbar sind.
Ticketdetails
Ticketpreise. Dazu gehören sowohl der Anfangs- als auch der Endverkaufspreis.
Ursprünglicher Ticketpreis. Der ursprüngliche Preis des Tickets bei der ersten Veröffentlichung.
Ticketverfügbarkeit. Informationen zur Anzahl der verfügbaren oder ausverkauften Tickets.
Details zum Veranstaltungsort und zur Lage
Adresse. Die vollständige Adresse des Veranstaltungsortes.
Stadt. Die Stadt, in der die Veranstaltung stattfindet.
Postleitzahl. Die Postleitzahl des Veranstaltungsortes.
Bundesland. Das Bundesland oder die Region, in der sich der Veranstaltungsort befindet.
Standorte. Bestimmte Orte oder Bereiche innerhalb des Veranstaltungsortes.

Weitere relevante Details
Teilnehmer. Informationen zu den Teilnehmern der Veranstaltung, Online-Veranstaltungsplanern und mehr.
Referenten. Details zu Referenten oder Künstlern der Veranstaltung.
Profil des Veranstalters. Informationen zu den Veranstaltern der Veranstaltung.
Standdetails. Informationen zu Ständen oder Ausstellungsflächen auf der Veranstaltung.
Aussteller. Details zu den auf der Veranstaltung vertretenen Ausstellern.
Kontaktdaten. Kontaktinformationen zur Veranstaltung oder zu deren Veranstaltern.
Bewertungen. Feedback oder Bewertungen zur Veranstaltung oder zum Veranstaltungsort.
Verkäuferinformationen. Name und Kontaktdaten, Zahlungsdetails, Postanschrift und E-Mail-Adresse sowie Verkäuferbewertungen und -bewertungsnote.
Einschränkungen beim Web-Scraping auf SeatGeek
SeatGeek bietet zwar eine Fülle von Daten, die für verschiedene Zwecke wertvoll sein können, doch ist es unerlässlich, beim Web-Scraping mit Vorsicht vorzugehen und die Nutzungsbedingungen der Plattform sowie etwaige rechtliche Konsequenzen zu beachten.
Darüber hinaus vertritt die Rechtsabteilung von SeatGeek gemäß den Nutzungsbedingungen folgende Position zum Web-Scraping:
• Öffentliche Suchmaschinen dürfen Spider verwenden, um durchsuchbare Indizes der Materialien zu erstellen, jedoch keine Caches oder Archive dieser Materialien.
• Die auf SeatGeek verfügbaren Informationen, Inhalte und Dienste sind urheberrechtlich geschützt. Den Nutzern werden unter bestimmten Einschränkungen begrenzte Rechte zur Nutzung der Inhalte von SeatGeek gewährt.
 Foto von Vecteezy
• Nutzer dürfen keine manuellen oder automatisierten Programme, Geräte oder sonstigen Verfahren einsetzen, um Daten von Webseiten auf SeatGeek zu „scrapen“ oder herunterzuladen. Dazu gehören Spider, Roboter, Scraper, Crawler, Avatare, Data-Mining-Tools usw.
• Nutzer dürfen die Inhalte von SeatGeek nicht lizenzieren, verkaufen, vermieten oder anderweitig kommerziell verwerten. Sie dürfen zudem keinen Teil der Inhalte von SeatGeek verändern, übersetzen, anpassen oder davon abgeleitete Werke erstellen.
Web-Scraping ist zwar nützlich, wirft jedoch ethische und rechtliche Fragen auf. Es ist entscheidend, die Nutzungsbedingungen von SeatGeek einzuhalten, um sicherzustellen, dass das Scraping der Website keinen Schaden zufügt oder sie überlastet.
Darüber hinaus sollten die gescrapten Daten verantwortungsbewusst genutzt werden, wobei alle mit den Inhalten verbundenen Urheberrechte oder Eigentumsrechte zu beachten sind.
Tools zum Scrapen von SeatGeek
Es gibt verschiedene Methoden und Tools, mit denen Daten von der SeatGeek-Website gescrapt werden können. Hier finden Sie eine Übersicht über die verschiedenen Möglichkeiten, wie SeatGeek.com gescrapt werden kann:
 Foto von Vecteezy
1. Spezialisierte Web-Scraping-Dienste
Es gibt spezialisierte Web-Scraping-Dienste, die das Auslesen von Daten aus SeatGeek anbieten. Diese Dienste haben spezielle Scraper entwickelt, die darauf zugeschnitten sind, Daten aus SeatGeek und anderen ähnlichen Veranstaltungsseiten zu extrahieren.
2. Benutzerdefinierte Skripte
„Scrapetix“ ist ein auf GitHub verfügbares Skript, das dafür entwickelt wurde, Sportticket-Angebote von SeatGeek zu scrapen. Es bietet Funktionen wie das individuelle Scrapen von Tickets basierend auf Ihrer Lieblingsmannschaft, Ihrer Preisklasse und weiteren Kriterien. Außerdem unterstützt es das wiederkehrende Scrapen mit E-Mail-Benachrichtigungen bei neuen Angeboten. Das Skript nutzt PhantomJS zur Ausführung des Scraping-Prozesses.
3. Web-Scraping-Tools
• PhantomJS: Hierbei handelt es sich um einen Headless-Browser, der für das Web-Scraping verwendet wird. Er kann Webseiten rendern und JavaScript ausführen, wodurch er sich für das Scraping dynamischer Websites wie SeatGeek eignet, die bei der Darstellung von Inhalten stark auf JavaScript angewiesen sind.
• Node.js: Hierbei handelt es sich um eine JavaScript-Laufzeitumgebung, die zum Schreiben serverseitiger Skripte verwendet werden kann. In Kombination mit Bibliotheken wie Axios für HTTP-Anfragen und Cheerio zum Parsen von HTML kann Node.js ein leistungsstarkes Werkzeug für das Web-Scraping sein.
• Weitere Tools: Es stehen viele weitere Web-Scraping-Tools und -Bibliotheken zur Verfügung, wie beispielsweise Beautiful Soup, Scrapy, Puppeteer und Selenium. Je nach Struktur und Komplexität der Website kann man sich für ein bestimmtes Tool entscheiden.
4. Headless-Browser
Websites wie SeatGeek laden Inhalte möglicherweise dynamisch mithilfe von JavaScript. Herkömmliche Web-Scraping-Tools, die lediglich den HTML-Code abrufen, sind unter Umständen nicht in der Lage, diese dynamischen Inhalte zu erfassen. In solchen Fällen ist der Einsatz von Headless-Browsern wie PhantomJS, Puppeteer oder Selenium, die JavaScript rendern und ausführen können, unerlässlich.
Schritt-für-Schritt-Anleitung zum Scraping von SeatGeek mit Scrapetix
Das Scrapetix-Skript bietet ein Framework für das Scraping von SeatGeek. Es ermöglicht ein individuelles Ticket-Scraping basierend auf den Präferenzen des Nutzers, wie beispielsweise Lieblingsmannschaft und Preisklasse. Das Skript unterstützt zudem wiederkehrendes Scraping mit E-Mail-Benachrichtigungen bei neuen Angeboten. Mit Scrapetix können Sie die Konfigurationsdatei im laufenden Betrieb bearbeiten, ohne das Skript neu starten zu müssen.
1. Voraussetzungen
Bevor Sie beginnen, stellen Sie sicher, dass Folgendes vorhanden ist:
• Eine funktionierende Installation von Node.js.
• Git muss auf Ihrem System installiert sein.
2. Das Repository klonen
Klonen Sie das Scrapetix-Repository von GitHub auf Ihren lokalen Rechner.

3. Zum Verzeichnis wechseln
Wechseln Sie in das geklonte Repository.
4. PhantomJS installieren
Installieren Sie PhantomJS mit der für Ihr Betriebssystem geeigneten Methode. Unter macOS können Sie beispielsweise Homebrew verwenden.
5. Erforderliche Pakete installieren
Installieren Sie die für das Skript erforderlichen Node.js-Pakete.

6. Konfiguration
E-Mail-Konfiguration. Um Deal-Benachrichtigungen per E-Mail zu erhalten, erstellen Sie eine Datei „private.yml“ im Stammverzeichnis des Projekts und fügen Sie Ihre E-Mail-Daten hinzu.
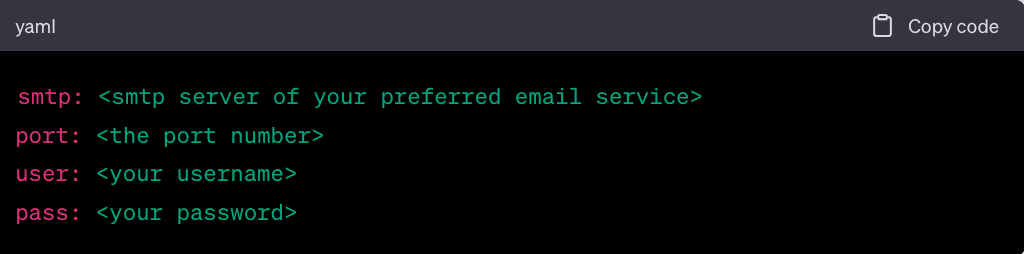
• Individuelle Konfiguration. Passen Sie die Datei „config.yml“ an, um Ihre Einstellungen festzulegen.
Geben Sie Ihre E-Mail-Adresse ein.

Wählen Sie die URL Ihres Lieblingsteams aus. Zum Beispiel für die Pittsburgh Penguins.

Legen Sie den Standort anhand des Teamnamens fest.

Passen Sie das Intervall zwischen zwei aufeinanderfolgenden Abrufen an.

Legen Sie Ihre Filterkriterien für die Tickets fest, die Sie abrufen möchten.

7. Skript ausführen
Verwenden Sie PhantomJS, um das Scraping-Skript auszuführen.

8. Auf Benachrichtigungen achten
Wenn das Skript Ticketangebote findet, die Ihren Kriterien entsprechen, sendet es E-Mail-Benachrichtigungen an die angegebene E-Mail-Adresse.
9. Das Skript beenden
Um das Skript zu beenden, drücken Sie einfach STRG + C im Terminal.
10. Datenanalyse
Das Skript generiert Daten basierend auf Ihren Kriterien. Sie können diese Daten analysieren, um die besten Ticketangebote für Ihre Vorlieben zu finden.
11. Speichern und Analysieren der gesammelten Daten
Sobald die Daten gesammelt wurden, können sie zur weiteren Analyse in einer CSV-Datei, einer Datenbank oder anderen Speichersystemen gespeichert werden. Die Daten können aufbereitet werden, um Störsignale zu entfernen und sicherzustellen, dass nur relevante Echtzeitinformationen erhalten bleiben.
Tipps und Tricks für erfolgreiches Scraping auf SeatGeek
 Foto von Vecteezy
• Überprüfen Sie stets die robots.txt-Datei von SeatGeek, um zu erfahren, welche Teile der Website gescrapt werden dürfen.
• Halten Sie von Zeit zu Zeit angemessene Intervalle zwischen den Anfragen ein, um eine Überlastung der Website oder eine Sperrung zu vermeiden.
• Aktualisieren Sie das Scraping-Skript regelmäßig, um es an etwaige Änderungen in der Struktur der Website anzupassen.
• Verwenden Sie Filter und Kriterien, um sicherzustellen, dass nur relevante Daten gescrapt werden.
• Umgehen Sie Beschränkungen, indem Sie User-Agents und Ihre IP-Adresse wechseln. Geonode bietet unbegrenzte und pay-as-you-go Residential-Proxys an, die Sie zur Verteilung der Anfragen nutzen können.
Sind Sie bereit für Web-Scraping bei SeatGeek?
Die riesige Datenmenge, die auf Veranstaltungs-Ticket-Suchmaschinen wie SeatGeek verfügbar ist, bietet eine wahre Fundgrube an Erkenntnissen für verschiedene Interessengruppen – von Veranstaltungsbegeisterten bis hin zu Marktanalysten.
Web-Scraping kann – sofern es ethisch und verantwortungsbewusst durchgeführt wird – diese Erkenntnisse erschließen und einen Wettbewerbsvorteil in der sich ständig weiterentwickelnden Welt der Veranstaltungen und Unterhaltung verschaffen.
Mit den richtigen Tools und Techniken kann jeder diese Daten für wertvolle Zwecke nutzen. Denken Sie jedoch stets daran, beim Web-Scraping Rücksicht auf die Dienste, die Richtlinien der Plattform und rechtliche Aspekte zu nehmen. So wie die Landschaft der Online-Daten weiter wächst, wächst auch das Potenzial für Innovation und neue Erkenntnisse.

