

Scrapy ist ein Open-Source-Framework für das Web-Crawling, das von jedem im Internet kostenlos genutzt werden kann. Scrapy wird hauptsächlich für das Web-Crawling und Web-Scraping verwendet. Es bietet eine schnelle und einfache Möglichkeit, Daten aus beliebigen Webseiten zu extrahieren, und wird derzeit von Zyte gepflegt.
Installation von Scrapy
Um Scrapy zu installieren, benötigen Sie Python Version 3.7 oder höher. Es wird außerdem empfohlen, Scrapy in einer eigenen virtualenv-Umgebung zu installieren, um mögliche Konflikte mit Ihren Systempaketen zu vermeiden.
Laden Sie Scrapy auf Ihrer bevorzugten Plattform herunter.
Um Scrapy zu installieren, müssen Sie Anaconda oder Miniconda installieren, Python öffnen und den folgenden Befehl ausführen:
conda install -c conda-forge scrapy
Alternativ können Sie auch folgenden Befehl ausführen:
pip install Scrapy
Wenn Sie ein Ubuntu-System verwenden, müssen Sie zunächst alle folgenden Abhängigkeiten installieren:
sudo apt-get install python3 python3-dev python3-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
Wenn Sie ein macOS-System verwenden, müssen Sie die Xcode-Befehlszeilentools installieren. Öffnen Sie dazu ein Terminalfenster und führen Sie folgenden Befehl aus:
xcode-select --install
Herzlichen Glückwunsch! Sie haben Scrapy auf Ihrem Gerät installiert. Nun können wir versuchen, eine Website zu crawlen und deren Daten zu extrahieren.
Ein Scrapy-Projekt starten
Um ein neues Scrapy-Projekt zu starten, müssen Sie ein Verzeichnis angeben, in dem Ihr Code gespeichert werden soll. Führen Sie dazu folgenden Befehl aus:
scrapy startproject scrapetest
Durch die Ausführung dieses Befehls wird ein Verzeichnis namens „scrapetest“ erstellt, das folgende Inhalte enthält:
_scrapetest/ scrapy.cfg # Konfigurationsdatei für den Einsatz
scrapetest/             # Python-Modul des Projekts; von hier aus importieren Sie Ihren Code
    __init__.py

    items.py

    middlewares.py

    pipelines.py

    settings.py

    spiders/          # ein Verzeichnis, in das Sie später Ihre Spiders ablegen werden
        __init__.py
_
Nachdem Sie ein Scrapy-Projekt gestartet haben, müssen Sie nun einen Spider erstellen. Ein Spider ist notwendig, da Scrapy ihn verwendet, um Informationen aus einer Webseite zu extrahieren. Als Beispiel werden wir die Website „quotes.toscrape.com“ scrapen.
Zunächst müssen Sie den folgenden Code ausführen:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" # Spider-Namen sollten eindeutig sein für jeden Spider, den Sie erstellen
def start_requests(self):
    urls = [
        'https://quotes.toscrape.com/page/1/',
        # Ändere diese URLs in
Webseiten, die du scrapen möchtest 'https://quotes.toscrape.com/page/2/', ] for url in urls: yield scrapy.Request(url=url, callback=self.parse)
def parse(self, response):
    page = response.url.split("/")[-2]
    filename = f'quotes-{page}.html'
    with open(filename, 'wb') as f:
        f.write(response.body)
    self.log(f'Datei {filename} gespeichert')
_
Damit der Spider mit dem Crawlen beginnt, müssen Sie folgenden Befehl ausführen:
scrapy crawl test
Sie sollten dann eine Ausgabe erhalten, die anzeigt, dass Sie die Website „quotes.toscrape.com“ gecrawlt haben.
Wenn Sie bestimmte Daten aus einer Webseite extrahieren möchten, können Sie das Python-Schlüsselwort „yield“ verwenden und den folgenden Code ausführen:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', 'https://quotes.toscrape.com/page/2/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }
_
Dieser Code extrahiert die Texte, den Autor und die Tags aus der von dir gecrawlten Webseite, die im Protokoll angezeigt werden.
Wenn du alle Seiten einer Website crawlen möchtest, anstatt nur bestimmte Seiten, kannst du Folgendes ausführen:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }

    next_page = response.css('li.next a::attr(href)').get()
    if next_page is not None:
        next_page = response.urljoin(next_page)
        yield scrapy.Request(next_page, callback=self.parse)
_
Nun müssen Sie die vom Spider extrahierten Daten speichern. Um die gescrapten Daten zu speichern, führen Sie einfach folgenden Befehl aus:
scrapy crawl test -O test.json
Wenn Sie neue Inhalte an eine bereits vorhandene Datei anhängen möchten, können Sie stattdessen diesen Code ausführen:
scrapy crawl quotes -o quotes.jsonl
Herzlichen Glückwunsch! Sie haben die Extraktion und Speicherung der mit Scrapy gescrapten Daten abgeschlossen. Sie können noch etwas hinzufügen, um sicherzustellen, dass das Web-Scraping mit Scrapy erfolgreich verläuft, nämlich die Verwendung von Scrapy-Proxys.
Scrapy-Proxys konfigurieren
Ein Scrapy-Proxy wickelt alle Ihre Webanfragen für Sie ab, sodass jede Website, die Sie scrapen, nur die IP-Adresse des Proxy-Servers sieht. Ihre IP-Adresse bleibt vollständig verborgen. Durch den ständigen Wechsel der IP-Adressen und die Verwendung von Residential-Proxys wird den Websites vorgetäuscht, dass Ihre Anfragen von echten Nutzern stammen und nicht von jemandem, der einen Web-Scraping-Bot wie Scrapy einsetzt.
Als Beispiel verwenden wir einen Geonode-Proxy. Sie können direkt zum Abschnitt „Proxy-Server-Details mit Geonode abrufen“ springen, falls Sie Ihre Geonode-Proxy-Details noch nicht erhalten haben.
Es gibt zwei Methoden, um einen Proxy in Scrapy einzurichten.
Die erste Methode nutzt die Scrapy-Middleware namens HTTPProxyMiddleware, die Ihren Proxy-Parameter automatisch als Standard-Proxy einrichtet.
Sie können folgenden Code ausführen:
_def start_requests(self): for url in self.start_urls: return Request(url=url, callback=self.parse, headers={"User-Agent": "My UserAgent"}, meta={"proxy": "premium-residential.geonode.com:9001"}) _
Die zweite Methode wäre, eine eigene Middleware zu erstellen. Diese Methode ist isolierter und bietet Ihnen einen größeren Spielraum.
Sie können Folgendes ausführen:
_from w3lib.http import basic_auth_header
DOWNLOADER_MIDDLEWARES = { 'myproject.middlewares.CustomProxyMiddleware': 350, 'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 400, }
class CustomProxyMiddleware(object): def process_request(self, request, spider): request.meta[„proxy“] = "premium-residential.geonode.com:9001" request.headers[„Proxy-Authorization“] = basic_auth_header(„geonode_xbYe9H2LYr“, „9806022c-cd4a-4776-a053-73fee44344dd“) _
Herzlichen Glückwunsch! Sie haben einen Proxy-Server hinzugefügt, der beim Scrapen beliebiger Websites mit Scrapy zum Einsatz kommt. Wenn Sie überprüfen möchten, ob Ihr Proxy funktioniert, können Sie https://www.geonode.com/what-is-my-ip aufrufen.
Abrufen der Proxy-Server-Daten mit Geonode
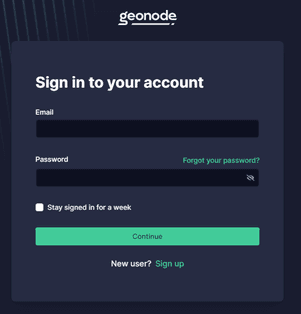
Schritt 1. Rufen Sie **Geonode
** auf und melden Sie sich mit Ihrem bestehenden Konto an oder registrieren Sie sich, um ein neues Konto zu erstellen.
Schritt 2. Klicken Sie auf der Startseite auf „Residential Services“.

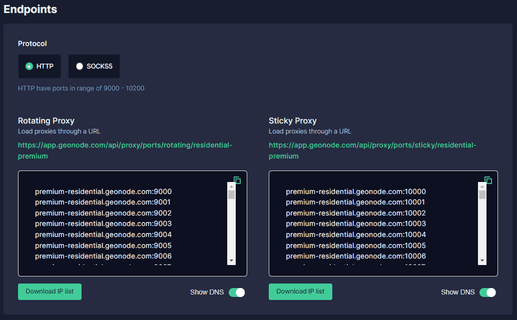
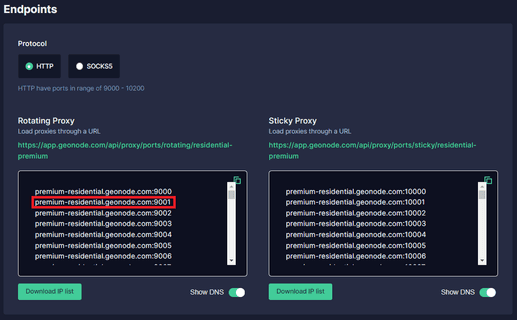
Schritt 3. Scrollen Sie nach unten, bis Sie „Endpoints“ sehen.
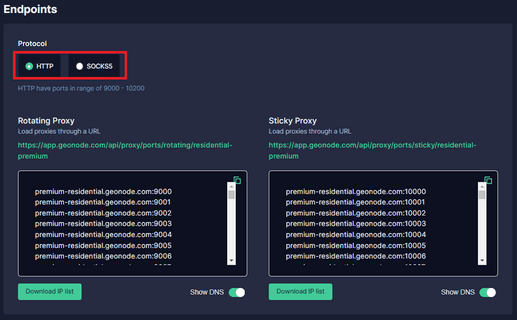
Schritt 4. Wählen Sie aus, welches „Proxy-Protokoll“ Sie verwenden möchten: „HTTP-Protokoll“ oder **„[SOCKS5
-Protokoll](https://geonode.com/blog/beginners-guide-to-socks5-proxies)“**.
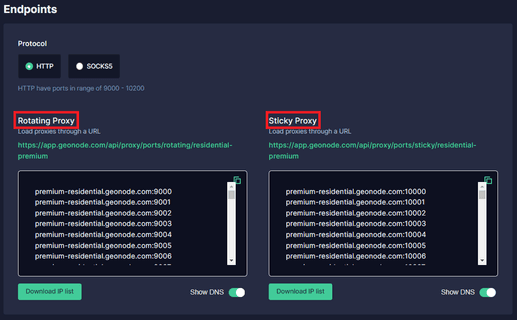
Schritt 5. Wählen Sie den gewünschten „Session-Typ“ aus: „Rotating Proxy“ oder Sticky Proxy.
Schritt 6. Wählen Sie den Proxy aus, den Sie verwenden möchten. Als Beispiel verwenden wir den hervorgehobenen Proxy **„premium-residential.geonode
.com:9001“**.
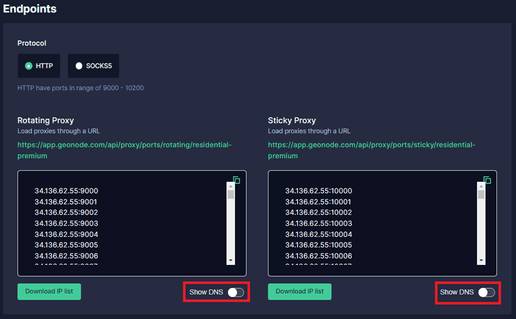
Wenn Sie statt eines DNS eine IP-Adresse verwenden möchten, deaktivieren Sie einfach die Schaltfläche „DNS anzeigen“ – daraufhin werden die IP-Adressen angezeigt.
Schritt 7. Nun benötigen Sie die „Authentifizierungsdaten“ Ihres Proxy-Kontos. Bei Geonode
finden Sie diese auf der Startseite Ihres Kontos.
