Stellen Sie sich Folgendes vor: Mit nur wenigen Zeilen Code erschließen Sie sich eine Fülle von Daten von Subito.it, Italiens führendem Online-Marktplatz.
Das ist nicht nur ein raffinierter Tech-Hack, sondern ein revolutionärer Schritt für alle, die datengestützte Entscheidungen ernst nehmen.
Ganz gleich, ob Sie das Verbraucherverhalten besser verstehen, mit dynamischer Preisgestaltung die Nase vorn behalten oder der Konkurrenz einen Schritt voraus sein möchten – das Web-Scraping von Subito.it ist Ihr Schlüssel zum Erfolg.
Tauchen Sie in diesen Leitfaden ein und erfahren Sie, wie Sie Ihre Geschäftsstrategie optimieren können, indem Sie die datenreiche Welt von Subito.it für sich nutzen.
Was ist Subito.it?
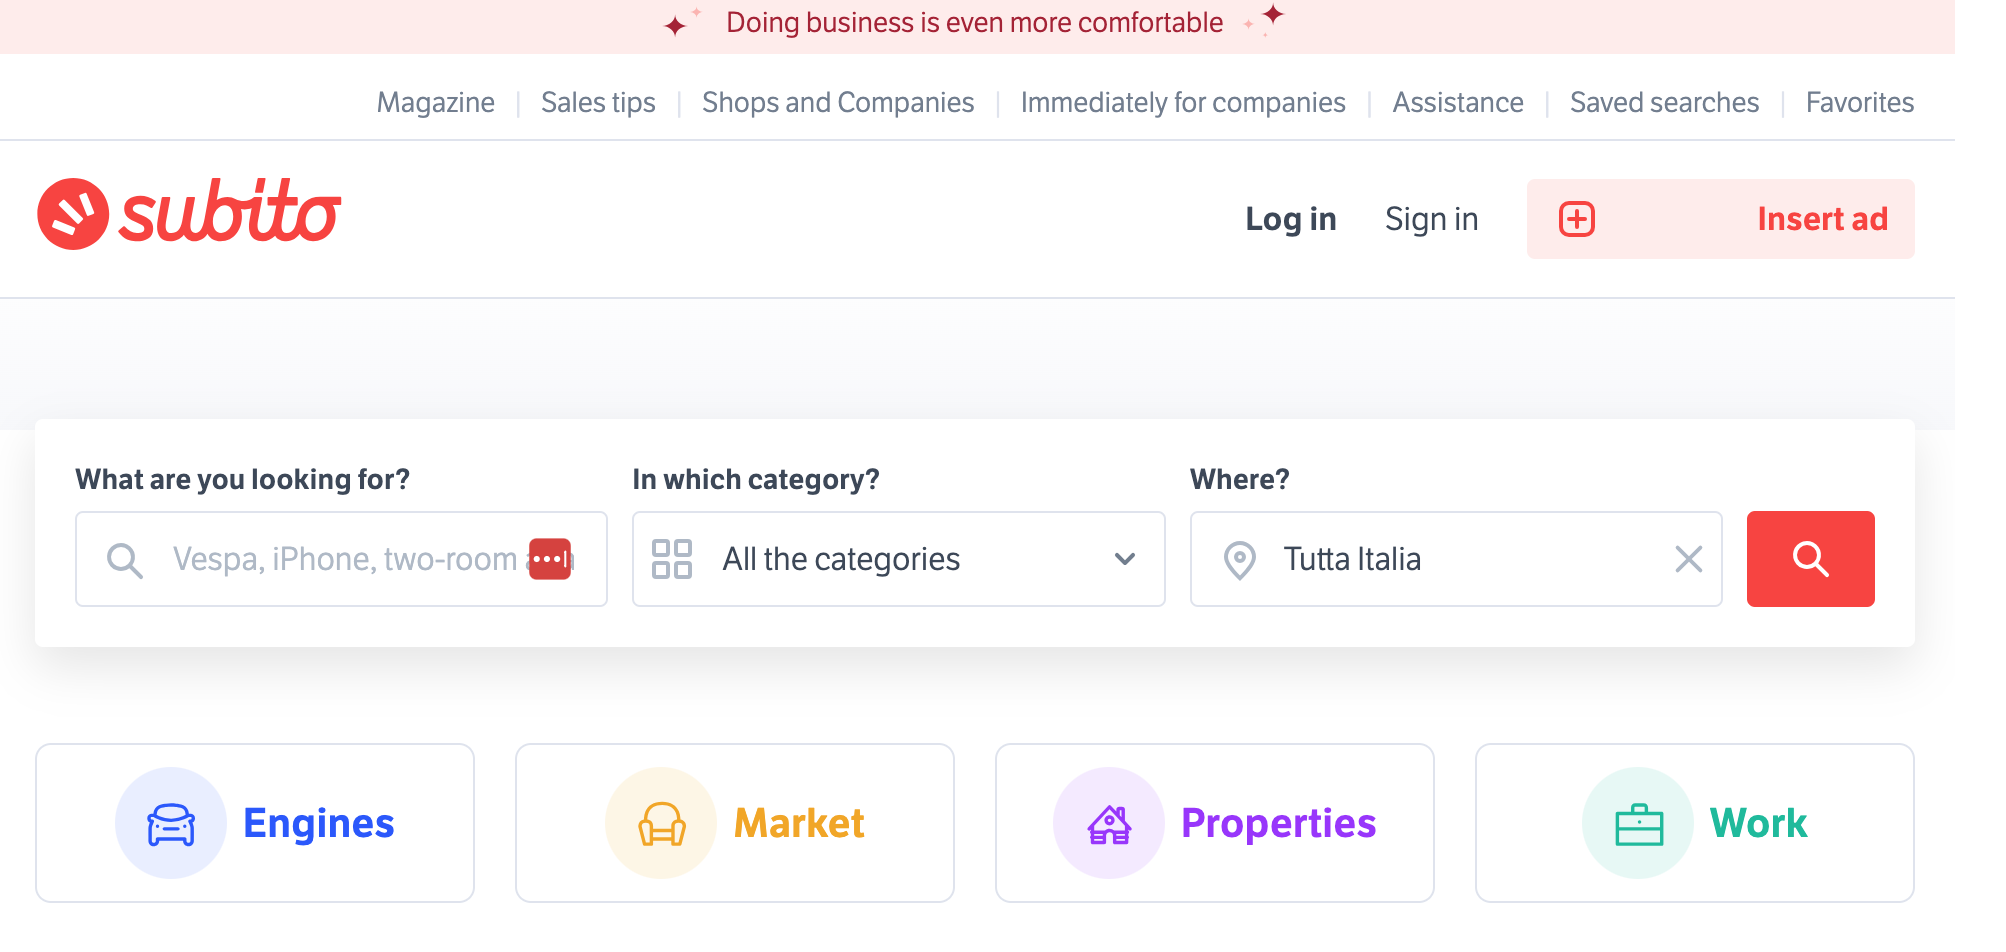
Subito.it ist eine italienische Online-Plattform, auf der Nutzer neue und gebrauchte Artikel kaufen und verkaufen können.
Die Website bietet eine große Auswahl an Kategorien, darunter Fahrzeuge, Markt, Immobilien und Stellenangebote.
Nutzer können lokale Anzeigen für Autos, Häuser, Elektronik, Möbel, Haustiere und vieles mehr schalten.
Die Plattform bietet außerdem verschiedene Funktionen, um Transaktionen sicherer und bequemer zu gestalten, wie beispielsweise Sendungsverfolgung und sichere Zahlungsoptionen.
Warum Subito.it scrapen?
Web-Scraping hat sich zu einem unverzichtbaren Werkzeug in der modernen Geschäftswelt entwickelt, und Subito.it, einer der größten Online-Marktplätze Italiens, bietet eine Fülle von Daten, die für verschiedene Anwendungen von unschätzbarem Wert sein können.
Die Bedeutung der Subito.it-Daten im E-Commerce
Subito.it ist nicht nur ein weiterer Online-Marktplatz, sondern eine wahre Goldgrube an Daten für alle im E-Commerce.
Mit Millionen von Angeboten in Kategorien wie Kraftfahrzeuge, Immobilien, Stellenangebote und Konsumgüter bietet die Plattform einen umfassenden Überblick über Markttrends, Verbraucherpräferenzen und Preisstrategien.
Durch das Scraping von Subito.it können Unternehmen in Echtzeit auf diese Daten zugreifen, was eine agilere und fundiertere Entscheidungsfindung ermöglicht.
Wenn Sie beispielsweise ein Online-Händler sind, können Sie Subito.it scrapen, um die durchschnittlichen Preise von Produkten zu ermitteln, die Ihren eigenen ähnlich sind, und Ihre Preisstrategie entsprechend anpassen.
Ebenso können Immobilienunternehmen Anzeigen auswerten, um den Marktwert von Immobilien in verschiedenen Regionen einzuschätzen.
Daten von Subito.it lassen sich auch für die Stimmungsanalyse nutzen und helfen Unternehmen dabei, zu verstehen, wonach Kunden suchen und wie sie zu bestimmten Produkten oder Dienstleistungen stehen.
Anwendungsfälle für das Scraping von Subito.it
- Marktforschung. Das Verständnis von Markttrends ist für jedes Unternehmen von entscheidender Bedeutung.
Durch das Scraping von Subito.it können Sie Daten zu den beliebtesten Produkten, saisonalen Trends und Verbraucherbedürfnissen sammeln, was Ihnen hilft, Ihr Angebot entsprechend anzupassen.
- Wettbewerbsanalyse. Mit Web-Scraping ist es einfacher denn je, Ihre Wettbewerber im Auge zu behalten. Extrahieren Sie Daten zu Produktangeboten, Kundenbewertungen und Preisstrategien, um zu sehen, wie Sie im Vergleich zur Konkurrenz abschneiden.
- Dynamische Preisgestaltung. In einem schnelllebigen Markt kann eine statische Preisgestaltung von Nachteil sein. Durch das Scraping von Subito.it können Sie Preisentwicklungen in Echtzeit beobachten und Ihre Preise spontan anpassen, um Gewinne oder Marktanteile zu maximieren.
- Lead-Generierung. Für dienstleistungsorientierte Branchen oder B2B-Unternehmen kann Subito.it eine Quelle für potenzielle Leads sein. Erfassen Sie Kontaktdaten und Serviceanfragen, um einen zielgerichteten Verkaufstrichter aufzubauen.
- Stimmungsanalyse. Kundenbewertungen und Kommentare auf Subito.it können für eine Stimmungsanalyse erfasst werden und liefern Einblicke in die öffentliche Meinung sowie in Bereiche mit Verbesserungspotenzial.
Fallstudien und Beispiele aus der Praxis
-
Autohaus. Ein lokales Autohaus kann Daten von Subito.it nutzen, um die Nachfrage nach Elektroautos in seiner Region zu erfassen. Durch das Auslesen von Angeboten und Kundenanfragen kann es sich mit den gefragtesten Modellen eindecken, was zu einem Umsatzanstieg von 20 % führt.
-
Modehändler. Ein Modehändler kann Daten von Subito.it auswerten, um die Beliebtheit verschiedener Bekleidungsmarken und -stile zu analysieren. Dieser datengestützte Ansatz ermöglicht eine maßgeschneiderte Bestandsplanung, was zu einem effizienteren Lagerverwaltungssystem und höheren Umsätzen führt.
-
Immobilienunternehmen. Ein Immobilienunternehmen kann Subito.it scrapen, um Daten zu Immobilienpreisen in verschiedenen Stadtvierteln zu sammeln. Diese Informationen können zur Entwicklung eines dynamischen Preismodells genutzt werden, das die Immobilienpreise auf Basis der Marktbedingungen in Echtzeit anpasst und so den Umsatz erheblich optimiert.
Wenn man die Bedeutung, die Anwendungsfälle und die praktischen Einsatzmöglichkeiten des Scrapings von Subito.it versteht, wird deutlich, dass diese Vorgehensweise nicht nur eine technische Übung ist, sondern eine strategische Notwendigkeit für moderne Unternehmen darstellt.
Möglichkeiten zum Scraping von Subito.it
Das Scraping von Subito.it lässt sich auf verschiedene Arten angehen, wobei jede ihre eigenen Vor- und Nachteile hat.
Egal, ob Sie ein Programmieranfänger oder ein erfahrener Entwickler sind – es gibt eine Methode, die Ihren Anforderungen entspricht.
Manuelles Scraping
Was es ist: Manuelles Scraping ist die einfachste Methode und erfordert keine Programmierkenntnisse.
Dabei besuchen Sie die Website von Subito.it manuell und kopieren die benötigten Daten.
So geht’s:
-
- Öffnen Sie Ihren Browser. Rufen Sie Subito.it in Ihrem Webbrowser auf.
- Inserate suchen. Nutzen Sie die Suchleiste oder die Kategoriefilter, um die Inserate zu finden, die Sie interessieren.
- Daten kopieren. Kopieren Sie die Daten manuell und fügen Sie sie in eine Tabelle oder ein Dokument ein.
Vor- und Nachteile:
-
- Vorteile: Einfach durchzuführen, keine technischen Kenntnisse erforderlich.
- Nachteile: Äußerst zeitaufwendig, für große Datensätze unpraktisch, anfällig für menschliche Fehler.
Am besten geeignet für: Kleinere Projekte oder schnelle, einmalige Aufgaben zum Abrufen von Daten.
Code schreiben
Was es ist: Dabei werden Skripte geschrieben, um den Scraping-Prozess zu automatisieren. Die dafür am häufigsten verwendeten Sprachen sind Python und JavaScript.
So geht’s:
-
- Wählen Sie eine Bibliothek aus. Beliebte Optionen sind Bibliotheken wie BeautifulSoup für Python oder Puppeteer für JavaScript.
- Untersuchen Sie die Elemente. Verwenden Sie die Entwicklertools Ihres Browsers, um die HTML-Elemente zu untersuchen, die die gewünschten Daten enthalten.
- Schreiben Sie den Code. Schreiben Sie ein Skript, um zu Subito.it zu navigieren, die Datenpunkte zu finden und sie zu extrahieren.
- Führen Sie das Skript aus. Führen Sie das Skript aus, um die Daten zu erfassen.
Vor- und Nachteile:
-
- Vorteile: Hochgradig anpassbar, kann große Datensätze verarbeiten, minimiert menschliche Fehler.
- Nachteile: Erfordert Programmierkenntnisse, erfordert möglicherweise Anpassungen, wenn sich die Struktur der Website ändert.
Am besten geeignet für: Mittelgroße bis große Projekte, bei denen Anpassbarkeit und Skalierbarkeit erforderlich sind.
Verwendung von Scrapern von Drittanbietern
Was es ist: Hierbei handelt es sich um vorgefertigte Software oder Plattformen, die dafür entwickelt wurden, Daten von Websites zu extrahieren.
So geht’s:
-
- Wählen Sie einen Scraper aus. Recherchieren Sie und wählen Sie einen Scraper eines Drittanbieters aus, der Ihren Anforderungen entspricht.
- Konfigurieren Sie den Scraper. Die meisten dieser Tools bieten eine grafische Benutzeroberfläche (GUI), in der Sie die Daten, die Sie extrahieren möchten, per Mausklick auswählen können.
- Starten Sie den Scraper. Starten Sie den Scraping-Vorgang. Einige Tools bieten cloudbasierte Lösungen an, sodass Sie den Scraper nicht auf Ihrem eigenen Rechner ausführen müssen.
Vor- und Nachteile:
-
- Vorteile: Benutzerfreundlich, keine Programmierkenntnisse erforderlich, oft mit integrierten Funktionen wie IP-Rotation.
- Nachteile: Kann teuer sein, weniger anpassbar als eine selbst programmierte Lösung.
Am besten geeignet für: Alle, die eine einfachere, weniger technische Methode benötigen, um Daten in großem Umfang zu scrapen.
Wenn Sie diese Methoden verstehen, können Sie diejenige auswählen, die am besten zum Umfang Ihres Projekts und zu Ihren technischen Kenntnissen passt. Jede hat ihre Vor- und Nachteile, aber alle sind praktikable Wege, um die umfangreichen Datenressourcen von Subito.it zu nutzen.
Benötigte Tools
Das Schreiben von Code ist eine der gängigsten Methoden zum Scraping von Subito.it, da es ein hohes Maß an individueller Anpassung ermöglicht.
Das Programmieren ist jedoch nur ein Teil des Ganzen. Um eine Website effektiv zu scrapen, benötigen Sie eine Reihe von Tools, die verschiedene Aspekte des Scraping-Prozesses abdecken.
Dieser Abschnitt bietet einen allgemeinen Überblick über die wesentlichen Tools, die Sie zum Scrapen von Subito.it benötigen.
Web-Scraping-Bibliotheken
Web-Scraping-Bibliotheken sind vorgefertigte Code-Pakete, die das Extrahieren von Daten aus Websites vereinfachen.
Sie übernehmen die technischen Details der Navigation durch HTML und HTTP, sodass Sie sich auf die gewünschten Daten konzentrieren können.
Python-Bibliotheken zum Scraping von Subito.it:
- Beautiful Soup. Beautiful Soup ist ideal für Anfänger und erleichtert das Scraping von Informationen aus Webseiten, indem es Python-typische Konstrukte zum Durchlaufen, Suchen und Ändern des Parse-Baums bereitstellt.
- Scrapy. Scrapy eignet sich eher für das Web-Scraping in großem Maßstab und ist ein Open-Source-Framework, das alle Werkzeuge bereitstellt, die Sie zum Crawlen von Websites und zum Extrahieren von Daten benötigen.
- Selenium. Selenium ist zwar streng genommen keine Web-Scraping-Bibliothek, eignet sich jedoch für Websites, die Daten dynamisch mit JavaScript laden.
Premium-Proxys
Proxys fungieren als Vermittler zwischen Ihrem Computer und der Website, die Sie scrapen, und verbergen dabei Ihre IP-Adresse. Geonode-Proxys sind für ihre Effizienz und Sicherheit bekannt.
Wie Geonode-Proxys Ihr Scraping effizienter und sicherer machen können:
- IP-Rotation. Geonode-Proxys wechseln automatisch die IP-Adressen und verringern so das Risiko, von Subito.it blockiert zu werden.
- Geschwindigkeit. Geonode bietet Hochgeschwindigkeits-Proxys, die sicherstellen, dass Ihre Scraping-Aufgaben schnell erledigt werden.
- Sicherheit. Bei Geonode werden Ihre Daten verschlüsselt, was eine zusätzliche Sicherheitsebene bietet.
Geonode verfügt über ein Dashboard, in dem Sie Ihre Proxy-Einstellungen konfigurieren können. Nach der Konfiguration können Sie diese in Ihren Scraping-Code integrieren.
Unverzichtbare Browser-Erweiterungen
Browser-Erweiterungen können den Web-Scraping-Prozess unterstützen, indem sie Ihnen helfen, die Struktur einer Website zu verstehen, oder indem sie einige manuelle Aufgaben automatisieren.
- Web Scraper: Mit dieser Chrome-Erweiterung können Sie einen Plan konfigurieren und Daten direkt aus Ihrem Browser scrapen.
- Data Miner: Data Miner eignet sich besonders zum Scraping von Tabellen oder Listen und kann Ihnen bei der Vorrecherche Zeit sparen.
- Selector Gadget: Diese Erweiterung hilft Ihnen, CSS-Selektoren schnell zu finden, was beim Schreiben Ihres Scraping-Codes nützlich sein kann.
Diese Erweiterungen finden Sie im Chrome Web Store. Suchen Sie einfach nach der Erweiterung und klicken Sie auf „Zu Chrome hinzufügen“.
Mit diesen unverzichtbaren Tools sind Sie auf dem besten Weg, Daten von Subito.it effektiv und effizient zu extrahieren. Ganz gleich, ob Sie Anfänger oder erfahrener Programmierer sind – diese Tools bieten Ihnen die Grundlage, die Sie benötigen, um wertvolle Daten aus Subito.it zu extrahieren.
Einrichten Ihrer Umgebung
Bevor Sie mit dem eigentlichen Scraping-Vorgang beginnen, ist es entscheidend, eine geeignete Umgebung einzurichten, die ein effizientes und effektives Web-Scraping unterstützt. Dieser Abschnitt dient als allgemeine Anleitung, die Ihnen dabei hilft, Ihr System für das Scraping von Subito.it vorzubereiten.
Installation der erforderlichen Software
Um Daten von Subito.it zu scrapen, benötigen Sie einen Code-Editor, eine Python-Umgebung und bestimmte Bibliotheken, die das Web-Scraping erleichtern.
Software-Einrichtung für das Scraping von Subito.it:
-
Code-Editor. Wählen Sie einen Code-Editor, in dem Sie Ihr Scraping-Skript schreiben möchten. Beliebte Optionen sind Visual Studio Code, PyCharm oder Jupyter Notebook für eher datenorientierte Projekte.
-
Python-Umgebung. Falls Sie Python noch nicht installiert haben, laden Sie es von der offiziellen Website herunter und installieren Sie es. Achten Sie darauf, auch pip (Pythons Paketmanager) zu installieren.
-
Web-Scraping-Bibliotheken: Installieren Sie die Python-Bibliotheken, die Sie für das Scraping verwenden werden. Öffne dein Terminal und führe die folgenden Befehle aus: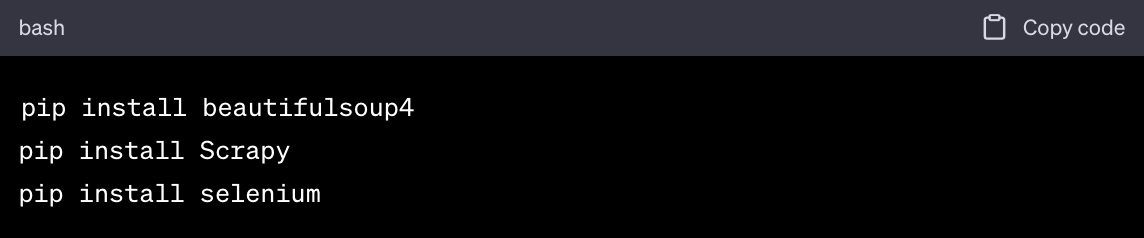
-
Browser und Treiber: Wenn du Selenium verwendest, benötigst du außerdem einen Web-Treiber, der zu deinem Webbrowser passt (z. B. ChromeDriver für Google Chrome).
Installationsschritte:
- Laden Sie den Code-Editor Ihrer Wahl herunter und befolgen Sie die Installationsanweisungen.
- Installieren Sie Python und stellen Sie sicher, dass Sie das Kontrollkästchen aktivieren, das Python zu Ihrem PATH hinzufügt.
- Öffnen Sie Ihr Terminal und führen Sie die pip-Befehle aus, um die Web-Scraping-Bibliotheken zu installieren.
- Laden Sie den Web-Driver für Selenium herunter und speichern Sie ihn in einem Verzeichnis, das im PATH Ihres Systems enthalten ist.
Konfiguration der Proxys von „Geonode“
-
Registrieren Sie sich bei „Geonode“. Besuchen Sie die Geonode-Website und erstellen Sie ein Konto. Wählen Sie einen Tarif, der Ihren Anforderungen entspricht.
-
Rufen Sie das Dashboard auf. Melden Sie sich bei Ihrem Geonode-Konto an und navigieren Sie zum Dashboard.
-
Erstellen Sie einen Proxy-Pool. Suchen Sie im Dashboard nach der Option zum Erstellen eines neuen Proxy-Pools. Folgen Sie den Anweisungen, um Ihren Pool einzurichten, und geben Sie dabei die Länder oder Städte an, aus denen Ihre IP-Adressen stammen sollen.
-
Proxy-Details abrufen. Sobald der Pool eingerichtet ist, erhalten Sie eine Liste mit Proxy-IP-Adressen und Ports. Kopieren Sie diese Angaben.
-
In den Code integrieren. In Ihrem Scraping-Code müssen Sie Ihre Web-Scraping-Bibliothek so konfigurieren, dass Anfragen über den Proxy „Geonode“ geleitet werden. Wenn Sie beispielsweise die Python-Bibliothek „requests“ verwenden, würden Sie etwa wie folgt vorgehen: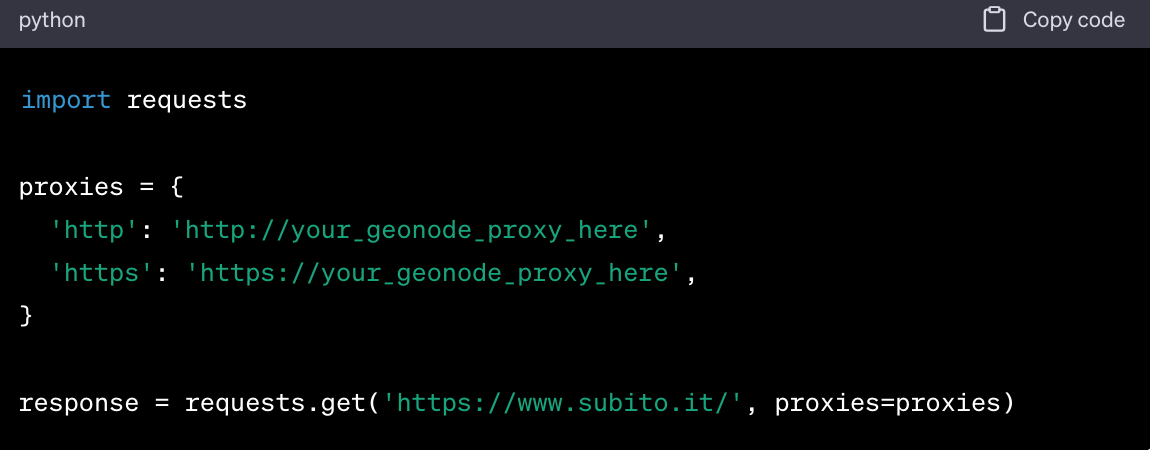
Wenn Sie diese Schritte befolgen, verfügen Sie über eine robuste Umgebung für das Scraping von Subito.it. Mit der richtigen Software und den richtigen Proxys sind Sie bestens gerüstet, um mit der Erfassung der benötigten Daten zu beginnen.
Der Scraping-Prozess
Sobald Ihre Umgebung eingerichtet ist, können Sie mit dem eigentlichen Scraping-Prozess beginnen.
Datenpunkte identifizieren
Der erste Schritt bei jedem Web-Scraping-Projekt besteht darin, genau zu bestimmen, welche Daten Sie erfassen möchten. Dies kann von Produktpreisen und -beschreibungen bis hin zu Nutzerbewertungen und vielem mehr reichen.
Welche Daten sollen von Subito.it gescrapt werden:
- Produktangebote. Informationen wie Produktname, Preis und Beschreibung.
- Verkäuferinformationen. Details wie Verkäufername, Kontaktdaten und Bewertungen.
- Nutzerbewertungen. Bewertungen und Textbewertungen von Nutzern.
- Suchergebnisse. Daten aus Suchergebnisseiten, einschließlich Ranking- und Relevanzkennzahlen.
So identifizieren Sie diese Daten:
- Untersuchen Sie die Website. Navigieren Sie durch Subito.it und identifizieren Sie die Seiten, die die Daten enthalten, an denen Sie interessiert sind.
- Verwenden Sie die Entwicklertools. Öffnen Sie die Entwicklertools Ihres Browsers, um die HTML-Struktur zu untersuchen und die Tags zu identifizieren, die Ihre gewünschten Daten enthalten.
Den Scraping-Code schreiben
Dazu müssen Sie ein Skript in Python (oder einer anderen Sprache) schreiben, das die Webseite aufruft und die von Ihnen identifizierten Datenpunkte extrahiert.
Hier ist ein vereinfachter Python-Codeausschnitt, der BeautifulSoup verwendet, um Produktnamen und Preise von einer hypothetischen Subito.it-Seite zu scrapen: 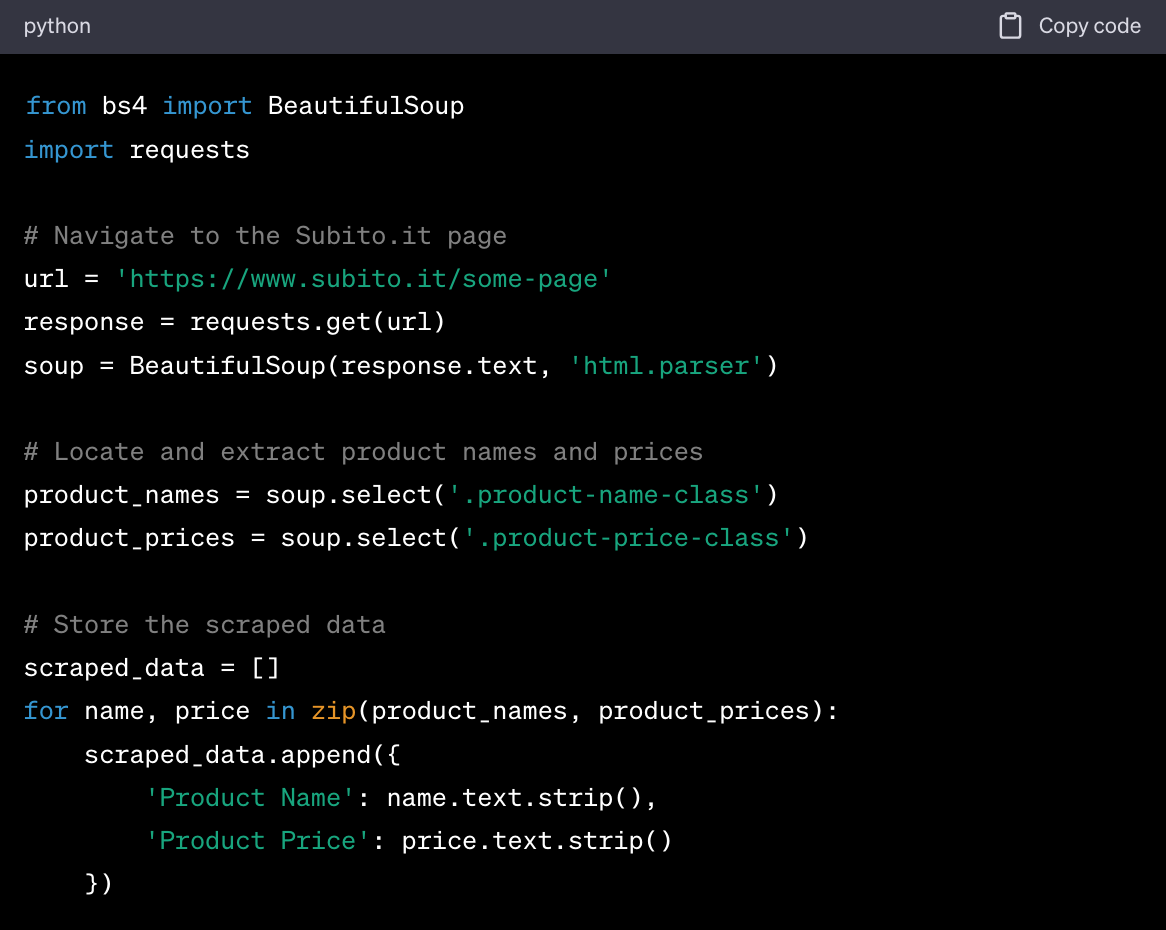
Ausführen des Scrapers
In dieser Phase führen Sie Ihren Scraping-Code aus, um die gewünschten Daten zu erfassen.
So führen Sie Ihren Scraping-Code aus und erfassen Daten
- Testen Sie in kleinem Maßstab. Bevor Sie Ihren Scraper auf Hunderten von Seiten ausführen, testen Sie ihn zunächst an einigen wenigen, um sicherzustellen, dass er wie erwartet funktioniert.
- Führen Sie den Code aus. Führen Sie Ihr Python-Skript aus. Dies kann in der Regel direkt über Ihren Code-Editor oder über die Befehlszeile erfolgen, indem Sie „
python your_script_name.py“ ausführen.
- Überwachen Sie den Prozess. Behalten Sie das Skript während der Ausführung im Auge, um sicherzustellen, dass keine Fehler oder Probleme auftreten.
- Speichern Sie die Daten. Stellen Sie sicher, dass Ihr Skript so eingerichtet ist, dass die gescrapten Daten in einem nützlichen Format gespeichert werden, beispielsweise als CSV-Datei oder in einer Datenbank.
Wenn Sie diese Schritte befolgen, sind Sie auf dem besten Weg, wertvolle Daten erfolgreich von Subito.it zu extrahieren. Mit der richtigen Vorbereitung und Durchführung kann Ihnen das Web-Scraping die Erkenntnisse liefern, die Sie benötigen, um fundierte Entscheidungen zu treffen.
Bewährte Verfahren und rechtliche Aspekte
Beim Scraping von Subito.it oder einer anderen Website ist es entscheidend, sowohl bewährte Verfahren als auch rechtliche Aspekte zu beachten.
Dadurch wird sichergestellt, dass Ihre Scraping-Aktivitäten sowohl ethisch einwandfrei sind als auch den einschlägigen Gesetzen und Vorschriften entsprechen. In diesem Abschnitt werden diese Aspekte ausführlich behandelt.
Einhaltung der „robots.txt“-Datei
Die „“-Datei ist ein Standard, den Websites verwenden, um mit Webcrawlern und anderen automatisierten Agenten zu kommunizieren und anzugeben, welche Teile der Website nicht verarbeitet oder gescannt werden dürfen.
Das Ignorieren der in der robots.txt-Datei festgelegten Richtlinien kann dazu führen, dass Ihre IP-Adresse gesperrt wird, und könnte möglicherweise rechtliche Konsequenzen nach sich ziehen.
Ratenbegrenzung und IP-Rotation
Ratenbegrenzung ist die Beschränkung der Anzahl von Anfragen, die Sie innerhalb eines bestimmten Zeitraums an eine Website stellen können. Bei der IP-Rotation wird Ihre IP-Adresse in regelmäßigen Abständen gewechselt, um eine Erkennung und Sperrung zu vermeiden.
Wie Proxys von Geonode bei der Ratenbegrenzung und IP-Rotation helfen können:
- IP-Rotation. Die Proxys von Geonode wechseln Ihre IP-Adresse automatisch, wodurch es für Websites schwierig wird, Sie zu identifizieren und zu blockieren.
- Ratenbegrenzung. Durch die Nutzung mehrerer IP-Adressen über Geonode können Sie Ihre Anfragen verteilen und so die von der Website festgelegten Ratenbegrenzungen effektiv umgehen.
- Konfiguration. Geonode-Proxys verfügen über Einstellungen, mit denen Sie die Häufigkeit und das Muster Ihrer Anfragen steuern können, was Ihnen hilft, verantwortungsbewusst zu scrapen.
Die Nichteinhaltung von Ratenbeschränkungen oder das Nichtwechseln der IP-Adressen kann dazu führen, dass Ihr Scraper gesperrt wird, wodurch Ihre Scraping-Bemühungen wirkungslos werden.
Datenspeicherung und -nutzung
Sobald Sie die Daten gescrapt haben, unterliegen deren Speicherung und Nutzung sowohl ethischen als auch rechtlichen Überlegungen.
- Speicherung. Speichern Sie die Daten in einer sicheren Umgebung, um unbefugten Zugriff zu verhindern. Oft wird eine Verschlüsselung empfohlen.
- Nutzung. Die von Ihnen gescrapten Daten sollten verantwortungsbewusst genutzt werden. Der Missbrauch von Daten für Spam, Betrug oder jegliche Form von Belästigung ist nicht nur unethisch, sondern auch illegal.
- Weitergabe. Wenn Sie beabsichtigen, die gesammelten Daten weiterzugeben, stellen Sie sicher, dass Sie dazu rechtlich berechtigt sind. Einige Websites haben Nutzungsbedingungen, die die Weitergabe gesammelter Daten untersagen.
- Quellenangabe. Wenn Sie die Daten für Forschungszwecke oder zur Berichterstattung nutzen, gehört es zum guten Ton, die Quelle anzugeben.
Eine unsachgemäße Speicherung oder unethische Nutzung von gescrapten Daten kann rechtliche Konsequenzen nach sich ziehen und Ihrem Ruf schaden.
Durch die Einhaltung dieser bewährten Vorgehensweisen und rechtlichen Überlegungen können Sie sicherstellen, dass Ihre Web-Scraping-Aktivitäten auf verantwortungsvolle und ethische Weise durchgeführt werden. Dies minimiert nicht nur das Risiko rechtlicher Probleme, sondern trägt auch zur Integrität und Zuverlässigkeit Ihrer Scraping-Projekte bei.
Fehlerbehebung und häufig gestellte Fragen
Selbst bei bester Vorbereitung können beim Scraping von Subito.it Probleme auftreten. In diesem Abschnitt werden häufige Fehler und häufig gestellte Fragen behandelt, um Ihnen zu helfen, Probleme bei Ihren Scraping-Aktivitäten effektiv zu beheben.
Häufige Fehler und Lösungen
Fehlerbehebung bei Problemen mit dem Scraping von Subito.it:
-
IP gesperrt. Wenn Ihre Anfragen abgelehnt werden, ist Ihre IP-Adresse wahrscheinlich gesperrt worden.
- Lösung: Verwenden Sie einen Proxy-Dienst wie Geonode, um Ihre IP-Adressen zu wechseln.
-
Ratenlimit überschritten. Wenn Sie innerhalb kurzer Zeit zu viele Anfragen stellen, erreichen Sie möglicherweise das Ratenlimit.
- Lösung: Fügen Sie eine Verzögerung zwischen Ihren Anfragen ein oder verteilen Sie die Anfragen auf mehrere IP-Adressen.
-
Unvollständige oder ungenaue Daten. Manchmal sammelt der Scraper möglicherweise nicht alle erforderlichen Daten oder erfasst falsche Daten.
- Lösung: Überprüfen Sie Ihren Code noch einmal, um sicherzustellen, dass Sie die richtigen HTML-Elemente ansprechen.
-
Timeout-Fehler. Ihr Scraper kann ein Timeout auslösen, wenn das Laden einer Seite zu lange dauert.
- Lösung: Erhöhen Sie das Timeout-Limit in Ihrem Code oder versuchen Sie, Ihren Scraper so zu optimieren, dass er schneller läuft.
Das wird auch oft gefragt
Häufig gestellte Fragen und deren Antworten:
-
Wie kann man Subito.it scrapen, ohne blockiert zu werden?
- Verwenden Sie Proxys, um Ihre IP-Adressen zu wechseln, und implementieren Sie eine Ratenbegrenzung, um zu vermeiden, dass Sie in kurzer Zeit zu viele Anfragen stellen. Beachten Sie außerdem die Richtlinien in der Datei „
robots.txt“ von Subito.it.
-
Ist das Scraping von Subito.it legal?
- Das Scraping öffentlicher Daten ist zwar grundsätzlich legal, es ist jedoch entscheidend, die Nutzungsbedingungen der Website und die Richtlinien unter
robots.txt einzuhalten. Der Missbrauch der gescrapten Daten kann rechtliche Konsequenzen nach sich ziehen.
-
Wie kann ich Subito.it schneller scrapen?
- Um den Scraping-Prozess zu beschleunigen, können Sie eine effizientere Scraping-Bibliothek oder ein Framework verwenden. Darüber hinaus kann die Nutzung eines Proxy-Dienstes wie Geonode dabei helfen, Ihre Anfragen auf mehrere IP-Adressen zu verteilen und so Ratenbeschränkungen effektiv zu umgehen.
Wenn Sie sich dieser häufigen Probleme und häufig gestellten Fragen bewusst sind, können Sie sich besser auf die Herausforderungen vorbereiten, die mit dem Web-Scraping einhergehen. Eine ordnungsgemäße Fehlerbehebung kann Ihnen Zeit und Ressourcen sparen und Ihr Scraping-Projekt effizienter und effektiver machen.
Fazit
Das Scraping von Subito.it bietet eine Fülle von Möglichkeiten für Unternehmen, Forscher und Datenanalysten.
Durch die Automatisierung der Datenerfassung können Sie wertvolle Einblicke in Markttrends, Verbraucherverhalten und Wettbewerbslandschaften gewinnen.
Ganz gleich, ob Sie Ihre Preisstrategie optimieren, Ihre Zielgruppe besser verstehen oder datengestützte Entscheidungen treffen möchten – das Scraping von Subito.it liefert Ihnen das nötige Rohmaterial.
Dieser Leitfaden hat alle Aspekte abgedeckt – von der Einrichtung Ihrer Umgebung und der Auswahl der richtigen Tools bis hin zu Best Practices und der Fehlerbehebung.
Ziel war es, Ihnen das Wissen und die Fähigkeiten zu vermitteln, die Sie benötigen, um Subito.it effektiv und verantwortungsbewusst zu scrapen.
Was Sie mit den gescrapten Daten tun können und wie Sie sie für den geschäftlichen Erfolg nutzen:
-
Datenbereinigung: Der erste Schritt nach dem Scraping besteht darin, die Daten zu bereinigen und zu organisieren. Dazu gehören das Entfernen von Duplikaten, der Umgang mit fehlenden Werten und gegebenenfalls die Konvertierung von Datentypen.
-
Datenanalyse. Nutzen Sie statistische Methoden oder Algorithmen des maschinellen Lernens, um die Daten zu analysieren. So können Sie Muster, Zusammenhänge oder Trends erkennen, die für Ihr Unternehmen von Nutzen sein könnten.
-
Strategische Umsetzung. Wenden Sie die aus der Analyse gewonnenen Erkenntnisse auf Ihre Geschäftsstrategien an. Wenn Sie beispielsweise Preisdaten gescrapt haben, könnten Sie diese nutzen, um Ihre eigene Preisstrategie zu optimieren.
-
Überwachung und Aktualisierung. Das Internet ist dynamisch, und Daten können schnell veralten. Machen Sie es sich zur Gewohnheit, Ihren Scraper regelmäßig auszuführen, um Ihre Daten auf dem neuesten Stand zu halten.
-
Compliance und Ethik. Stellen Sie stets sicher, dass Ihre Nutzung der gescrapten Daten den gesetzlichen Vorschriften und ethischen Standards entspricht. Dazu gehört die Einhaltung von Datenschutzgesetzen und Rechten des geistigen Eigentums.
-
Erkenntnisse teilen. Erwägen Sie gegebenenfalls, Ihre Erkenntnisse mit Ihrem Team, Ihren Stakeholdern oder sogar der breiteren Community zu teilen. Dies schafft nicht nur einen Mehrwert, sondern festigt auch Ihre Fachkompetenz auf diesem Gebiet.
Indem Sie diese nächsten Schritte befolgen, können Sie die von Ihnen gescrapten Rohdaten in umsetzbare Erkenntnisse umwandeln und sie so für Ihren Geschäftserfolg nutzen.
Mit dem richtigen Ansatz und verantwortungsbewussten Vorgehensweisen kann Web-Scraping ein leistungsstarkes Werkzeug in Ihrem Arsenal für datengestützte Entscheidungsfindung sein.

