Introducción
CloudFront.net, una red de distribución de contenidos (CDN) líder, ofrece oportunidades sin igual cuando se combina con el potencial del web scraping. Esta guía profundiza en esta sinergia y ofrece consejos para maximizar la eficiencia, garantizar la precisión de los datos y gestionar el dominio de forma responsable.
CloudFront.net: un gigante de la distribución de contenidos
Amazon CloudFront, conocido a menudo por su dominio «CloudFront.net», es un servicio de red de distribución de contenidos (CDN) ofrecido por Amazon Web Services (AWS).
Una CDN es un sistema de servidores distribuidos que distribuye contenido web y aplicaciones a los usuarios en función de su ubicación geográfica. Su objetivo es proporcionar alta disponibilidad y rendimiento mediante la distribución espacial del servicio en relación con los usuarios finales.
CloudFront se integra con otros servicios de AWS para ofrecer a los desarrolladores y a las empresas una forma optimizada de distribuir contenido a los usuarios finales con baja latencia y altas velocidades de transferencia de datos.
Funciona almacenando copias de tu contenido en múltiples ubicaciones de todo el mundo, conocidas como ubicaciones periféricas. Cuando un usuario solicita contenido, CloudFront lo entrega desde la ubicación periférica más cercana, lo que garantiza el tiempo de carga más rápido posible.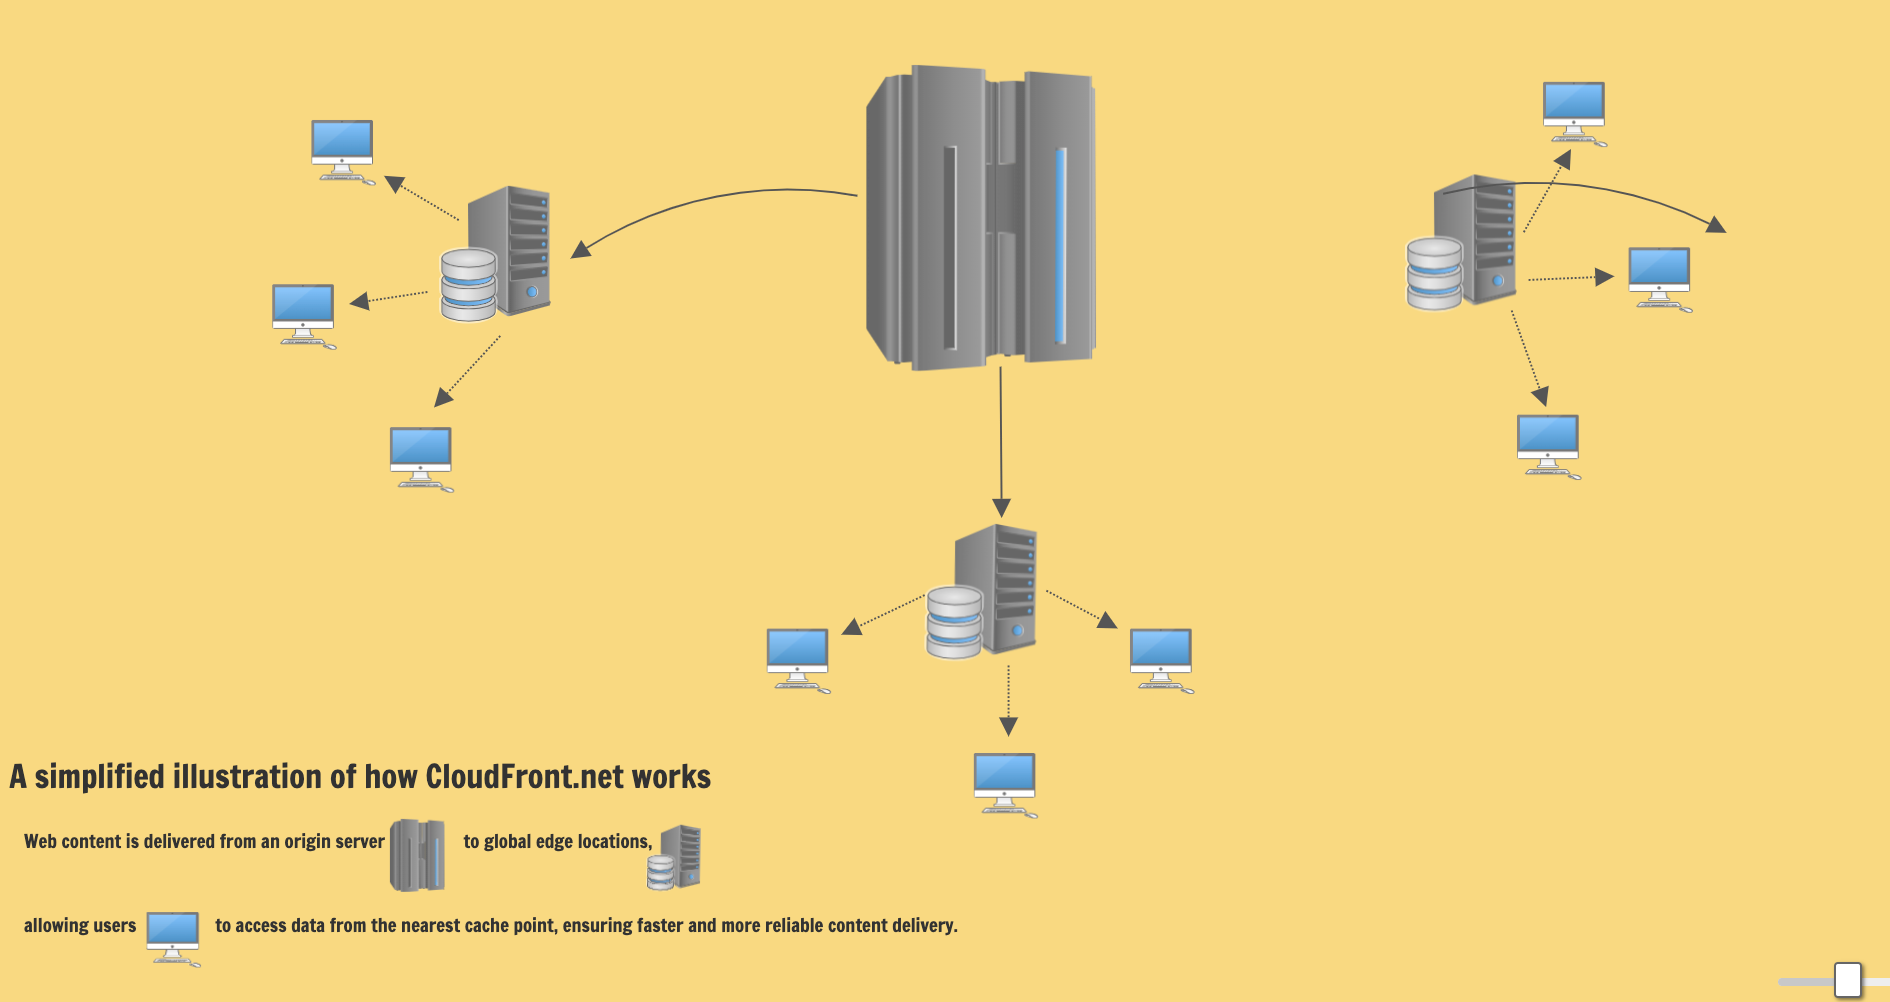
Características y ventajas clave de CloudFront
-
Alcance global. CloudFront cuenta con una amplia red de ubicaciones periféricas en todo el mundo para reducir la latencia y garantizar que el contenido se entregue desde el punto más cercano al usuario final.
-
Profunda integración con AWS. CloudFront está integrado con servicios de AWS como Amazon S3, Amazon EC2, Elastic Load Balancing y Route 53, lo que facilita el uso conjunto de estos servicios.
-
Seguridad. CloudFront ofrece múltiples capas de seguridad, incluyendo compatibilidad con HTTPS, AWS Shield para la mitigación de ataques DDoS y la integración con AWS WAF (Web Application Firewall).
Foto de Vecteezy
-
Opciones de personalización. Los desarrolladores pueden personalizar la distribución de contenidos y adaptar la CDN a los requisitos específicos de cada aplicación.
-
Rentabilidad. CloudFront utiliza un modelo de «pay-as-you-go», lo que garantiza que solo se paga por los datos que se transfieren, sin costes iniciales.
-
Distribución de contenido dinámico y estático. Aunque muchas CDN se especializan en la distribución de contenido estático, CloudFront admite tanto contenido estático como dinámico.
-
Fácil de usar para los desarrolladores. Gracias a los SDK y a una API bien documentada, los desarrolladores pueden integrar y gestionar fácilmente las distribuciones de CloudFront.
-
Métricas y registros en tiempo real. CloudFront proporciona métricas y registros detallados, lo que permite un análisis y una supervisión exhaustivos de la distribución de contenidos.
Qué es el web scraping y la extracción de datos
El web scraping es el proceso de recopilar datos de una página web.
Consiste en realizar solicitudes HTTP a páginas web, recuperar el contenido HTML y, a continuación, analizar y extraer la información deseada.
Foto de Vecteezy
A diferencia de copiar datos manualmente de un sitio web, el web scraping automatiza este proceso, lo que permite extraer grandes cantidades de datos en un tiempo relativamente corto.
El proceso suele consistir en:
- Enviar una solicitud. Un scraper envía una solicitud HTTP al sitio web de destino.
- Recibir la respuesta. El sitio web responde con contenido HTML.
- Analizar el contenido. El scraper procesa el HTML utilizando técnicas de análisis sintáctico para identificar estructuras de datos específicas.
- Extracción de datos. Una vez identificados, los datos deseados se extraen del contenido analizado.
- Almacenamiento de datos. A continuación, los datos extraídos se almacenan en un formato estructurado, a menudo en bases de datos u hojas de cálculo.
El impacto del web scraping en distintos sectores
El web scraping tiene innumerables aplicaciones en diversos sectores:
-
Comercio electrónico. Los minoristas extraen datos de las páginas web de la competencia para supervisar los precios y la oferta de productos.
-
Sector inmobiliario. Se extraen datos de las páginas web inmobiliarias para recopilar información sobre anuncios de propiedades, precios y tendencias del mercado.
-
Selección de personal. Se extraen datos de los portales de empleo para encontrar ofertas de trabajo y analizar la demanda del mercado de competencias específicas.
Foto de Vecteezy
-
Finanzas. Las instituciones financieras extraen datos de sitios web bursátiles para realizar un seguimiento de las cotizaciones bursátiles, las noticias y el sentimiento del mercado.
-
Investigación. Académicos e investigadores realizan scraping en la web para recopilar datos en diversos campos.
-
Noticias y medios de comunicación. Los agregadores realizan scraping en sitios web de noticias para seleccionar contenidos de diferentes fuentes.
-
Viajes. Las agencias de viajes realizan scraping en sitios web de aerolíneas y hoteles para comparar precios y generar ofertas.
Herramientas y técnicas de web scraping
Existen numerosas herramientas y técnicas disponibles para el web scraping, que van desde sencillas extensiones de navegador hasta software complejo.
1. ¡Navegadores sin interfaz
Foto de Vecteezy
Los navegadores sin interfaz desempeñan un papel importante en el scraping web moderno, especialmente cuando se trata de plataformas como CloudFront.net. He aquí por qué suelen ser esenciales para extraer datos de CloudFront.net:
-
Carga dinámica de contenido. Muchos sitios web, incluidos los alojados en CloudFront.net, utilizan JavaScript para cargar contenido de forma dinámica.
Las herramientas tradicionales de scraping recogen el código HTML inicial de una página, que puede no contener todos los datos si el contenido se carga de forma asíncrona mediante JavaScript.
Los navegadores sin interfaz pueden ejecutar JavaScript, lo que permite a los scrapers acceder al contenido cargado dinámicamente.
-
Simulación del comportamiento de un usuario real. Los navegadores sin interfaz pueden imitar las interacciones reales de los usuarios, como desplazarse por la página, hacer clic en botones o rellenar formularios.
Esta capacidad es crucial cuando los datos que se desean extraer dependen de alguna interacción del usuario.
-
Representación de páginas web. Es posible que parte del contenido de CloudFront.net se represente utilizando marcos web como React, Angular o Vue.js. Estos marcos suelen requerir un entorno de navegador para representar correctamente el contenido de la página.
Los navegadores sin interfaz pueden renderizar estas páginas, garantizando que el rastreador vea la página tal y como la vería un usuario humano.
-
Cookies y sesiones. Los navegadores sin interfaz pueden gestionar cookies y sesiones, lo cual puede ser necesario para acceder a determinados contenidos en CloudFront.net, especialmente si requieren autenticación de usuario o seguimiento de sesiones.
-
Depuración y desarrollo. Los navegadores sin interfaz suelen incluir herramientas de desarrollo que permiten depurar y probar los scripts de scraping.
Esta característica resulta inestimable a la hora de desarrollar y perfeccionar estrategias de scraping para sitios web complejos.
2. Python y BeautifulSoup
Python es un lenguaje de programación versátil muy utilizado para el scraping web, que te permite escribir líneas de código adaptadas a tus necesidades. Cuenta con bibliotecas sencillas pero completas, una de las cuales es BeautifulSoup.
Foto de Pexels
BeautifulSoup es una biblioteca de Python que permite recopilar información de páginas web. Crea un árbol de análisis a partir del código fuente de la página, que puede utilizarse para extraer datos de forma jerárquica y más legible.
En combinación con la biblioteca `requests` de Python para recuperar páginas web, BeautifulSoup hace que el proceso de extracción de datos web sea sencillo y eficiente.
Características principales de BeautifulSoup
- Análisis sencillo. Puede analizar tanto archivos HTML o XML bien formados como mal formados.
- Métodos de búsqueda. Proporciona métodos como `find()`, `find_all()` y `select()` para navegar y buscar en el árbol de análisis.
- Manipulación de etiquetas. Permite manipular fácilmente etiquetas y atributos.
- Codificación. Convierte automáticamente los documentos entrantes a Unicode y los salientes a la codificación UTF-8.
3. Proxies para mejorar el web scraping
Los proxies actúan como intermediarios entre un usuario e Internet. Desempeñan un papel fundamental en el web scraping por varias razones:
-
Anonimato. El scraping web puede dar lugar a bloqueos de IP si los sitios web detectan un tráfico inusual procedente de una única dirección IP.
Los proxies ocultan la IP real del scraper, lo que garantiza el anonimato y reduce el riesgo de detección y bloqueo.
-
Segmentación geográfica. Algunos sitios web muestran contenidos diferentes en función de la ubicación geográfica del usuario.
Los proxies permiten a los rastreadores acceder a contenidos de regiones específicas utilizando direcciones IP de esas zonas.
-
Limitación de frecuencia. Los sitios web suelen tener límites de frecuencia para evitar la sobrecarga. Al rotar entre varias direcciones IP de proxy, los rastreadores pueden realizar más solicitudes a un sitio web sin alcanzar los límites de velocidad.
Foto de Pexels
-
Rastreo paralelo. El uso de varios proxies permite realizar solicitudes simultáneas, lo que acelera el proceso de extracción de datos, especialmente en tareas de scraping a gran escala.
-
Menor riesgo de bloqueo. Los sitios web utilizan diversas medidas contra el scraping. Los proxies, sobre todo cuando se alternan con frecuencia, pueden ayudar a eludir estas medidas, garantizando un scraping ininterrumpido.
¿Por qué extraer datos de CloudFront.net?
A continuación se presentan algunas aplicaciones prácticas de los datos que se pueden recopilar de CloudFront.net (o de sitios web alojados a través de CloudFront):
-
Análisis de la competencia. Las empresas pueden querer conocer el contenido, la estructura o los activos del sitio web de un competidor alojado a través de CloudFront para evaluar sus estrategias online, sus ofertas o su presencia digital.
-
Agregación de contenidos. Los agregadores, como las plataformas de noticias o de comparación de precios, pueden extraer datos de sitios web alojados en CloudFront para recopilar y presentar información consolidada a sus usuarios, ofreciendo valor a través de datos exhaustivos.
-
Fines de investigación y académicos. Los investigadores o estudiantes pueden extraer datos de sitios web alojados en CloudFront para recopilarlos en proyectos académicos, estudios o trabajos, con el objetivo de analizar tendencias, patrones o fenómenos.
[Foto](https://Photo por Vlada Karpovich https) de Pexels
-
Análisis SEO. Los profesionales del SEO pueden extraer datos de sitios web alojados en CloudFront para comprender sus estrategias de SEO on-page, perfiles de backlinks o estructuras de contenido, lo que les ayuda a perfeccionar sus propias tácticas de SEO o las de sus clientes.
-
Monitorización de contenidos. Las marcas o los particulares pueden querer monitorizar sitios web específicos alojados en CloudFront en busca de menciones, reseñas o actualizaciones, lo que les permite mantenerse informados y reaccionar con rapidez ante nuevos contenidos.
-
Copias de seguridad y archivo. Algunas entidades pueden querer crear copias de seguridad de su propio contenido web distribuido a través de CloudFront, asegurándose de disponer de versiones históricas o archivos para futuras consultas.
-
Análisis de mercado. Las empresas de comercio electrónico o los analistas de mercado pueden extraer listados de productos, reseñas o datos de precios de sitios web alojados en CloudFront para comprender las tendencias del mercado, las preferencias de los consumidores o las estrategias de precios.
Es fundamental tener en cuenta que, aunque estos casos de uso presentan motivos legítimos para el scraping web, hay que asegurarse siempre de realizar un scraping ético, especialmente cuando se trata de sitios alojados a través de CDN robustas como CloudFront.
Cómo extraer datos de CloudFront.net
- Identifica la URL de destino. Determina la URL específica de CloudFront.net de la que deseas extraer datos.

- Inspecciona la página web. Utiliza las herramientas de desarrollo del navegador para inspeccionar la estructura de la página e identificar los datos que deseas extraer.

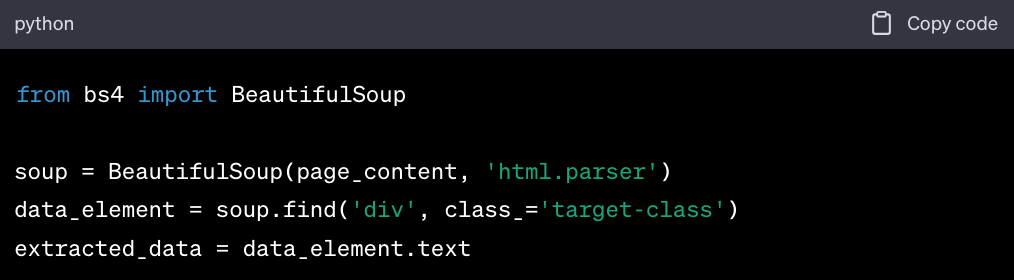
- Escribe el script de extracción. Utiliza bibliotecas de Python para escribir un script que recupere y analice la página web.
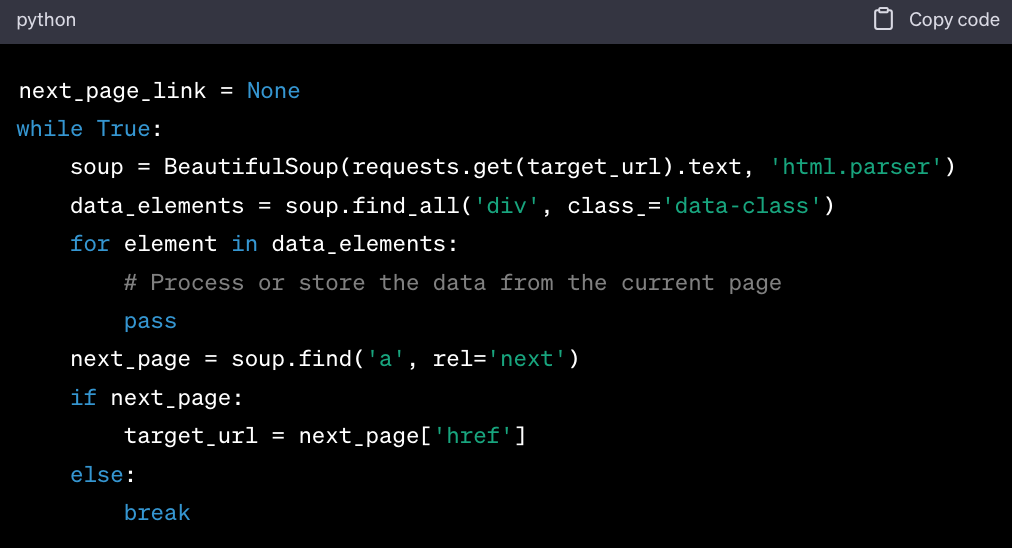
- Gestiona la paginación. Si el contenido se extiende a lo largo de varias páginas, asegúrate de que tu script pueda navegar y extraer datos de todas ellas. (Suponiendo que cada página tenga un botón «Siguiente» que enlace con la página siguiente.)
- Almacena los datos. Guarda los datos extraídos en un formato estructurado, como un archivo CSV, JSON o una base de datos.

- Respeta el archivo
robots.txt: Comprueba y respeta siempre el archivo robots.txt de CloudFront.net para asegurarte de que no infringes ninguna norma de extracción de datos. 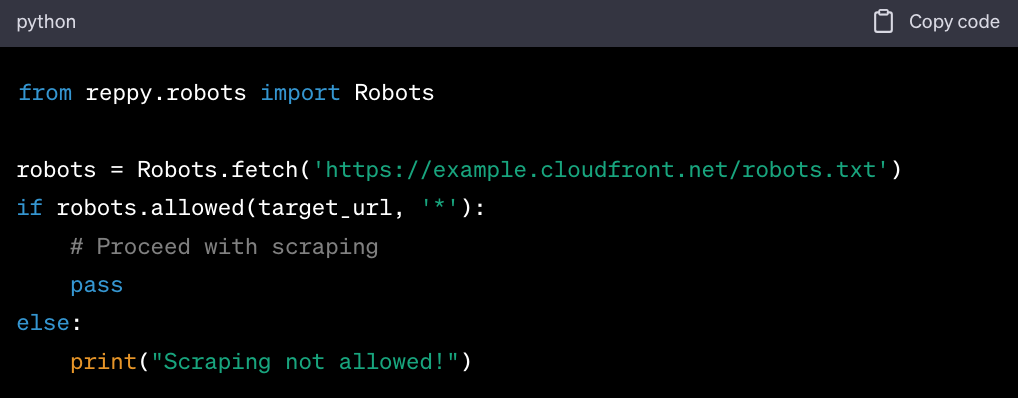
Cómo orientarse en el panorama legal del scraping en CloudFront.net
El scraping web, especialmente en plataformas como CloudFront.net, requiere un profundo conocimiento de las complejidades legales que conlleva, tales como
-
Condiciones de servicio (ToS). Antes de realizar scraping en CloudFront.net o en cualquier otro sitio web, revisa siempre sus condiciones de servicio.
Revisa siempre los Términos de servicio de AWS antes de iniciar cualquier actividad de scraping en CloudFront.net u otros servicios de AWS. Ignorar estos términos puede acarrear repercusiones legales.
-
Leyes de derechos de autor. Los datos de CloudFront.net, aunque sean de acceso público, pueden estar protegidos por derechos de autor.
Asegúrate de que los datos extraídos se utilicen de forma que no infrinjan estas leyes.
Foto de Pexels
-
Normativa sobre protección de datos. Normativas como el RGPD y la CCPA hacen hincapié en la privacidad de los usuarios.
Al extraer datos personales de CloudFront.net, asegúrate de cumplir con estas leyes, lo que incluye el almacenamiento seguro y los permisos necesarios.
-
Ley de Fraude y Abuso Informático (CFAA). Esta ley estadounidense tipifica como delito el acceso no autorizado a sistemas informáticos.
Asegúrate de que tus actividades de scraping en CloudFront.net no infrinjan sus Condiciones de Servicio para evitar conflictos con la CFAA.
Respetar los límites digitales en CloudFront.net
El scraping web ético consiste en respetar el espacio digital de plataformas como CloudFront.net:
-
Limitación de frecuencia. Evita sobrecargar CloudFront.net enviando demasiadas solicitudes en poco tiempo.
Respeta los límites de frecuencia y espacia tus actividades de scraping.
-
Información sensible. CloudFront.net puede alojar datos personales o sensibles. Da prioridad a la privacidad de los usuarios y evita el web scraping malicioso.
-
Cita la fuente. Si utilizas datos de CloudFront.net para investigación u otros fines, cita siempre a la plataforma como fuente.
-
Solicita permiso. Si tienes dudas sobre el scraping de CloudFront.net, lo mejor es solicitar permiso a los administradores de la plataforma.
Cómo sortear las medidas anti-scraping en CloudFront.net
CloudFront.net, al igual que muchas plataformas, puede contar con medidas para disuadir a los scrapers:
- Agentes de usuario. CloudFront.net podría bloquear los agentes de usuario conocidos por ser scrapers. Para evitarlo, alterna los agentes de usuario o simula el comportamiento de un navegador auténtico.
- CAPTCHAs. CloudFront.net puede utilizar CAPTCHAs para verificar que los usuarios son humanos. Aunque existen herramientas para sortearlos, los retos frecuentes pueden provocar bloqueos de IP.
- Bloqueos de IP. Si CloudFront.net detecta una actividad inusual, podría bloquear la IP. Utiliza proxies de forma responsable para rotar las direcciones IP y seguir realizando el scraping.
- Honeypots. Ten cuidado con las trampas «honeypot» en CloudFront.net: puntos de datos falsos configurados para detectar scrapers.
Optimización de las tareas de scraping en CloudFront.net con los proxies residenciales de Geonode
La integración de Geonode proxies con herramientas y scripts de scraping web puede mejorar significativamente el proceso de scraping, especialmente cuando se trata de plataformas robustas como CloudFront.net.

Geonode ha destacado como proveedor de servicios de proxy gracias a su amplia gama de características sobresalientes.
Aclamado por su red de proxies fiable, que garantiza un tiempo de inactividad mínimo y un rendimiento constante, Geonode cuenta con una amplia cobertura, respaldada por un gran número de direcciones IP repartidas por múltiples países.
Además, Geonode ofrece tiempos de respuesta rápidos gracias a su sólida infraestructura, un factor crucial para un web scraping eficiente. Proporciona conexiones seguras y satisface diversas necesidades de web scraping, garantizando la privacidad de los datos y la protección frente a posibles amenazas.
Preguntas frecuentes
¿Cómo mejora CloudFront.net la distribución de contenidos?
CloudFront.net es un servicio de red de distribución de contenidos (CDN) proporcionado por Amazon Web Services (AWS).
En términos sencillos, una CDN es como una red de mensajeros rápidos repartidos por todo el mundo, que garantiza que el contenido en línea llegue a los usuarios de forma rápida y eficiente. Así es como funciona:
-
Distribución global. CloudFront cuenta con numerosos centros de datos, conocidos como «ubicaciones periféricas», repartidos por todo el mundo.
Cuando un usuario solicita contenido, este se entrega desde la ubicación periférica más cercana, lo que garantiza un retraso o latencia mínimos.
-
Integración con AWS. Como parte del ecosistema de AWS, CloudFront se integra a la perfección con otros servicios de AWS.
Si tu sitio web o aplicación está alojada en AWS, el uso de CloudFront puede hacer que la entrega de contenidos sea aún más eficiente.
-
Contenido dinámico y estático. Mientras que algunas CDN son más adecuadas para la entrega de contenido estático (como imágenes o hojas de estilo), CloudFront es ideal para entregar tanto contenido estático como dinámico (como páginas web específicas para cada usuario).
-
Seguridad. CloudFront ofrece sólidas funciones de seguridad, entre las que se incluyen HTTPS para la transferencia segura de datos, protección contra ataques DDoS e integración con el cortafuegos de aplicaciones web de AWS.
-
Rentabilidad. Gracias a su modelo «pay-as-you-go» (paga por lo que consumes), los usuarios solo pagan por el contenido que distribuyen, lo que lo convierte en una solución rentable para empresas de todos los tamaños.
En esencia, CloudFront.net garantiza que tu contenido en línea llegue a tus usuarios de forma rápida, segura y eficiente, independientemente de dónde se encuentren en el mundo.
¿Por qué son fundamentales los proxies como Geonode para el web scraping?
El web scraping consiste en recopilar diferentes tipos de datos de sitios web. Sin embargo, este proceso no siempre es sencillo.
Los sitios web pueden contar con medidas para bloquear o limitar el acceso automatizado. Aquí es donde entran en juego los proxies, especialmente los fiables como Geonode:
-
Eludir restricciones. CloudFront.net, al formar parte de la suite de AWS, cuenta con sólidas medidas de seguridad.
Los proxies de Geonode pueden ayudar a eludir las restricciones basadas en la IP y acceder a los datos sin activar alertas.
-
Equilibrio de carga. Al extraer grandes conjuntos de datos de CloudFront.net, los proxies de Geonode pueden distribuir las solicitudes, garantizando un equilibrio de carga eficiente y una recuperación de datos más rápida.
-
Acceso a datos actualizados. CloudFront.net puede servir contenido almacenado en caché en función de la ubicación geográfica de la solicitud.
La amplia gama de direcciones IP deGeonode garantiza el acceso a datos actualizados y en tiempo real.
-
Gestión de errores. En caso de bloqueos o captchas, los scripts integrados con Geonode pueden cambiar automáticamente a otro proxy, lo que garantiza un scraping ininterrumpido.
-
Evitar los límites de frecuencia. CloudFront impone límites al número de solicitudes procedentes de una misma IP en un periodo de tiempo determinado.
Al rotar entre los proxies de Geonode, los rastreadores pueden realizar solicitudes más frecuentes sin ser bloqueados.
-
Fiabilidad. No todos los proxies son iguales. Geonode es conocido por sus proxies estables y de alta velocidad, lo que garantiza un scraping eficiente e ininterrumpido.
-
Seguridad. El uso de los proxies de Geonode garantiza una conexión segura, protegiendo al scraper de posibles amenazas y miradas indiscretas.
Para cualquiera que se tome en serio el web scraping, los proxies fiables como Geonode no solo son beneficiosos, sino que son esenciales.
¿Es legal el web scraping?
En EE. UU., la legalidad del web scraping ha sido objeto de debate y se ha abordado en diversos casos judiciales.
Uno de los casos más citados es el de hiQ Labs, Inc. contra LinkedIn Corp., en el que el Tribunal de Apelación del Noveno Circuito dictaminó que el scraping de sitios web de acceso público probablemente no infringe la CFAA.
El tribunal falló a favor de hiQ, una empresa que realizó scraping de los datos de acceso público de LinkedIn.
La decisión del tribunal se basó en la interpretación de que la CFAA se centra en las infracciones de las restricciones de acceso informático y no en el uso indebido de datos por parte de quienes tenían acceso autorizado.
Aunque el «web scraping» no es ilegal en sí mismo, es fundamental abordarlo de forma responsable.
Respeta siempre las condiciones de uso de un sitio web, ten en cuenta las leyes de derechos de autor y de protección de datos y, en caso de duda, busca asesoramiento jurídico.
Conclusión
La interacción entre CloudFront.net, el web scraping y los proxies de Geonode ofrece una visión convincente de eficiencia, innovación y adquisición responsable de datos.
Gracias a su alcance global, CloudFront.net facilita la distribución rápida de contenidos y promueve una experiencia de usuario fluida.
El web scraping, por su parte, permite obtener información valiosa que impulsa la investigación y la innovación cuando se utiliza de forma ética.
Los proxies de Geonode complementan este proceso, permitiendo la navegación web anónima, eludiendo las restricciones geográficas y garantizando un flujo constante de datos.
Pero al aprovechar las capacidades combinadas de CloudFront.net, el web scraping y los proxies de Geonode, es imprescindible dar prioridad a las prácticas éticas.
Foto de Vecteezy
Respetar los límites digitales, cumplir las directrices legales y garantizar la privacidad y los derechos de las entidades en línea debe ser una prioridad en todas nuestras iniciativas.
Comprometámonos todos con las prácticas éticas y con la búsqueda continua del conocimiento. El ámbito digital está en constante evolución y, actuando de forma responsable y manteniéndonos informados, podemos garantizar que nuestras acciones beneficien no solo a nosotros mismos, sino a toda la comunidad en línea.
.

