El web scraping y su creciente relevancia
El web scraping se ha convertido en un método cada vez más popular para recopilar datos de diversas fuentes en línea.
Ya sea para estudios de mercado, análisis de la competencia o con fines académicos, la capacidad de recopilar información de sitios web ofrece un sinfín de oportunidades.
Sin embargo, no es tan sencillo como parece. El web scraping conlleva una serie de retos, complejidades y consideraciones éticas.
Análisis de DoubleClick.net
El objetivo de este artículo es analizar el caso concreto de DoubleClick.net, una plataforma muy utilizada para la publicidad digital.
Aunque el título pueda sugerir lo contrario, es importante aclarar que este artículo no proporcionará instrucciones detalladas ni pasos a seguir sobre cómo extraer datos de DoubleClick.net.
En su lugar, analizaremos las preguntas esenciales que deberías plantearte antes incluso de plantearte tal empresa.
La importancia de plantear las preguntas adecuadas
Antes de iniciar cualquier proyecto de extracción de datos web, es fundamental plantearse las preguntas adecuadas.
Estas preguntas te ayudarán a comprender los riesgos, las implicaciones legales y los retos técnicos a los que podrías enfrentarte.
Te servirán de guía para tomar decisiones informadas, asegurándote de que no te adentras en un campo minado sin estar preparado.
Herramientas para tomar decisiones informadas: Geonode
Proxies y Scraper API
A medida que analicemos estas preguntas, también hablaremos de algunas de las herramientas que pueden ayudarte a tomar decisiones más informadas.
En concreto, veremos cómo los proxies de [Geonode
](https://geonode.com) y scraper API
pueden ser recursos valiosos en tu conjunto de herramientas de recopilación de datos.
Estas herramientas pueden ofrecerte una forma más segura y eficiente de recopilar datos, en caso de que decidas llevar a cabo un proyecto de web scraping.
Al final de este artículo, comprenderás mejor qué preguntas debes plantearte y qué herramientas debes tener en cuenta para adoptar un enfoque responsable a la hora de realizar web scraping en DoubleClick.net y, quizás, en otros sitios web populares.
¿Por qué DoubleClick.net?
¿Qué es DoubleClick.net y por qué es objeto de scraping?
También conocida como Google Marketing Platform, DoubleClick.net es una filial de Google especializada en el desarrollo y la prestación de servicios de publicación de anuncios en Internet.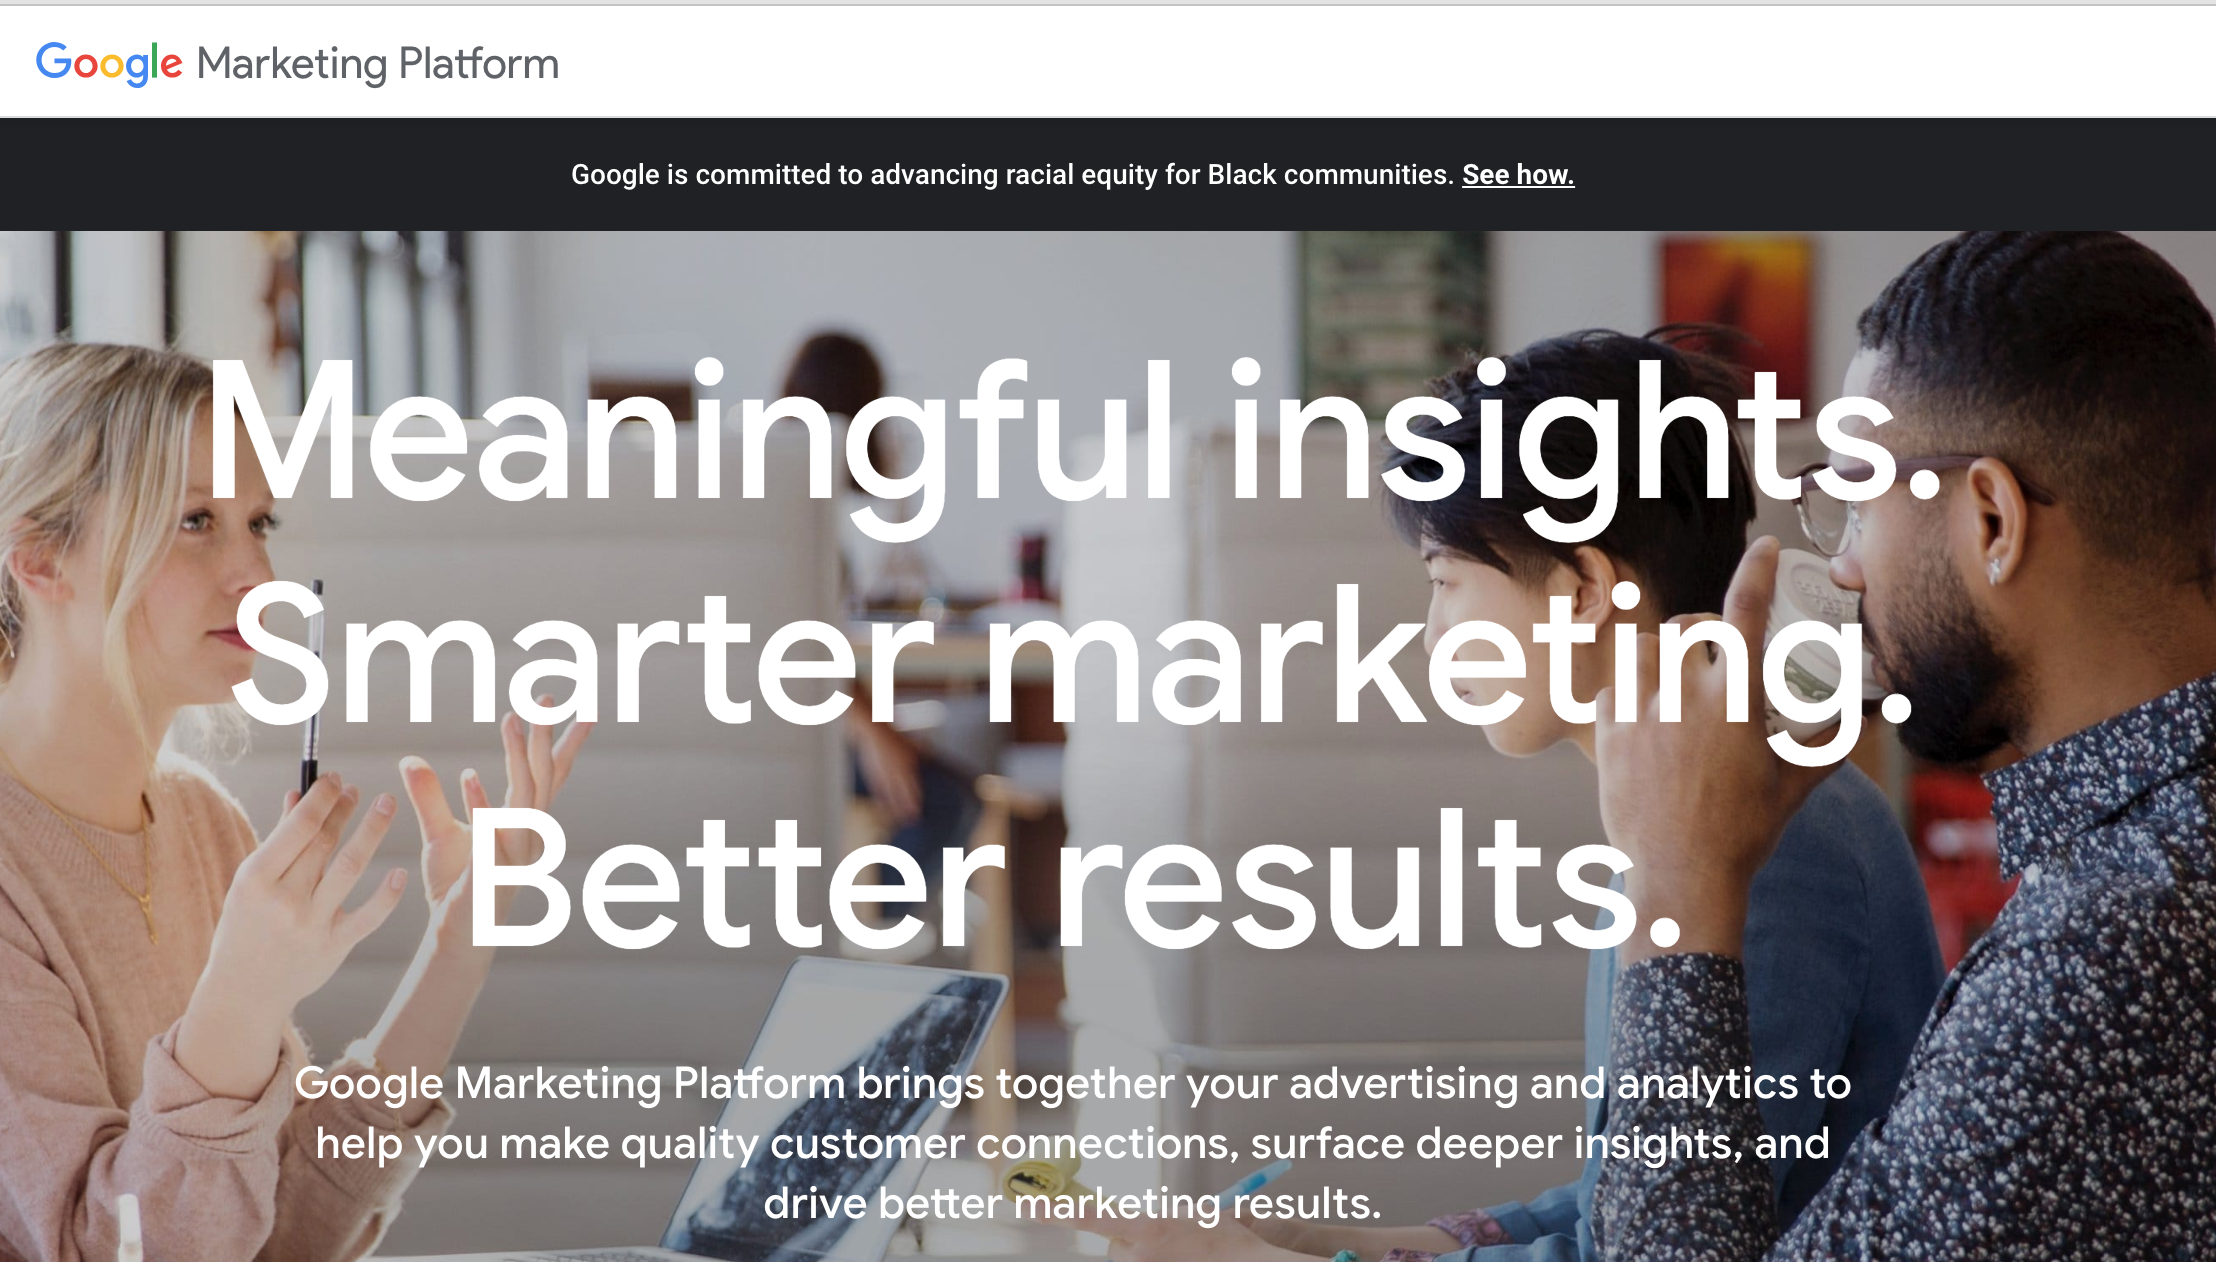
Se trata de un servicio publicitario legítimo en el que anunciantes y editores se reúnen para comprar y vender espacios publicitarios.
Dado su amplio alcance y la gran cantidad de datos que contiene, DoubleClick.net se convierte en un objetivo atractivo para el scraping web.
Entonces, ¿por qué plantearse hacer scraping en DoubleClick.net?
La plataforma contiene una gran cantidad de datos que pueden resultar muy valiosos para la investigación de mercado, el análisis de la competencia y la estrategia publicitaria.
Desde métricas de interacción de los usuarios hasta estadísticas de rendimiento publicitario, los datos disponibles pueden proporcionar información a la que no es fácil acceder en otros lugares.
Sin embargo, es fundamental abordar esto con precaución, comprendiendo las complejidades y los aspectos legales que conlleva, algo que trataremos en secciones posteriores.
El atractivo del contenido publicitario y otros datos de DoubleClick.net
En lo que respecta a los tipos de datos disponibles, DoubleClick.net es una mina de oro.
La plataforma ofrece diversas métricas y análisis que pueden resultar cruciales para las empresas y los anunciantes.
Estos pueden abarcar desde tasas de clics, impresiones y datos demográficos de los usuarios hasta datos más complejos, como el comportamiento de los usuarios y su interacción con los anuncios.
Tipos de datos de DoubleClick.net
-
Métricas de interacción de los usuarios. Comprende cómo interactúan los usuarios con los anuncios, incluyendo el tiempo dedicado a verlos, los clics y otras métricas de interacción.
-
Métricas de rendimiento de los anuncios. Obtén información sobre el rendimiento de los diferentes anuncios en términos de alcance, clics y conversiones.
-
Datos demográficos. Accede a información sobre la audiencia que interactúa con los anuncios, incluyendo edad, ubicación e intereses.
-
Datos de comportamiento. Conoce el comportamiento de los usuarios, como los tipos de anuncios en los que hacen clic, los dispositivos que utilizan y sus hábitos de navegación.
-
Métricas financieras. Obtén datos sobre el coste por clic, el coste por impresión y el ROI global de las campañas publicitarias.
El atractivo de los datos de DoubleClick.net radica en su exhaustividad y profundidad.
Estos tipos de datos pueden ofrecer una visión de 360 grados del rendimiento publicitario y la participación de los usuarios, lo que hace que resulte tentador para los analistas de datos y los profesionales del marketing plantearse extraer información de la plataforma.
Sin embargo, como veremos en las siguientes secciones, extraer datos de DoubleClick.net no es sencillo y conlleva una serie de retos y consideraciones éticas.
Consideraciones legales
¿Es legal realizar scraping en DoubleClick.net?
La cuestión de la legalidad es una de las primeras que deberían plantearse al considerar la posibilidad de realizar scraping en cualquier sitio web, y DoubleClick.net no es una excepción.
Entonces, ¿cuáles son las implicaciones legales de extraer datos de DoubleClick.net?
En primer lugar, es fundamental comprender que la extracción de datos web, en general, se encuentra en una zona gris en el panorama legal.
Las leyes relativas al scraping varían según la jurisdicción y, a menudo, están sujetas a interpretación.
Sin embargo, DoubleClick.net, al ser una filial de Google, cuenta con unas condiciones de uso que prohíben explícitamente el scraping de su contenido sin permiso.
Incumplir estas condiciones, ya sea mediante un método explotable o una infiltración encubierta, puede dar lugar a acciones legales, entre las que se incluye, entre otras, la prohibición de utilizar sus servicios.
Por lo tanto, antes de llevar a cabo cualquier actividad de scraping, es recomendable consultar con profesionales del ámbito jurídico para comprender las leyes y normativas específicas que puedan aplicarse a tu caso.
Además, lee y comprende siempre las condiciones de uso de los sitios web —ya sean sitios publicitarios, redes sociales, sitios financieros, etc.— de los que estés pensando en extraer datos.
Consecuencias del scraping ilegal
Si procedes a realizar scraping en DoubleClick.net sin cumplir las directrices legales, te expones a diversos riesgos.
Puedes meterte en problemas y salir de tu apuro requeriría algo más que simplemente restablecer el navegador o pulsar el botón de reinicio
Estos son algunos de los riesgos de extraer datos de DoubleClick.net:
-
Suspensión de la cuenta. DoubleClick.net puede detectar aplicaciones maliciosas capaces de automatizar actividades de extracción de datos, y una de las medidas inmediatas que puede tomar es suspender o bloquear tu cuenta, impidiéndote el acceso a sus servicios.
-
Acciones legales. Como se ha mencionado anteriormente, extraer datos de DoubleClick.net sin permiso infringe sus condiciones de servicio, y podrían emprender acciones legales contra ti.
Esto podría acarrear multas cuantiosas y, en casos extremos, cargos penales.
-
Daño a la reputación. Ser descubierto realizando scraping de forma ilegal puede dañar gravemente tu reputación, afectando tanto a tu vida personal como a la profesional.
-
Inexactitud de los datos. Aunque consigas extraer algunos datos, no hay garantía de que sean exactos o completos, ya que DoubleClick.net puede implementar medidas contra el scraping que proporcionen datos incorrectos a aplicaciones y programas de scraping sospechosos.
-
Agotamiento de recursos. Las actividades de scraping pueden consumir una cantidad significativa de recursos informáticos y tiempo, especialmente si te descubren y tienes que hacer frente a consecuencias legales.
-
Cuestiones éticas. Más allá de las ramificaciones legales, el scraping sin permiso plantea cuestiones éticas que pueden afectar a tu reputación en tu comunidad profesional.
Comprender estos riesgos es fundamental para cualquiera que esté considerando realizar scraping en DoubleClick.net.
No se trata solo de la capacidad técnica para extraer datos, sino también de comprender el marco legal y las posibles consecuencias de salirse de él.
Por lo tanto, es esencial sopesar estos riesgos con cuidado y consultar con profesionales del ámbito jurídico antes de emprender cualquier actividad de scraping.
Cuestiones éticas
La ética del scraping web
Si bien los aspectos legales del scraping web son innegablemente importantes, las consideraciones éticas son igualmente cruciales.
Entonces, ¿cuáles son las consideraciones éticas a tener en cuenta al extraer datos de DoubleClick.net?
-
Privacidad de los datos. DoubleClick.net recopila datos de los usuarios que interactúan con la plataforma.
Extraer estos datos sin consentimiento podría considerarse una invasión de la privacidad.
-
Uso legítimo. Sitios web como DoubleClick.net invierten recursos en recopilar y presentar datos.
Extraer estos datos de forma masiva podría considerarse un uso indebido de dichos recursos.
-
Transparencia. Si extraes datos con fines de investigación o académicos, se considera ético ser transparente sobre tus métodos e intenciones.
-
Integridad. Manipular o utilizar datos extraídos de forma que se tergiversen los hechos se considera altamente poco ético.
-
Uso comercial. Utilizar datos extraídos con fines lucrativos sin el permiso de DoubleClick.net podría considerarse tanto ilegal como poco ético.
-
Acuerdo de usuario. Ignorar o infringir intencionadamente las condiciones de uso de un sitio web se considera, por lo general, poco ético.
Es fundamental comprender el panorama ético antes de iniciar cualquier proyecto de extracción de datos web. No se trata solo de si se puede extraer, sino de si se debe hacer.
Casos prácticos sobre la extracción ética de datos
Para ilustrar mejor las dimensiones éticas de la extracción de datos web, veamos algunos ejemplos de prácticas éticas de extracción de datos web.
-
Investigación académica. Los investigadores suelen extraer datos con fines académicos y, por lo general, lo hacen siguiendo estrictas directrices éticas, como solicitar permiso al sitio web y garantizar el anonimato de los datos.
-
Datos públicos. Algunos sitios web ofrecen datos que son públicos por naturaleza, como las estadísticas gubernamentales.
Extraer estos datos mediante procesos manuales se considera generalmente ético si se utiliza en beneficio público y no para obtener beneficios personales.
-
Transparencia. Empresas como Geonode ofrecen servicios de «scraper API» diseñados para respetar los términos de uso de los sitios web y los archivos robots.txt, cumpliendo así con las normas éticas.
-
Opiniones de usuarios. Los sitios web que recopilan opiniones de usuarios suelen extraer datos de múltiples fuentes, pero lo hacen de forma transparente y ofrecen un servicio que beneficia al público.
-
Periodismo. Los periodistas de investigación recurren en ocasiones al web scraping para recopilar datos para reportajes que sirven al interés público.
Sin embargo, suelen seguir estrictas directrices éticas, que incluyen la verificación de los datos y la transparencia sobre sus métodos.
Al examinar estos casos prácticos, podemos obtener información sobre cómo se puede llevar a cabo el web scraping de forma ética.
La conclusión clave es que el web scraping ético no se limita al mero acto de recopilar datos, sino que también tiene que ver con cómo se utilizan esos datos y con qué finalidad.
En resumen, las consideraciones éticas deben ocupar un lugar destacado en cualquier debate sobre el «web scraping», y más aún cuando se trata de una plataforma tan importante como DoubleClick.net.
Hay que sopesar siempre las implicaciones éticas junto con los retos legales y técnicos.
Retos técnicos
¿A qué retos técnicos te enfrentarás?
A la hora de plantearse extraer datos de DoubleClick.net, es fundamental ser consciente de los obstáculos técnicos que ello conlleva. Entonces, ¿cuáles son las dificultades técnicas a la hora de extraer datos de DoubleClick.net?
-
Medidas contra el scraping. DoubleClick.net emplea diversas técnicas y software adicionales contra el scraping, como CAPTCHAs, limitación de la frecuencia de IP y comprobaciones de la cadena de agente de usuario, lo que dificulta el scraping eficaz del sitio.
-
Contenido dinámico. La plataforma suele utilizar JavaScript para cargar contenido de forma dinámica, lo que requiere técnicas de scraping más avanzadas que el simple análisis sintáctico de HTML.
-
Complejidad de los datos. DoubleClick.net ofrece una amplia gama de tipos y estructuras de datos, lo que puede dificultar su exploración y extracción de forma significativa. 
-
Limitación de frecuencia. Incluso si consigues eludir las medidas iniciales contra el scraping, es posible que te encuentres con límites de frecuencia que restrinjan la cantidad de datos que puedes recopilar en un intervalo de tiempo determinado.
-
Carga del servidor. Las actividades de scraping mal ejecutadas pueden sobrecargar los servidores de DoubleClick.net, lo que afecta al rendimiento del sitio web y puede provocar que se bloquee tu dirección IP.
-
Integridad de los datos. Tal y como se menciona en la sección legal, algunos sitios web proporcionan datos incorrectos o engañosos a los presuntos «scrapers», lo que hace que los datos extraídos no sean fiables.
Comprender estos retos técnicos es fundamental para cualquiera que se plantee realizar scraping en DoubleClick.net.
No se trata solo de instalar programas o enviar solicitudes a los navegadores de Internet y recopilar datos; necesitarás una estrategia bien planificada para superar estos retos de forma eficaz.
Importancia del uso de proxies y API
Dadas las complejidades técnicas que entraña el scraping de DoubleClick.net, el uso de herramientas especializadas como proxies y API no solo resulta beneficioso, sino que a menudo es necesario. En este contexto, los proxies de Geonode y scraper API ofrecen soluciones valiosas.
-
Geonode Proxies. Estos proxies te permiten redirigir tus solicitudes de scraping a través de diferentes direcciones IP, lo que reduce el riesgo de ser detectado y bloqueado por DoubleClick.net.
También ofrecen proxies residenciales, que tienen menos probabilidades de ser marcados por actividades de scraping.
-
Scraper API de Geonode. Esta API gestiona muchos de los retos asociados al scraping web, como los CAPTCHA y los reintentos, lo que hace que el proceso sea más eficiente.
Además, respeta el archivo robots.txt del sitio web, lo que se ajusta a las prácticas éticas de scraping.
-
Equilibrio de carga. Geonode ofrece funciones de equilibrio de carga, lo que garantiza que no se sobrecarguen los servidores de DoubleClick.net, minimizando así el riesgo de ser bloqueado.
-
Precisión de los datos. El uso de una API fiable como scraper API de Geonode puede aumentar la probabilidad de obtener datos precisos y fiables, ya que está diseñada para sortear eficazmente las medidas anti-scraping.
-
Cumplimiento legal y ético: los servicios de Geonode están diseñados para respetar los términos de uso de los sitios web y los archivos robots.txt, lo que los convierte en una opción más ética para las actividades de web scraping.
Al utilizar herramientas como los proxies de Geonode y scraper API, puedes mitigar muchos de los retos técnicos asociados al scraping de DoubleClick.net.
Estas herramientas ofrecen una forma más segura, eficiente y ética de recopilar datos, en caso de que decidas llevar a cabo un proyecto de scraping web.
Preguntas que debes plantearte
Antes de embarcarte en cualquier proyecto de web scraping, especialmente uno tan complejo y lleno de retos como DoubleClick.net, es fundamental que te plantees algunas preguntas básicas.
Estas preguntas te guiarán a la hora de tomar decisiones informadas y te ayudarán a comprender si el scraping es el enfoque adecuado para tus necesidades.
¿Cuál es tu objetivo final?
La primera pregunta que debes plantearte es sencilla, pero a menudo se pasa por alto: ¿Cuál es tu objetivo final? O, dicho de otro modo, ¿cuáles son tus objetivos al extraer datos de DoubleClick.net?
- Estudio de mercado: ¿Buscas recopilar datos para un análisis de mercado?
- Análisis de la competencia: ¿Quieres comprender cómo se anuncian tus competidores?
- Investigación académica: ¿Se trata de un proyecto académico que requiere datos exhaustivos?
- Uso personal: ¿Buscas recopilar datos para tu propio análisis o aprendizaje?
Comprender tu objetivo final no solo te guiará en tu estrategia de scraping, sino que también te ayudará a evaluar si merece la pena asumir los riesgos y retos que conlleva.
¿Dispones de los recursos necesarios?
El web scraping, especialmente desde una plataforma compleja como DoubleClick.net, requiere diversos recursos, tanto humanos como técnicos.
-
Conocimientos técnicos. ¿Tienes tú o tu equipo los conocimientos técnicos necesarios para hacer frente a los retos que plantea el scraping de DoubleClick.net?
-
Hardware y software. ¿Dispones de los recursos informáticos necesarios para llevar a cabo el scraping?
-
Tiempo. El scraping web puede llevar mucho tiempo, especialmente si te encuentras con problemas que requieran una resolución de incidencias.
-
Recursos económicos. Algunas herramientas y servicios pueden facilitar el scraping web, pero tienen un coste.
En este contexto, los proxies de Geonode y scraper API pueden ser recursos inestimables. Pueden ayudarte a superar muchos de los retos técnicos asociados al scraping de DoubleClick.net, haciendo que el proceso sea más eficiente y seguro.
¿Cuáles son las alternativas?
Antes de lanzarte a un proyecto de extracción de datos web, es aconsejable considerar otras vías para obtener la información que necesitas. Entonces, ¿cuáles son las alternativas a la extracción de datos de DoubleClick.net?
-
Datos de acceso público. Es posible que parte de la información que buscas ya esté disponible en conjuntos de datos o informes públicos, pero estos pueden estar plagados de programas sospechosos, como software no deseado y secuestradores de navegador.
-
API. Algunas plataformas ofrecen API que proporcionan datos de una forma más estructurada y ética.
-
Recopilación manual de datos. Dependiendo de tus necesidades, la recopilación manual de datos podría ser viable, aunque por lo general requiere más tiempo que otras opciones y resulta mucho más difícil que utilizar el cuadro de búsqueda o tu motor de búsqueda favorito.
-
Servicios de terceros. Algunas empresas se especializan en la recopilación de datos y es posible que ya dispongan de los datos que necesitas.
-
Colaboraciones. Establecer una colaboración con DoubleClick.net o plataformas similares podría ser una forma de acceder a los datos de manera legal y ética.
Al considerar estas alternativas, podrás tomar una decisión más informada sobre si el web scraping es el método más eficaz y adecuado para alcanzar tus objetivos.
En resumen, antes de proceder con el scraping de DoubleClick.net, es fundamental que te plantees estas preguntas para evaluar la viabilidad, los riesgos y las implicaciones de tu proyecto.
Preguntas frecuentes
¿Es ilegal extraer datos de DoubleClick.net?
La legalidad de la extracción de datos de DoubleClick.net es una cuestión compleja y varía en función de la jurisdicción y de las acciones concretas que se lleven a cabo.
Las condiciones de uso de DoubleClick.net prohíben explícitamente el scraping sin permiso. El incumplimiento de estas condiciones puede acarrear consecuencias legales, como la suspensión de la cuenta y posibles acciones legales.
Por lo tanto, es fundamental consultar con profesionales del ámbito jurídico para comprender las leyes y normativas específicas que puedan aplicarse a tu caso.
¿Cómo puedo extraer datos de una página web sin que me descubran?
Aunque no podemos respaldar la extracción de datos de una página web en contra de sus condiciones de servicio, existen prácticas generales que pueden minimizar el riesgo de detección.
Entre ellas se incluyen limitar la frecuencia de las solicitudes, rotar las direcciones IP y respetar el archivo robots.txt de la página web.
Herramientas especializadas como los proxies de Geonode y scraper API están diseñadas para sortear muchos de los retos asociados al scraping web, lo que hace que el proceso sea más eficiente y menos propenso a ser detectado.
Sin embargo, es esencial comprender que estas prácticas no hacen que el scraping sea legal si va en contra de las condiciones de uso del sitio web.
¿Cuáles son las mejores herramientas para el web scraping?
Existen varias herramientas que pueden facilitar el web scraping, cada una con su propio conjunto de características y capacidades.
Sin embargo, a la hora de extraer datos de una plataforma compleja como DoubleClick.net, se recomiendan encarecidamente herramientas especializadas como los proxies de Geonode y scraper API.
-
Proxies deGeonode. Estos proxies te permiten redirigir tus solicitudes a través de diversas direcciones IP, lo que reduce el riesgo de detección.
Geonode ofrece proxies residenciales, que tienen menos probabilidades de ser detectados por las medidas anti-scraping.
-
Scraper API de Geonode: Esta API está diseñada para gestionar muchos de los retos asociados al web scraping, como los CAPTCHA y los reintentos.
Además, respeta el archivo robots.txt del sitio web, lo que la convierte en una opción más ética para las actividades de web scraping.
Al utilizar estas herramientas, podrás sortear muchos de los retos técnicos asociados al scraping web, lo que hará que tus esfuerzos de recopilación de datos sean más eficientes y seguros.
En resumen, las preguntas de esta sección reflejan las preocupaciones habituales que tiene la gente sobre el scraping de DoubleClick.net.
Aunque existen herramientas y métodos para mitigar los riesgos y retos, es fundamental abordar la tarea con un conocimiento profundo de las implicaciones legales y éticas.
Conclusión
En este artículo, hemos analizado las múltiples consideraciones que implica el scraping de DoubleClick.net.
Desde comprender el panorama legal hasta afrontar los retos técnicos y los dilemas éticos, queda claro que el web scraping no es una tarea sencilla.
La conclusión clave es la importancia de plantearse las preguntas adecuadas antes de lanzarse a cualquier proyecto de scraping.
Conocer el objetivo final, evaluar los recursos disponibles y considerar alternativas son pasos cruciales para tomar una decisión informada.
Herramientas especializadas como Geonode proxies y scraper API pueden ser de gran ayuda a la hora de abordar las complejidades técnicas y las consideraciones éticas del scraping web.
Llamada a la acción
Antes de intentar extraer datos de DoubleClick.net o de cualquier otra plataforma, te recomendamos que reflexiones de forma crítica sobre las implicaciones que ello conlleva.
Sopesa los riesgos frente a los beneficios y consulta con profesionales del ámbito jurídico para asegurarte de que actúas con total seguridad.
Si decides que el scraping web es el enfoque adecuado para tus necesidades, plantéate darte de alta en los servicios de Geonode para disfrutar de un proceso de recopilación de datos más seguro y ético.
Al seguir estas directrices, no solo tomarás decisiones más informadas, sino que también contribuirás a unas prácticas de scraping web más responsables y éticas.

