LIHKG es un popular foro de debate en línea que ha ganado un gran impulso en Hong Kong y entre las comunidades de habla cantonesa de todo el mundo.
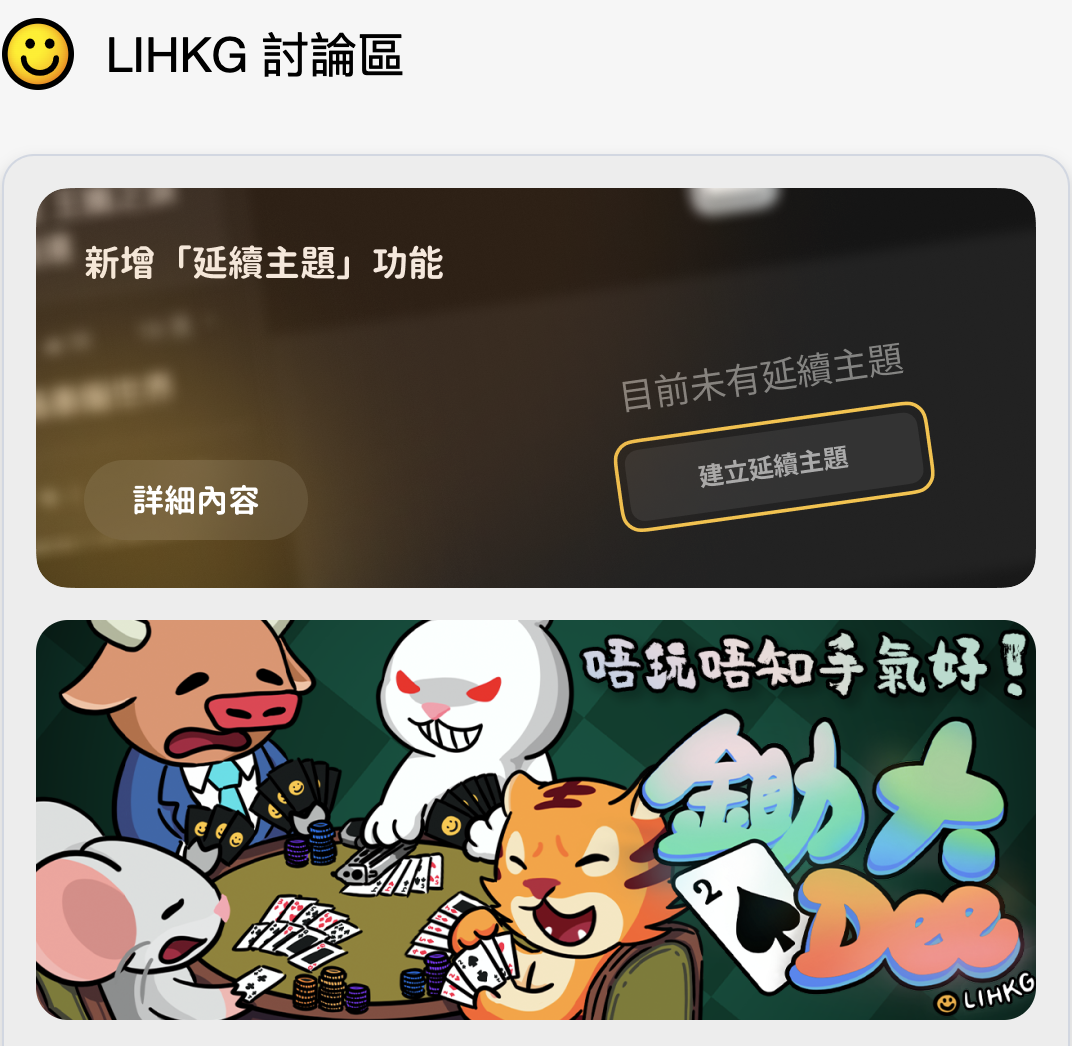
Es uno de los foros más importantes para debatir sobre protestas, disturbios sociales y otros temas.
A menudo comparada con Reddit en los análisis de la competencia, esta plataforma de redes sociales permite a los usuarios del foro debatir sobre una amplia variedad de temas, desde política y actualidad hasta entretenimiento y estilo de vida.
La historia del foro revela un marcado interés por la acción colectiva y las protestas a gran escala.
Con su contenido generado por los usuarios y sus debates en línea en tiempo real, lihkg.com constituye un valioso recurso para investigadores, profesionales del marketing y analistas de datos interesados en comprender la opinión pública, las redes sociales y las tendencias sociales.
Las complejidades del scraping en lihkg.com
Aunque la idea de realizar scraping en lihkg.com pueda parecer sencilla, la realidad dista mucho de ello.
La página web emplea diversos mecanismos para proteger su conjunto de datos, muy bien estructurado, que van desde los CAPTCHA hasta las solicitudes AJAX, lo que la convierte en un objetivo difícil para el scraping web y las redes de detección de disturbios.
Además, las consideraciones éticas y legales, incluida la ética de la solidaridad, añaden otra capa de complejidad al proceso.
Comprender estas complejidades es fundamental para cualquiera que se plantee extraer datos de esta u otras plataformas en línea similares.
No se trata solo de recopilar datos de las redes sociales, sino de hacerlo de forma responsable y eficaz.
Herramientas hipotéticas: Geonode
Proxies y Scraper API
En un escenario hipotético en el que se quisiera extraer datos de lihkg.com, ciertas herramientas podrían facilitar el proceso.
Los proxies de [Geonode
](https://geonode.com) podrían utilizarse para eludir las restricciones basadas en la IP, lo que permitiría una recopilación de datos más amplia sin activar las medidas contra el scraping. Esto resulta especialmente útil para gestionar cascadas de actividad.
Además, [scraper API
de Geonode
](https://geonode.com/the-pay-as-you-go-scraper) podría automatizar y simplificar el proceso de scraping, gestionando de forma más eficiente retos como los CAPTCHA y las solicitudes AJAX.
Esto resultaría beneficioso en tiempo real, especialmente cuando se trata de un alto grado de solidaridad entre los usuarios del foro.
¿A quién va dirigido este artículo?
Si alguna vez te has preguntado cómo extraer datos de lihkg.com, este ejercicio de reflexión es para ti.
Este artículo pretende arrojar luz sobre las complejidades y los retos a los que te enfrentarías al extraer datos de lihkg.com, sin llegar a enseñarte cómo hacerlo.
Así pues, profundicemos en este fascinante tema y exploremos qué lo hace tan desafiante y, a la vez, tan intrigante.
Las complejidades de lihkg.com
La estructura de lihkg.com
lihkg.com está desarrollado principalmente mediante una combinación de HTML, CSS y JavaScript.
Mientras que el HTML y el CSS se encargan del diseño y el estilo, JavaScript es responsable de los aspectos dinámicos del sitio, como las actualizaciones en tiempo real y las solicitudes AJAX.
Por qué la estructura es importante para el scraping
Comprender la estructura es el primer paso para averiguar cómo extraer datos de lihkg.com.
Por ejemplo, si el sitio web depende en gran medida de JavaScript para cargar contenido, es posible que los métodos tradicionales de scraping, que solo recogen el código HTML, no funcionen.
Sería necesario utilizar técnicas más avanzadas, como los navegadores sin interfaz gráfica, para ejecutar el código JavaScript y recuperar los datos.
Retos a la hora de extraer contenido dinámico
lihkg.com utiliza AJAX (JavaScript asíncrono y XML) para cargar nuevos datos sin actualizar toda la página.
Esto dificulta el rastreo del sitio mediante solicitudes HTTP básicas.
En un escenario hipotético, se podría utilizar scraper API de Geonode para gestionar dicho contenido dinámico de forma más eficiente.
Tipos de datos en lihkg.com
¿Qué puedes encontrar?
lihkg.com ofrece una variedad de tipos de contenido que pueden resultar de interés para diferentes usuarios. A continuación se enumeran algunos de los principales tipos de datos que podrías considerar extraer:
-
Publicaciones de los usuarios. Son publicaciones originales realizadas por los usuarios sobre diversos temas; sirven como punto de partida para los debates y pueden contener texto, imágenes y enlaces.
-
Comentarios: son las respuestas a las publicaciones de los usuarios y pueden tener réplicas anidadas, formando una estructura similar a un hilo de discusión.
-
Votos positivos y negativos. Cada publicación y comentario puede recibir votos positivos o negativos, lo que ofrece una indicación de la opinión de la comunidad respecto al contenido.
-
Perfiles de usuario. Pueden contener información como la fecha de registro del usuario, su nivel de actividad y otras estadísticas, aunque gran parte de estos datos suelen estar anonimizados o se les ha asignado un seudónimo.
Por qué son importantes estos datos
Investigación de mercado
Comprender de qué hablan los usuarios puede proporcionar información valiosa sobre el comportamiento y las tendencias de los consumidores. Esto resulta especialmente útil para el análisis de la competencia y el análisis de visualización.
Análisis de opiniones
Los votos positivos y negativos pueden utilizarse para evaluar la opinión pública sobre temas o acontecimientos específicos, incluidas las campañas de protesta y los episodios de malestar social.
Investigación académica
Los investigadores que estudian las comunidades en línea pueden considerar que las interacciones y los debates de los usuarios en lihkg.com constituyen una rica fuente de datos para sus conjuntos de datos bien estructurados.
Retos del scraping
Realizar scraping en una página web como lihkg.com no es solo una tarea técnica, sino también un laberinto legal y ético.
El panorama legal
El scraping web se mueve en una zona algo gris de la ley.
Aunque el scraping de publicaciones de acceso público se considera generalmente legal, muchos sitios web cuentan con condiciones de uso que prohíben esta práctica.
Incumplir estas condiciones puede acarrear consecuencias legales, como demandas y multas.
Cómo se aplica a lihkg.com
lihkg.com cuenta con sus propias condiciones de uso, que los usuarios deben aceptar al utilizar la página.
Estos términos suelen incluir cláusulas que prohíben el scraping no autorizado del contenido del sitio web.
Por lo tanto, realizar scraping en lihkg.com sin permiso explícito podría acarrear repercusiones legales.
Implicaciones éticas
Más allá de los aspectos legales, el scraping en lihkg.com también plantea cuestiones éticas.
La plataforma es una comunidad en la que las personas comparten sus pensamientos y opiniones, y a menudo esperan un cierto nivel de privacidad.
Extraer estos datos sin consentimiento podría considerarse una invasión de la privacidad, incluso si los datos son de acceso público.
Barreras técnicas
CAPTCHAs
Una de las medidas anti-scraping más comunes empleadas por los sitios web es el CAPTCHA (Prueba de Turing pública y completamente automatizada para distinguir entre ordenadores y humanos).
lihkg.com utiliza CAPTCHAs para garantizar que el usuario que interactúa con el sitio web es humano y no un bot. Esto supone un obstáculo importante para cualquier intento de scraping.
Solicitudes AJAX
Como se ha mencionado anteriormente, lihkg.com utiliza AJAX (JavaScript asíncrono y XML) para cargar contenido de forma dinámica.
Esto significa que los datos que se ven en el sitio web no están presentes en el código HTML inicial, sino que se cargan de forma asíncrona a través de JavaScript.
Los métodos tradicionales de scraping que solo recogen el código HTML no podrán capturar estos datos cargados dinámicamente.
Restricciones basadas en la IP
Los sitios web suelen emplear restricciones basadas en la IP para bloquear o limitar el acceso desde ubicaciones geográficas específicas o para impedir actividades de scraping.
Varias solicitudes desde la misma dirección IP en un breve periodo de tiempo pueden activar estas restricciones.
Herramientas hipotéticas para el trabajo
Los proxies de Geonode como solución hipotética
En un escenario hipotético en el que se intentara extraer datos de lihkg.com, los proxies de Geonode podrían servir como solución para sortear las restricciones basadas en la IP.
Al enrutar tus solicitudes a través de varias direcciones IP, podrías evitar activar las medidas anti-scraping, lo que permitiría una recopilación de datos más exhaustiva.
El papel de los proxies
En el scraping web, un proxy actúa como intermediario entre tu ordenador y el sitio web del que intentas extraer datos.
Este reenvía tus solicitudes al sitio web y te devuelve las respuestas del mismo, ocultando de forma efectiva tu dirección IP en el proceso.
Proxies de Geonode para restricciones geográficas
Geonode ofrece una gama de proxies residenciales que pueden utilizarse para eludir las restricciones geográficas.
Por ejemplo, si lihkg.com restringiera el acceso a usuarios de determinados países, los proxies de Geonode podrían redirigir tus solicitudes a través de direcciones IP ubicadas en regiones que no estén restringidas, lo que te permitiría acceder al sitio web.
Superar los límites de frecuencia con los proxies de Geonode
La limitación de frecuencia es otra medida habitual contra el scraping que restringe el número de solicitudes que una misma dirección IP puede realizar en un intervalo de tiempo determinado.
Los proxies de Geonode podrían ayudarte a superar esto distribuyendo tus solicitudes entre varias direcciones IP, lo que reduce la probabilidad de que alcances los límites de frecuencia.
El «Scraper API»
Un «scraper API» es una herramienta que simplifica el proceso de web scraping al gestionar muchos de los retos asociados al mismo, como los CAPTCHA, las solicitudes AJAX y los límites de frecuencia.
Básicamente, actúa como un intermediario que se encarga de los detalles más minuciosos, lo que te permite centrarte en lo que vas a hacer con los datos una vez extraídos.
Cómo podría simplificar el proceso el servicio «Scraper API» de Geonode
El servicio «scraper API» de Geonode está diseñado para gestionar muchos de los retos a los que te enfrentarías al extraer datos de una web compleja como lihkg.com. Es capaz de gestionar reintentos en caso de fallos, lo que hace que todo el proceso sea más eficiente y menos propenso a errores.
Reconsiderar el enfoque
scraper API, de Geonode, te hace replantearte cómo extraer datos de lihkg.com.
En lugar de dedicar innumerables horas a averiguar cómo sortear los CAPTCHA o gestionar las solicitudes AJAX, podrías aprovechar la API para hacer frente a estos retos, lo que te permitiría centrarte en analizar los datos y extraer información útil de ellos.
Preguntas frecuentes
¿Qué es lihkg.com?
lihkg.com es un foro muy popular en Hong Kong y entre los hablantes de cantonés de todo el mundo, que abarca temas que van desde la política hasta la cultura pop.
A menudo comparado con Reddit, es una fuente clave para seguir la opinión pública y las tendencias, incluyendo temas de actualidad y noticias alternativas.
¿Es legal extraer datos de sitios web?
La legalidad de la extracción de datos web varía en función de la jurisdicción y las circunstancias específicas.
En general, el scraping de información de acceso público se considera legal. Sin embargo, muchos sitios web, incluido lihkg.com, cuentan con condiciones de uso que prohíben el scraping no autorizado.
El incumplimiento de estas condiciones puede acarrear consecuencias legales.
¿Cómo funcionan los proxies en el scraping web?
En el web scraping, un proxy actúa como intermediario entre tu ordenador y el sitio web de destino. Reenvía tus solicitudes al sitio web y te devuelve las respuestas de este.
Este proceso oculta eficazmente tu dirección IP, lo que dificulta que los sitios web te identifiquen y te bloqueen.
¿Qué es un «Scraper API»?
Un «scraper API» es un servicio que simplifica el proceso de scraping web al ocuparse de muchos de los retos asociados al mismo.
La herramienta scraper API de Geonode podría, en teoría, gestionar estos aspectos por ti, permitiéndote centrarte en los datos y en cómo pretendes utilizarlos.
Conclusión
Al llegar al final de este experimento mental, queda claro que extraer datos de lihkg.com —o de cualquier sitio web, para el caso— no es una tarea sencilla.
El proceso está plagado de complejidades que van desde comprender la estructura del sitio web hasta sortear laberintos legales y éticos.
Extraer datos de lihkg.com plantea una serie de retos únicos:
-
Barreras técnicas. El uso que hace el sitio web de AJAX para la carga dinámica de contenidos y de CAPTCHAs para disuadir a los bots hace que la extracción de datos sea más complicada que la simple obtención de contenido HTML.
-
Cuestiones legales y éticas. Las condiciones de uso de lihkg.com prohíben explícitamente el scraping no autorizado, y existen consideraciones éticas en torno a la privacidad de los usuarios y el uso de los datos.
-
Tipos de datos. Comprender los tipos de datos disponibles en lihkg.com, como las publicaciones de los usuarios, los comentarios y los votos positivos, añade otra capa de complejidad al proceso de extracción.
Reflexiones finales
Comprender las complejidades que implica el scraping de un sitio web como lihkg.com es fundamental para cualquiera que se plantee emprender tal tarea.
Aunque existen herramientas que, en teoría, podrían facilitar la tarea, no pueden eliminar las responsabilidades legales y éticas que conlleva el scraping web.
Por lo tanto, es esencial abordar la tarea con una comprensión exhaustiva de estas complejidades y retos.
Al analizar estos aspectos en detalle, esperamos que este experimento mental haya aportado información valiosa sobre el mundo del web scraping.
Ser consciente de estos retos te permitirá moverte con mayor seguridad por el intrincado panorama del web scraping de forma responsable y eficaz.

