A menudo denominado la «portada de Internet», Reddit es un enorme centro de contenido generado por los usuarios.
Con 430 millones de usuarios activos al mes que participan en miles de debates sobre temas específicos, desde las últimas tendencias tecnológicas hasta aficiones muy especializadas, Reddit es una herramienta valiosa y una mina de oro de datos lista para ser explotada.
Pero, ¿cómo se pueden extraer estos datos de forma eficiente y ética?
En esta guía, profundizamos en el funcionamiento de los rastreadores de Reddit, la API oficial, las herramientas, las técnicas y las mejores prácticas para recopilar datos de Reddit de forma eficaz.
La importancia del scraping en Reddit
Los conocimientos basados en datos son clave para el éxito.
La extracción de datos de Reddit permite a las empresas, a los investigadores y a los entusiastas de los datos comprender la opinión pública, seguir las tendencias del mercado y recopilar contenido generado por los usuarios.
Estos datos, ricos y no estructurados, tienen numerosos casos de uso, tales como:
-
Estudios de mercado. Las diversas comunidades de Reddit, conocidas como «subreddits», abarcan prácticamente todos los intereses imaginables. Las empresas extraen publicaciones de Reddit para evaluar en tiempo real la opinión de los consumidores, sus preferencias y las tendencias emergentes.
-
Comentarios sobre productos. Los usuarios debaten con frecuencia sobre productos y servicios, ofreciendo opiniones sinceras. Estos datos, de un valor incalculable, ayudan a las empresas a perfeccionar sus ofertas y a dar respuesta a las inquietudes.
-
Análisis de la competencia. Al seguir los debates sobre la competencia, las empresas pueden identificar fortalezas, debilidades y oportunidades en el mercado.
-
Ideas de contenido. Los creadores de contenido y los profesionales del marketing utilizan Reddit para descubrir publicaciones populares y temas de actualidad, lo que garantiza que su contenido siga siendo relevante y atractivo.
-
Investigación académica. Los investigadores recurren a la amplia base de datos de Reddit para estudiar comportamientos en línea, tendencias culturales y dinámicas sociales.
-
Gestión de crisis. Las marcas pueden detectar a tiempo posibles crisis de relaciones públicas mediante el seguimiento de opiniones negativas o polémicas en Reddit.
-
Conjuntos de datos de entrenamiento. Para quienes trabajan en inteligencia artificial y aprendizaje automático, Reddit proporciona amplios conjuntos de datos para entrenar modelos, especialmente en el procesamiento del lenguaje natural.
Comprender la estructura de Reddit para un web scraping eficaz
Reddit es una plataforma compleja con una estructura única que la distingue de otras redes sociales.
Comprender esta estructura es fundamental para cualquiera que desee extraer datos de Reddit, ya que garantiza la obtención de información relevante y exhaustiva.
A continuación, ofrecemos un análisis en profundidad:
-
Subreddits. Son secciones centradas en la comunidad y dedicadas a temas o intereses específicos.
Cada subreddit tiene su propia URL, que suele indicarse como «r/[nombre_del_subreddit]».
Por ejemplo, hay «subreddits de ofertas» que se centran en promociones y descuentos.
Conocer la estructura de las URL de los subreddits es esencial para dirigirse a comunidades específicas.
-
Publicaciones. Los usuarios pueden publicar entradas en los subreddits. Las entradas pueden ir desde artículos de blog detallados hasta imágenes, vídeos o enlaces a sitios externos.
Cada entrada tiene su propia estructura, a menudo denominada «diccionario de la entrada», que incluye detalles como el autor, el título y el contenido actual de la misma.
-
Comentarios. Cada publicación individual puede tener comentarios, lo que da lugar a debates anidados.
Conocer la media de comentarios por publicación o centrarse en las publicaciones con muchos comentarios puede proporcionar datos más completos para el análisis.
-
Perfiles de usuario y usuarios de la aplicación. Cada usuario de Reddit, tanto si utiliza la aplicación de Reddit como si lo hace a través del navegador, tiene un perfil que muestra su actividad, incluidas las publicaciones y los comentarios.
Esto supone una mina de oro de datos, especialmente para analizar el comportamiento de los usuarios.
-
Productos digitales y compras en la aplicación. Reddit ofrece diversas opciones de distribución de productos digitales, como los premios y Reddit Premium.
Conocer cómo interactúan los usuarios con ellos, especialmente a través de las compras en la aplicación, puede ofrecer información sobre el comportamiento de gasto de los usuarios.
-
Publicidad en la aplicación. Reddit ofrece oportunidades publicitarias que permiten a las marcas llegar a grupos demográficos específicos o a comunidades de subreddits.
Se trata de una herramienta fundamental para las empresas que desean anunciarse en la plataforma.
-
Interacciones con el navegador. Tanto si los usuarios acceden a Reddit a través de una sesión de navegador como si utilizan extensiones de navegador, cada interacción deja un rastro de datos.
Saber cómo extraer información de las interacciones y los perfiles de los navegadores puede proporcionar una visión más profunda del comportamiento de los usuarios.
-
La nube y la implementación. Reddit utiliza soluciones de servicios en la nube, y comprender esto puede ser crucial, especialmente a la hora de tener en cuenta la nube durante la implementación.
-
Análisis y herramientas. Con las herramientas de análisis adecuadas, las empresas pueden descifrar cómo se aborda un tema en docenas de comunidades o cómo interactúan los usuarios con el botón de «voto positivo» o el elemento de «voto positivo».
-
Automatización e IA. Los modernos rastreadores de redes sociales vienen equipados con funciones de automatización. Algunos incluso utilizan herramientas de IA generativa para predecir el comportamiento de los usuarios o para generar contenido.
-
Consideraciones éticas. Al realizar el scraping, es esencial respetar a los respectivos propietarios del contenido y asegurarse de que se utilizan agentes de usuario descriptivos para evitar tergiversaciones.
Intenta siempre dirigirte a la URL de destino correcta para extraer la información que necesitas sin infringir los derechos de los usuarios.
- Elementos adicionales. Reddit es enorme, y hay otros elementos, como el diccionario de subreddits, los campos de descripción y mucho más, que pueden ser objeto de análisis para obtener datos más detallados.
La estructura multifacética de Reddit es un campo de juego para los rastreadores web. Para extraer datos significativos, es necesario comprender sus complejidades.
Tanto si analizas comentarios de subreddits, estudias líneas de código en busca de patrones o exploras cómo se comercializan los productos, conocer la estructura de Reddit garantiza que tus esfuerzos de scraping sean eficientes y éticos.
Herramienta de extracción 1: La API oficial de Reddit
Hay quien considera que Reddit no es más que otra plataforma de redes sociales. Sin embargo, su estructura única y su sistema de votación democrático lo convierten en mucho más que eso.
Reddit se nutre de contenido generado por los usuarios, agrupado en comunidades especializadas conocidas como «subreddits».
Cada subreddit trata un tema específico, lo que permite a los usuarios participar en debates, compartir recursos y pedir consejo.
El contenido con más votos positivos —las publicaciones más populares— asciende a los primeros puestos, lo que convierte a Reddit en un reflejo en tiempo real del interés y la opinión pública.
Descripción general y condiciones de la API de Reddit
La API oficial DATA de Reddit es una potente herramienta que proporciona acceso estructurado al vasto contenido de la plataforma.
Se trata de una herramienta esencial para desarrolladores, investigadores y empresas que deseen aprovechar la gran cantidad de información disponible en la plataforma.
La API permite a los desarrolladores externos leer comentarios, obtener información de los usuarios, acceder a los detalles de los subreddits y mucho más, de una manera eficiente y acorde con las directrices de Reddit.
Directrices de uso, limitaciones y restricciones
- Registro y requisitos de elegibilidad. Antes de acceder a la API de datos, los usuarios deben registrarse y asegurarse de que cumplen los criterios de elegibilidad. Esto incluye ser mayor de edad y no tener prohibido el uso de la API en virtud de ninguna ley aplicable.
- Licencia. Reddit concede una licencia no exclusiva, intransferible y revocable para acceder y utilizar la API de datos. Esto significa que los usuarios no pueden sublicenciar ni transferir sus derechos de acceso a la API a terceros.
- Contenido de los usuarios. Aunque el contenido de Reddit es generado por los usuarios, la API ofrece una forma de acceder a dicho contenido sin modificarlo. Cualquier uso del contenido de los usuarios debe respetar los derechos de los creadores originales del contenido.
- Privacidad y tratamiento de datos. Los desarrolladores deben revelar cómo gestionan los datos recopilados a través de la API, garantizando la transparencia y el cumplimiento de la legislación en materia de privacidad.
- Limitaciones de la API. Reddit puede imponer límites al uso de la API, como el número de solicitudes por hora. Es fundamental conocer y respetar estos límites para evitar interrupciones.
- Tarifas y uso comercial. Aunque la API es generalmente gratuita para un uso básico, Reddit se reserva el derecho a cobrar por niveles de uso más elevados o con fines comerciales.
- Cumplimiento. Los usuarios de la API deben cumplir con el Acuerdo de usuario de Reddit, la Política de privacidad y cualquier otra condición pertinente. Esto garantiza que el acceso a los datos se mantenga ético y en consonancia con las normas de la comunidad de Reddit.
Comprender y cumplir estas condiciones es fundamental para cualquiera que desee utilizar los datos de Reddit en sus aplicaciones o investigaciones. De este modo, se garantiza una experiencia de acceso a los datos fluida e ininterrumpida, al tiempo que se mantiene la integridad y los valores de la comunidad de Reddit.
Herramienta de extracción 2: Python y Selenium
Python es un lenguaje de programación muy utilizado, conocido por su sencillez y versatilidad.
Python ofrece una gran variedad de bibliotecas y marcos de trabajo que facilitan el scraping. Una de estas herramientas es Selenium, diseñada originalmente para pruebas web, pero que desde entonces se ha convertido en una herramienta imprescindible para tareas de scraping web.
Selenium funciona automatizando los navegadores web. Puede simular un comportamiento de navegación similar al de un usuario humano, lo que permite extraer datos de páginas web como si un usuario real estuviera navegando por ellas.
Cuando se combina con Python, Selenium permite a los desarrolladores escribir scripts capaces de realizar tareas como iniciar sesión en cuentas, navegar a páginas específicas, hacer clic en botones y, lo más importante, extraer datos.
Para plataformas como Reddit, que cuentan con abundante contenido dinámico (contenido que se carga o cambia sin que se actualice la página), Selenium resulta de un valor incalculable.
Las herramientas tradicionales de extracción de datos pueden tener dificultades con este tipo de contenido, pero Selenium, al ser una herramienta de automatización de navegadores, puede acceder a él fácilmente.
Ventajas de utilizar Python y Selenium para el scraping de Reddit
- Acceso al contenido dinámico. Como se ha mencionado, Selenium puede interactuar con contenido dinámico, lo que garantiza que no se pierda ningún dato durante el proceso de scraping.
- Interacciones similares a las humanas. La capacidad de Selenium para imitar interacciones humanas, como desplazarse por la página o hacer clic, puede ayudar a eludir algunas medidas contra el scraping.
- Flexibilidad. Las amplias bibliotecas de Python y las capacidades de automatización del navegador de Selenium constituyen una combinación flexible. Ya sea para gestionar cookies, gestionar sesiones o lidiar con ventanas emergentes, Python y Selenium pueden encargarse de todo.
- Amplia compatibilidad con navegadores. Selenium es compatible con múltiples navegadores, incluidos Chrome, Firefox y Safari, lo que permite el scraping en distintos navegadores si es necesario.
Posibles retos
- Rendimiento. Dado que Selenium automatiza un navegador real, puede resultar más lento que otras herramientas de scraping ligeras que obtienen directamente el código fuente de la página.
- Complejidad. Configurar un scraper basado en Selenium puede resultar más complejo que utilizar herramientas sencillas basadas en solicitudes HTTP, especialmente para principiantes.
- Medidas contra el scraping. Aunque Selenium puede eludir algunas técnicas contra el scraping, plataformas como Reddit están mejorando continuamente sus defensas. Esto significa que los scrapers podrían encontrarse con obstáculos como CAPTCHAs, límites de frecuencia o bloqueos temporales de direcciones IP.
- Mantenimiento. Las páginas web cambian con el tiempo. Si Reddit se somete a una renovación de diseño o modifica su estructura, el rastreador podría dejar de funcionar y requerir actualizaciones.
Herramienta de extracción 3: PRAW (Python Reddit API Wrapper)
PRAW, siglas de Python Reddit API Wrapper, es básicamente un puente entre las aplicaciones de Python y la API de Reddit.
En lugar de tener que lidiar con peticiones HTTP sin procesar y analizar respuestas JSON complejas, los desarrolladores pueden utilizar los métodos intuitivos de PRAW para obtener datos de Reddit e interactuar con ellos.
Ventajas de utilizar PRAW
-
Simplicidad. PRAW abstrae las complejidades de la API de Reddit, ofreciendo a los desarrolladores métodos sencillos para acceder a los datos.
Por ejemplo, obtener las publicaciones más populares de un subreddit o recuperar comentarios de un hilo específico se convierte en una tarea de tan solo unas pocas líneas de código.
-
Gestión de los límites de frecuencia. Reddit impone restricciones sobre la frecuencia con la que se puede acceder a su API.
PRAW gestiona automáticamente estos límites de frecuencia, garantizando que tu aplicación no los supere y no corra el riesgo de sufrir bloqueos temporales.
-
Cumplimiento normativo. Al utilizar PRAW, los desarrolladores cumplen de forma inherente con los términos de servicio de la API de Reddit, lo que minimiza el riesgo de problemas de acceso a los datos.
-
Documentación exhaustiva. PRAW incluye una documentación completa, lo que facilita tanto a los principiantes como a los desarrolladores experimentados dar los primeros pasos y resolver problemas.
-
Comunidad activa. PRAW cuenta con una comunidad activa. Esto se traduce en actualizaciones periódicas, una gran cantidad de recursos en línea y apoyo de la comunidad ante cualquier dificultad que surja.
Configuración básica y ejemplos de uso
Configuración
-
Antes de utilizar PRAW, registra una aplicación de script en el portal para desarrolladores de Reddit para obtener las credenciales de la API necesarias.
-
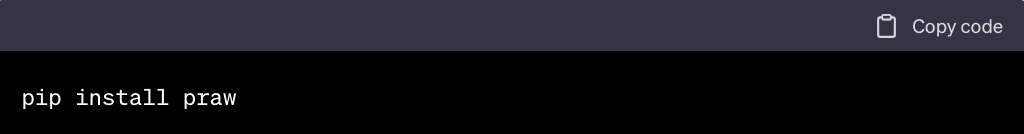
Instala PRAW mediante pip.
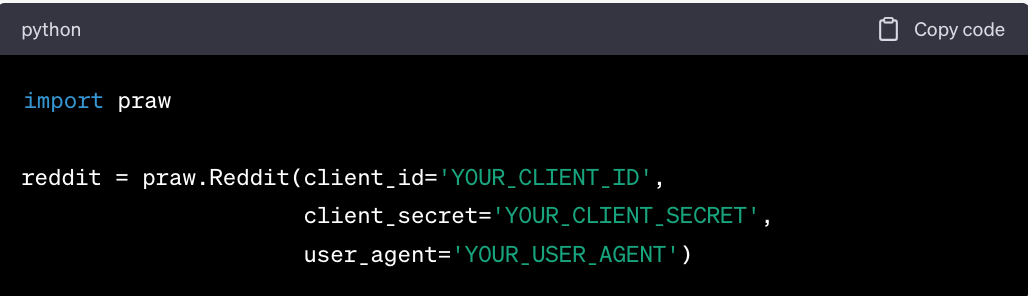
- Inicializa la instancia de Reddit con tus credenciales de la API.
Ejemplos de uso
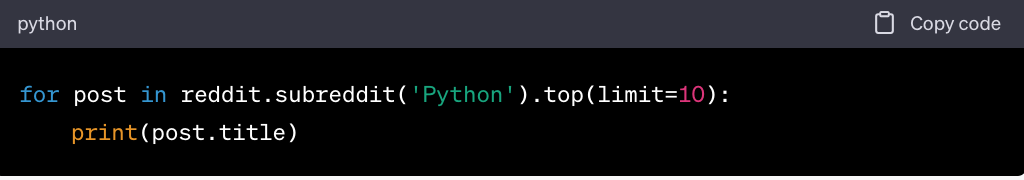
- Extraer las 10 publicaciones más populares de un subreddit
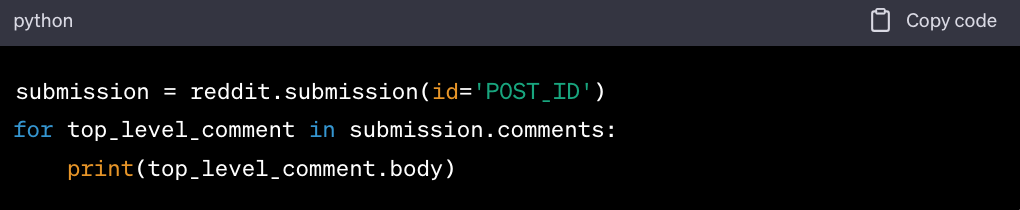
- Recuperar comentarios de un hilo específico
- Buscar publicaciones que contengan una palabra clave
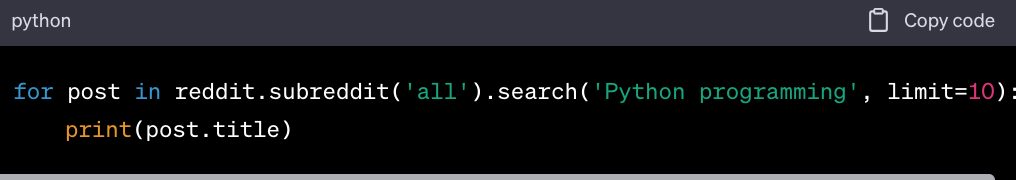
PRAW es una herramienta imprescindible para cualquiera que quiera profundizar en los datos de Reddit utilizando Python. Su sencillez, combinada con su potencia, la convierte en la opción ideal para proyectos que van desde sencillas tareas de extracción de datos hasta complejos trabajos de análisis de datos.
Herramienta de extracción n.º 4: el marco Scrapy
Scrapy es un marco de código abierto de alto nivel para el rastreo y la extracción de datos web, escrito en Python. Está diseñado para gestionar una amplia gama de tareas de extracción de datos, desde simples extracciones puntuales hasta proyectos complejos de rastreo web a gran escala. Scrapy no se limita únicamente a Reddit, sino que puede utilizarse para extraer datos de cualquier sitio web.
Características principales
-
Versatilidad. Scrapy puede extraer datos de sitios web utilizando selectores CSS, XPath o incluso expresiones regulares, lo que le permite adaptarse a diversas estructuras de sitios web.
-
Middleware y extensiones. Scrapy admite middleware y extensiones, lo que permite a los desarrolladores personalizar el proceso de extracción de datos, gestionar reintentos, agentes de usuario e incluso integrar grupos de proxies.
-
Pipelines. Una vez extraídos los datos, Scrapy ofrece pipelines de elementos para procesar, validar y almacenar los datos. Esto puede realizarse en bases de datos, archivos o incluso en almacenamiento en la nube.
-
Rastreo simultáneo. Scrapy se basa en la biblioteca de redes asíncronas Twisted, lo que le permite gestionar múltiples solicitudes de forma simultánea, acelerando así el proceso de extracción de datos.
-
Gestión robusta de errores. Scrapy puede gestionar los errores con elegancia, garantizando que un pequeño contratiempo no detenga todo el proceso de extracción.
-
Exportadores integrados. Scrapy puede exportar los resultados en múltiples formatos, como JSON, CSV y XML, sin necesidad de plugins ni herramientas adicionales.
Cómo configurar y utilizar Scrapy para la extracción de datos de Reddit
Configuración de Scrapy: tutorial paso a paso
-
¡Instala Scrapy con pip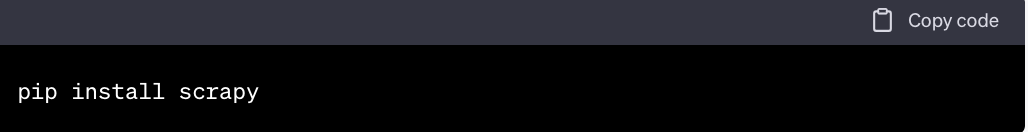
-
¡Inicia un nuevo proyecto de Scrapy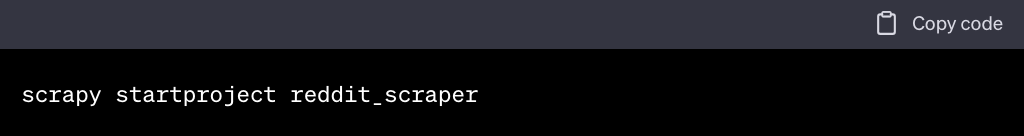
Uso de Scrapy para la extracción de datos de Reddit
-
Crea una araña (spider). Dentro de tu proyecto de Scrapy, crearás arañas, que son clases que definen cómo seguir enlaces y extraer datos. Para Reddit, podrías crear una araña como esta: 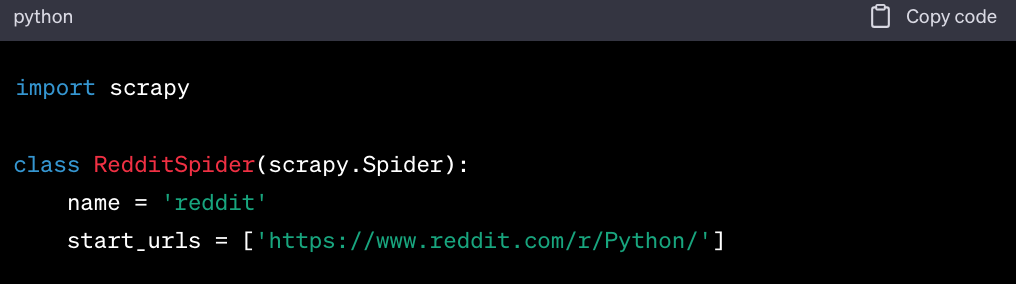
-
Define la lógica de extracción. Utiliza selectores CSS o XPath para extraer datos de la página de Reddit. 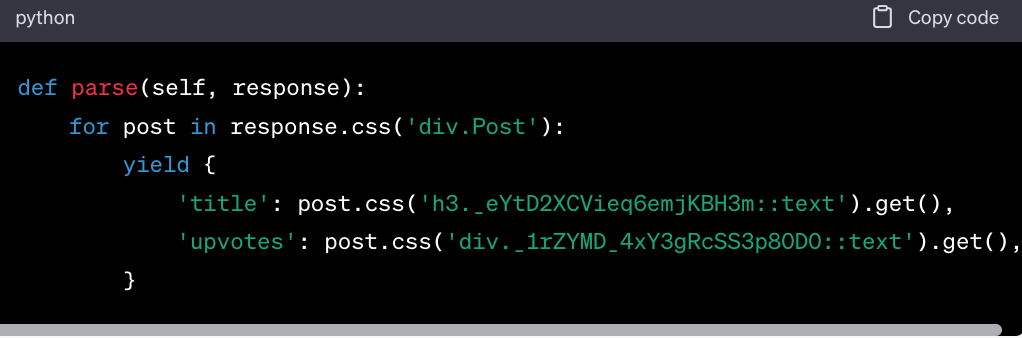
-
Sigue la paginación. Reddit tiene varias páginas de contenido. Scrapy se puede configurar para seguir enlaces y extraer datos de diferentes páginas.
-
Ejecuta el spider: Una vez configurado el spider, ve al directorio del proyecto y ejecuta: 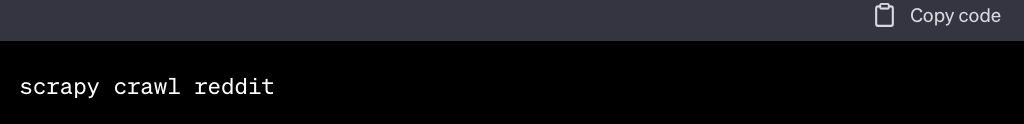
-
Almacenamiento de datos: Scrapy puede almacenar los datos extraídos en varios formatos. Por ejemplo, para almacenar los datos en un archivo JSON: 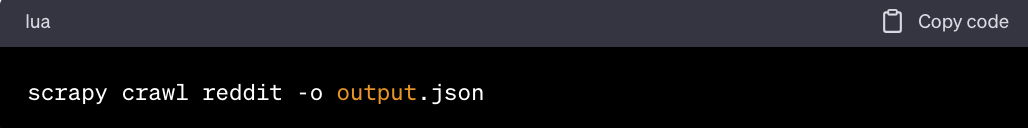
Herramienta de extracción n.º 5: Repositorios de GitHub
GitHub, la plataforma de desarrollo de software líder en el mundo, alberga una gran cantidad de repositorios dedicados a diversas tareas, entre ellas el scraping web.
Entre ellos, hay numerosos repositorios centrados específicamente en la extracción de datos de Reddit.
Estos repositorios suelen ofrecer herramientas, scripts o bibliotecas ya creadas que pueden simplificar el proceso de extracción de datos de Reddit y hacerlo accesible incluso para quienes tienen poca experiencia en programación.
Ventajas de utilizar repositorios de GitHub para la extracción de datos de Reddit
-
Soluciones listas para usar. Muchos repositorios de GitHub ofrecen soluciones completas que requieren una configuración mínima. Los usuarios pueden clonar el repositorio, seguir las instrucciones proporcionadas y empezar a extraer datos sin tener que crear una herramienta desde cero.
-
Apoyo de la comunidad. Los repositorios populares suelen contar con comunidades activas. Los usuarios pueden plantear problemas, pedir ayuda o incluso contribuir al proyecto, mejorando así las capacidades de la herramienta.
-
Actualizaciones continuas. Dada la naturaleza dinámica de los sitios web, las herramientas de scraping necesitan actualizaciones periódicas. Los repositorios activos de GitHub se actualizan con frecuencia para adaptarse a los cambios en la estructura del sitio web de destino o para mejorar su funcionalidad.
-
Enfoques diversos. Los distintos repositorios pueden emplear diversas técnicas o herramientas para el scraping, desde soluciones basadas en Python como PRAW o Scrapy hasta Node.js o incluso aplicaciones en Docker. Esta diversidad permite a los usuarios elegir una herramienta que se adapte a sus conocimientos técnicos y a los requisitos de su proyecto.
-
Documentación y ejemplos. La mayoría de los repositorios de prestigio ofrecen documentación exhaustiva, guías de configuración y ejemplos de uso, lo que garantiza que los usuarios puedan ponerse en marcha sin dificultades.
Explorar GitHub en busca de rastreadores de Reddit
Una simple búsqueda en GitHub con el término «reddit-scraper» revela una amplia gama de repositorios diseñados específicamente para la extracción de datos de Reddit.
Algunos repositorios interesantes que puedes encontrar son:
-
Bots de extracción de datos de Reddit. Se trata de scripts automatizados que pueden recuperar publicaciones, comentarios y mucho más de subreddits o hilos específicos.
-
Envoltorios de la API de Reddit. Aunque PRAW es el más popular, otros envoltorios pueden ofrecer características únicas o estar adaptados a diferentes lenguajes de programación.
-
Scrapers de Reddit en Docker. Para quienes buscan soluciones en contenedores, algunos repositorios ofrecen configuraciones de Docker que garantizan operaciones de extracción coherentes y escalables.
-
Herramientas especializadas. Algunas herramientas de rastreo de Reddit pueden centrarse en tareas específicas, como descargar todas las imágenes de un subreddit, extraer temas de tendencia o monitorizar palabras clave concretas.
Pasos para utilizar un repositorio de GitHub para el scraping de Reddit
-
Elige un repositorio. Accede al tema «reddit-scraper» en GitHub y selecciona un repositorio que se ajuste a tus necesidades.
-
Clona y configura. Sigue las instrucciones del repositorio, que suelen consistir en clonarlo y configurar las dependencias necesarias.
-
Configura. Muchas herramientas requieren cierta configuración, como especificar el subreddit de destino, configurar claves de API o definir formatos de salida.
-
Ejecutar y extraer datos. Ejecuta los scripts o comandos proporcionados para iniciar el proceso de extracción de datos.
-
Posprocesamiento. Dependiendo de la herramienta, es posible que tengas que procesar los datos extraídos posteriormente, por ejemplo, filtrándolos, limpiándolos o convirtiéndolos al formato deseado.
Herramienta de extracción n.º 6: Herramientas de extracción de Reddit de terceros
La inmensidad y riqueza de los datos de Reddit han propiciado la aparición de varias herramientas de extracción de terceros. Estas herramientas tienen como objetivo simplificar el proceso de extracción, haciéndolo accesible a un público más amplio, desde empresas hasta investigadores. Veamos algunas de las herramientas de extracción de Reddit de terceros más populares:
- Modelo de precios: Ofrece un modelo flexible de «pay-as-you-go».
- Experiencia de usuario: Interfaz intuitiva adecuada tanto para principiantes como para expertos.
- Rendimiento: Extracción de datos rápida y fiable.
- Privacidad: Da prioridad a la privacidad del usuario, garantizando la integridad y la seguridad de los datos.
- Automatización: Incorpora automatización basada en IA para un scraping adaptativo.
- Transformación de datos: Herramientas integradas para refinar y analizar los datos extraídos.
- Versatilidad: Solución integral de scraping dirigida a múltiples sitios web.
- Interfaz: Interfaz visual que facilita el diseño de proyectos.
- Funcionalidades avanzadas: Gestiona AJAX y JavaScript para una extracción exhaustiva de datos.
- Programación: Ofrece funciones para configurar tareas de scraping recurrentes.
- Implementación: Ofrece opciones de extracción tanto en la nube como locales.
- Fácil de usar: Configuración sencilla con funciones para gestionar CAPTCHAs y bloqueos de IP.
- Integración: Incluye integración con API para una transferencia de datos fluida.
- Simplicidad: Se centra en ofrecer módulos preconfigurados para facilitar el scraping.
- Asequibilidad: Destaca por sus soluciones rentables, adecuadas para distintos presupuestos.
- Servicio principal: Conocido como proveedor de proxies con conocimientos especializados en scraping.
- Anonimato: Ofrece direcciones IP rotativas y un amplio conjunto de proxies residenciales para el scraping anónimo.
- Asesoramiento: Proporciona guías detalladas sobre el scraping web, incluyendo Reddit.
- Enfoque basado en API: Ofrece una API sencilla para una fácil integración en los sistemas existentes.
- Escalabilidad: Diseñado para gestionar tareas de scraping a gran escala sin comprometer la velocidad.
- Anonimato: Utiliza un sistema de proxies rotativos para garantizar un scraping anónimo e ininterrumpido.
- Versatilidad: es compatible con múltiples plataformas, siendo Reddit una de sus especialidades.
Aunque cada herramienta de scraping de terceros aporta sus propias ventajas, el enfoque centrado en el usuario y la política de precios flexible de Geonode la convierten en una opción destacada.
No obstante, la mejor herramienta suele depender de los requisitos individuales, los conocimientos técnicos y el presupuesto.
Buenas prácticas y consideraciones éticas
El scraping de Reddit, aunque es una herramienta muy eficaz para la extracción de datos, conlleva una serie de responsabilidades.
Garantizar unas prácticas éticas no solo protege los derechos de los usuarios, sino que también asegura la continuidad y la reputación de tus iniciativas de scraping.
A continuación, te ofrecemos un análisis en profundidad de las mejores prácticas y consideraciones éticas a la hora de realizar scraping en Reddit:
Respeto a la privacidad de los usuarios
La era digital ha traído consigo una mayor preocupación por la privacidad de los usuarios. Al extraer datos de Reddit, es fundamental dar prioridad a la privacidad de los usuarios de la plataforma.
-
Extracción ética. Asegúrate siempre de que los datos que extraes sean de acceso público. Evita extraer información personal o contenido de subreddits privados. Recuerda que el hecho de que los datos sean accesibles no significa que sea ético extraerlos.
-
Anonimato. Aunque los usuarios de Reddit utilizan seudónimos, es esencial tratar estos datos con cuidado. Evita acciones que puedan desanonimizar a los usuarios o revelar sus identidades en el mundo real.
-
Protección de datos. Si almacenas datos extraídos, asegúrate de que estén cifrados y se guarden de forma segura. Implementa medidas sólidas de ciberseguridad para evitar el acceso no autorizado.
-
Transparencia. Si utilizas datos extraídos con fines de investigación o comerciales, sé transparente sobre tus fuentes de datos y sobre cómo se utilizarán dichos datos.
Gestión de los límites de frecuencia y las restricciones
Reddit, al igual que muchas plataformas, aplica límites de frecuencia para garantizar la estabilidad del servidor y evitar usos indebidos.
-
Comprende los límites de la API. Si utilizas la API de Reddit, familiarízate con sus límites de frecuencia. Normalmente, estos se establecen en un número determinado de solicitudes por minuto. Superar estos límites puede dar lugar a bloqueos temporales o permanentes.
-
Utiliza retrasos. Introduce retrasos entre las solicitudes de scraping. Esto no solo respeta los servidores de la plataforma, sino que también reduce las posibilidades de que tu scraper sea identificado y bloqueado.
-
Rota las direcciones IP y los user-agents con un proveedor de servicios de proxy fiable. El uso de los proxies residenciales de Geonode puede ayudar a eludir las restricciones al proporcionar un conjunto rotativo de direcciones IP, lo que hace que tus actividades de scraping parezcan más orgánicas. Junto con la rotación de los user-agents, esta estrategia puede reducir significativamente las posibilidades de ser bloqueado. Sin embargo, utiliza siempre esta estrategia de forma ética y evita el scraping agresivo que perturbe el funcionamiento de la plataforma.
-
Respeta el archivo robots.txt de Reddit. El archivo robots.txt ofrece directrices sobre lo que se puede y lo que no se puede extraer. Comprueba siempre las normas de Reddit y cúmplelas.
Almacenamiento y uso de los datos
La responsabilidad no termina tras el scraping de datos. La forma en que se almacenan y utilizan estos datos también es crucial.
-
Almacenamiento seguro. Asegúrate de que todos los datos almacenados se guarden en bases de datos cifradas. Realiza copias de seguridad periódicas de estos datos e implementa medidas de seguridad para evitar filtraciones.
-
Minimización de datos. Almacena únicamente los datos que sean necesarios para tu finalidad. Evita acumular cantidades excesivas de información, especialmente si es sensible o personal.
-
Uso ético. Si publicas o compartes datos extraídos, asegúrate de que no perjudiquen ni den una imagen errónea de la comunidad de Reddit.
Pide siempre consentimiento si utilizas los datos de formas que puedan afectar a los usuarios o a su reputación.
-
Mantente al día: Las condiciones de servicio y las directrices de la comunidad de Reddit pueden cambiar. Revísalas periódicamente para asegurarte de que tus prácticas de extracción de datos siguen cumpliendo con la normativa.
Aunque la extracción de datos de Reddit ofrece amplias oportunidades para la obtención de información, es fundamental abordarla con respeto y responsabilidad.
El uso de herramientas como los proxies residenciales de Geonode puede mejorar tus capacidades de scraping, pero las consideraciones éticas deben estar siempre en primer plano en cualquier proyecto de scraping, garantizando que se respeten en todo momento los derechos de los usuarios y de la plataforma.
Preguntas relacionadas
P: ¿Cuál es la diferencia entre utilizar la API oficial de Reddit y los rastreadores de terceros?
R: La API oficial de Reddit la proporciona Reddit y tiene límites de frecuencia y condiciones de uso específicos. Los rastreadores de terceros pueden ofrecer más flexibilidad, pero es posible que no siempre cumplan con las directrices de Reddit.
P: ¿Cómo puedo asegurarme de que estoy rastreando Reddit de forma ética y legal?
R: Respeta siempre la privacidad de los usuarios, cumple con las condiciones de servicio de Reddit y evita extraer información privada o sensible.
P: ¿Hay algún coste asociado al uso de la API de Reddit?
R: Aunque el acceso básico es gratuito, puede haber costes asociados a un mayor volumen de solicitudes o a funciones premium.
P: ¿Cómo puedo gestionar los límites de frecuencia y evitar que me bloqueen?
R: Introduce retrasos entre las solicitudes, respeta el archivo robots.txt de Reddit y plantéate utilizar proxies rotativos.
P: ¿Cuáles son las mejores herramientas para extraer comentarios de Reddit y otros datos?
R: Entre las herramientas más populares se encuentran Geonode, Parsehub y Octoparse, pero la mejor herramienta depende de las necesidades y los conocimientos de cada uno.
Dar el primer paso hacia el scraping de Reddit
El scraping de Reddit puede parecer abrumador al principio, sobre todo con la gran cantidad de herramientas y técnicas que tienes a tu disposición.
Sin embargo, recuerda que todos los expertos fueron principiantes en su día. La clave está en empezar poco a poco e ir ampliando el alcance a medida que ganes confianza y conocimientos.
Tanto si eres un investigador en busca de conocimientos, un profesional del marketing que analiza tendencias o un entusiasta de los datos con curiosidad, el scraping de Reddit puede desvelarte una gran cantidad de información. Es una habilidad que encarna a la perfección el dicho: «En el mundo de la programación, las posibilidades son infinitas».
Así que, arremángate y embárcate hoy mismo en tu aventura de scraping en Reddit. Acepta los retos y recuerda que cada obstáculo es un peldaño hacia el dominio de esta técnica.

