Introduction
Réseau de diffusion de contenu (CDN) de premier plan, CloudFront.net offre des possibilités inégalées lorsqu’il est associé à la puissance du web scraping. Ce guide explore cette synergie et propose des conseils pour optimiser l’efficacité, garantir l’exactitude des données et utiliser ce domaine de manière responsable.
CloudFront.net : un géant de la diffusion de contenu
Amazon CloudFront, souvent désigné par son nom de domaine « CloudFront.net », est un service de réseau de diffusion de contenu (CDN) proposé par Amazon Web Services (AWS).
Un CDN est un système de serveurs distribués qui diffuse du contenu web et des applications aux utilisateurs en fonction de leur emplacement géographique. Il vise à offrir une haute disponibilité et des performances élevées en répartissant le service géographiquement par rapport aux utilisateurs finaux.
CloudFront s'intègre à d'autres services AWS pour offrir aux développeurs et aux entreprises un moyen optimisé de diffuser du contenu aux utilisateurs finaux avec une faible latence et des vitesses de transfert de données élevées.
Il fonctionne en stockant des copies de votre contenu dans plusieurs emplacements à travers le monde, appelés « emplacements périphériques ». Lorsqu’un utilisateur demande du contenu, CloudFront le diffuse depuis l’emplacement périphérique le plus proche, garantissant ainsi un temps de chargement aussi rapide que possible.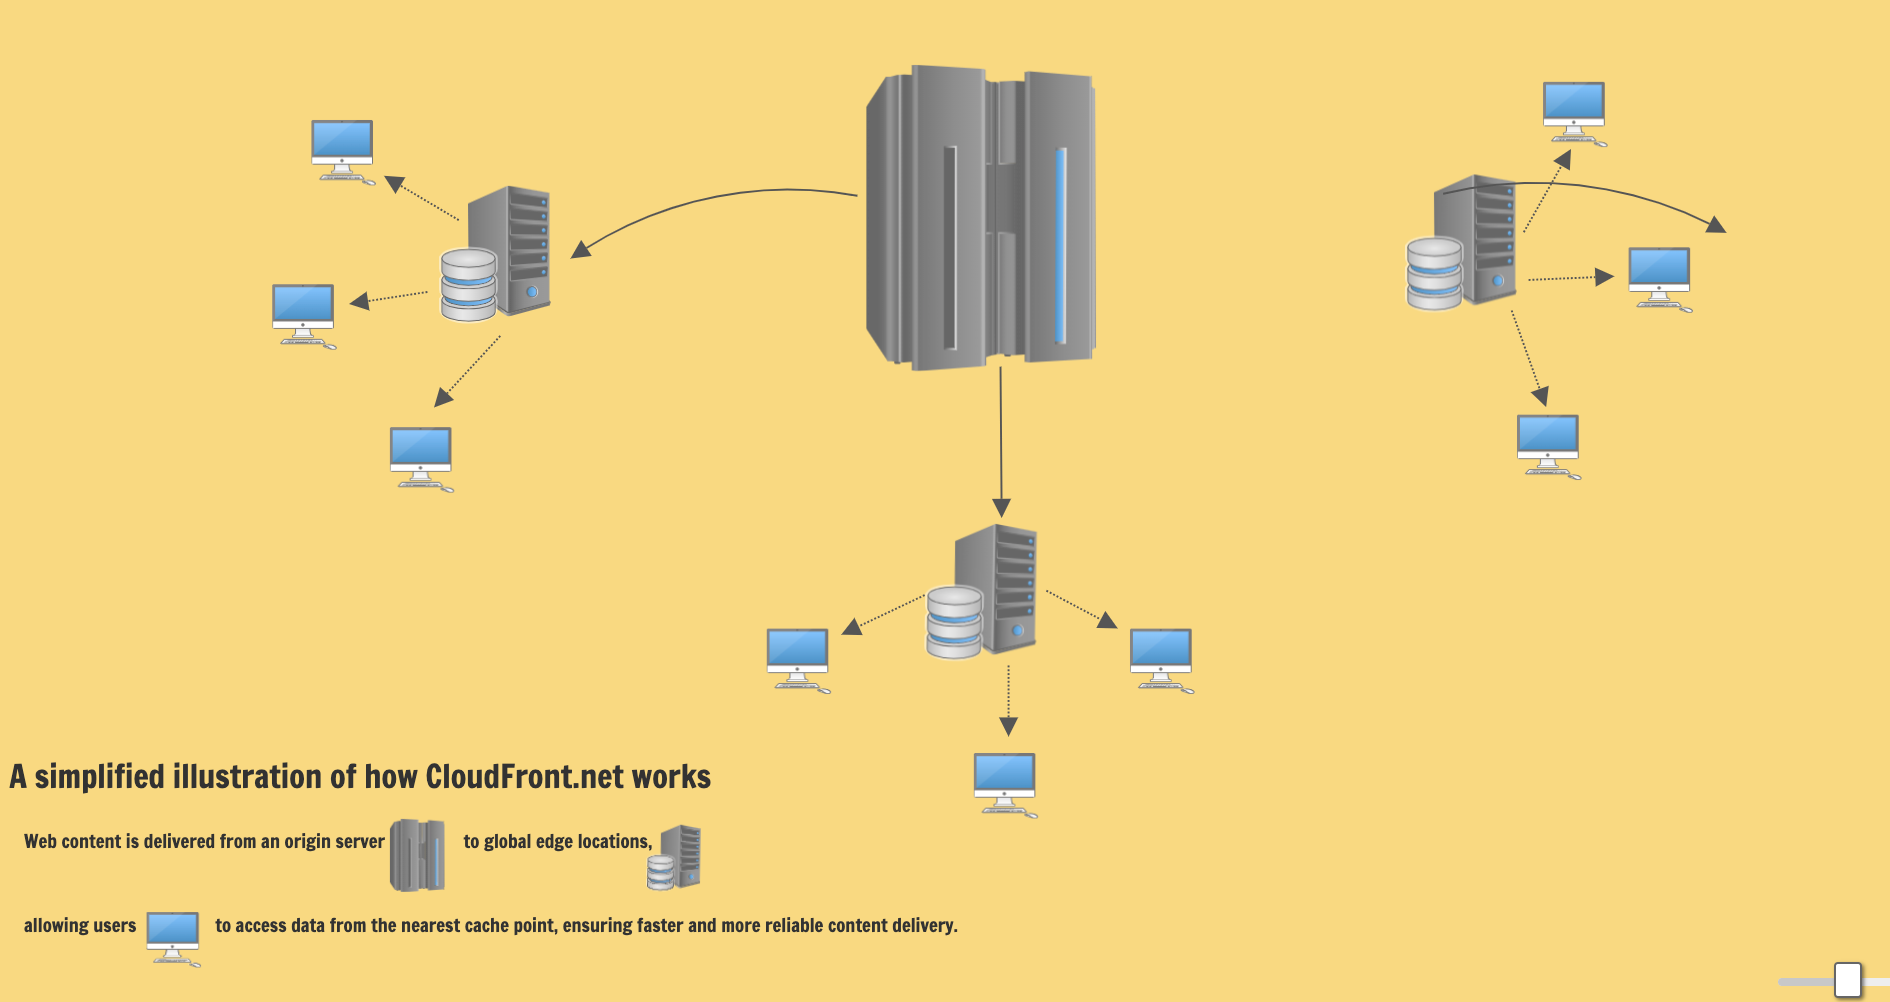
Principales fonctionnalités et avantages de CloudFront
-
Couverture mondiale. CloudFront dispose d’un vaste réseau de points de présence à travers le monde afin de réduire la latence et de garantir que le contenu soit diffusé depuis le point le plus proche de l’utilisateur final.
-
Intégration approfondie à AWS. CloudFront est intégré aux services AWS tels qu’Amazon S3, Amazon EC2, Elastic Load Balancing et Route 53, ce qui facilite leur utilisation conjointe.
-
Sécurité. CloudFront offre plusieurs niveaux de sécurité, notamment la prise en charge du protocole HTTPS, AWS Shield pour la protection contre les attaques DDoS et l’intégration d’AWS WAF (pare-feu d’applications web).
Photo de Vecteezy
-
Options de personnalisation. Les développeurs peuvent personnaliser la diffusion de contenu et adapter le CDN aux exigences spécifiques de leurs applications.
-
Rentabilité. CloudFront utilise un modèle de facturation à l’pay-as-you-go, ce qui garantit que vous ne payez que pour les données que vous transférez, sans aucun coût initial.
-
Diffusion de contenu dynamique et statique. Alors que de nombreux CDN se spécialisent dans la diffusion de contenu statique, CloudFront prend en charge à la fois le contenu statique et dynamique.
-
Convivialité pour les développeurs. Grâce à des SDK et à une API bien documentée, les développeurs peuvent facilement intégrer et gérer les distributions CloudFront.
-
Métriques et journaux en temps réel. CloudFront fournit des métriques et des journaux détaillés, permettant une analyse et une surveillance approfondies de la diffusion de contenu.
Comprendre le web scraping et l'extraction de données
Le web scraping est le processus qui consiste à collecter des données à partir d'un site web.
Il consiste à envoyer des requêtes HTTP à des pages Web, à récupérer le contenu HTML, puis à analyser et extraire les informations souhaitées.
Photo de Vecteezy
Contrairement à la copie manuelle de données à partir d’un site web, le web scraping automatise ce processus, permettant ainsi d’extraire de grandes quantités de données en un temps relativement court.
Le processus comprend généralement les étapes suivantes :
- Envoi d’une requête. Un scraper envoie une requête HTTP au site web cible.
- Réception de la réponse. Le site web répond en renvoyant du contenu HTML.
- Analyse du contenu. Le scraper traite le code HTML à l’aide de techniques d’analyse syntaxique afin d’identifier des structures de données spécifiques.
- Extraction des données. Une fois identifiées, les données souhaitées sont extraites du contenu analysé.
- Stockage des données. Les données extraites sont ensuite stockées dans un format structuré, souvent dans des bases de données ou des tableurs.
L’impact du web scraping dans différents secteurs
Le web scraping trouve une multitude d’applications dans divers secteurs :
-
Le commerce électronique. Les détaillants effectuent du web scraping sur les sites de leurs concurrents pour surveiller les prix et les offres de produits.
-
Immobilier. Les sites immobiliers sont scrappés pour recueillir des données sur les annonces immobilières, les prix et les tendances du marché.
-
Recrutement. Les portails d’emploi sont scrappés pour trouver des offres d’emploi et analyser la demande du marché pour des compétences spécifiques. 
Photo de Vecteezy
-
Finance. Les institutions financières effectuent du web scraping sur les sites boursiers pour suivre les cours des actions, l’actualité et le sentiment du marché.
-
Recherche. Les universitaires et les chercheurs effectuent du web scraping pour collecter des données dans divers domaines.
-
Actualités et médias. Les agrégateurs effectuent du web scraping sur les sites d’actualités pour sélectionner du contenu provenant de différentes sources.
-
Voyages. Les agences de voyage effectuent du web scraping sur les sites des compagnies aériennes et des hôtels pour comparer les prix et générer des offres.
Outils et techniques de web scraping
Il existe de nombreux outils et techniques de web scraping, allant de simples extensions de navigateur à des logiciels complexes.
1. Les navigateurs sans interface utilisateur 
Photo de Vecteezy
Les navigateurs sans interface jouent un rôle important dans le web scraping moderne, en particulier lorsqu’il s’agit de plateformes telles que CloudFront.net. Voici pourquoi ils sont souvent indispensables pour extraire des données de CloudFront.net :
-
Chargement dynamique du contenu. De nombreux sites web, y compris ceux hébergés sur CloudFront.net, utilisent JavaScript pour charger du contenu de manière dynamique.
Les outils de scraping traditionnels récupèrent le code HTML initial d’une page, qui peut ne pas contenir toutes les données si le contenu est chargé de manière asynchrone via JavaScript.
Les navigateurs sans interface utilisateur peuvent exécuter du JavaScript, ce qui permet aux outils de scraping d’accéder au contenu chargé dynamiquement.
-
Simulation du comportement réel des utilisateurs. Les navigateurs sans interface utilisateur peuvent imiter les interactions réelles des utilisateurs, telles que le défilement, les clics sur des boutons ou le remplissage de formulaires.
Cette capacité est cruciale lorsque les données que vous souhaitez extraire dépendent d’une interaction de l’utilisateur.
-
Affichage des pages Web. Certains contenus sur CloudFront.net peuvent être affichés à l’aide de frameworks Web tels que React, Angular ou Vue.js. Ces frameworks nécessitent souvent un environnement de navigateur pour afficher correctement le contenu de la page.
Les navigateurs sans interface graphique peuvent afficher ces pages, garantissant ainsi que le robot de scraping perçoit la page exactement comme le ferait un utilisateur humain.
-
Cookies et sessions. Les navigateurs sans interface graphique peuvent gérer les cookies et les sessions, ce qui peut s’avérer nécessaire pour accéder à certains contenus sur CloudFront.net, en particulier si ceux-ci nécessitent une authentification de l’utilisateur ou un suivi de session.
-
Débogage et développement. Les navigateurs sans interface sont souvent fournis avec des outils de développement permettant de déboguer et de tester les scripts de scraping.
Cette fonctionnalité est inestimable lors du développement et du perfectionnement de stratégies de scraping pour des sites web complexes.
2. Python et BeautifulSoup
Python est un langage de programmation polyvalent largement utilisé pour le web scraping, qui vous permet d’écrire des lignes de code adaptées à vos besoins. Il dispose de bibliothèques simples mais complètes, dont BeautifulSoup. 
Photo provenant de Pexels
BeautifulSoup est une bibliothèque Python qui vous permet de collecter des informations à partir de pages web. Elle crée un arbre d’analyse à partir du code source de la page, qui peut être utilisé pour extraire des données de manière hiérarchique et plus lisible.
Associée à la bibliothèque `requests` de Python pour récupérer des pages web, BeautifulSoup rend le processus de scraping web simple et efficace.
Principales fonctionnalités de BeautifulSoup
- Analyse simple. Permet d’analyser aussi bien des fichiers HTML ou XML bien formés que mal formés.
- Méthodes de recherche. Fournit des méthodes telles que `find()`, `find_all()` et `select()` pour naviguer et effectuer des recherches dans l’arbre de parse.
- Manipulation des balises. Permet de manipuler facilement les balises et les attributs.
- Encodage. Convertit automatiquement les documents entrants en Unicode et les documents sortants en encodage UTF-8.
3. Les proxys pour un web scraping optimisé
Les proxys font office d’intermédiaires entre un utilisateur et Internet. Ils jouent un rôle essentiel dans le web scraping pour plusieurs raisons :
-
Anonymat. Le web scraping peut entraîner des blocages d’adresse IP si les sites web détectent un trafic inhabituel provenant d’une seule adresse IP.
Les proxys masquent la véritable adresse IP du scraper, garantissant ainsi l’anonymat et réduisant le risque de détection et de blocage.
-
Ciblage géographique. Certains sites web affichent des contenus différents en fonction de la localisation géographique de l’utilisateur.
Les proxys permettent aux scrapers d’accéder à des contenus provenant de régions spécifiques en utilisant des adresses IP de ces zones.
-
Limitation de débit. Les sites web imposent souvent des limites de débit pour éviter la surcharge. En alternant entre plusieurs adresses IP de proxy, les scrapers peuvent envoyer davantage de requêtes à un site web sans atteindre ces limites de débit.
Photo provenant de Pexels
-
Scraping parallèle. L'utilisation de plusieurs proxys permet d'effectuer des requêtes simultanées, ce qui accélère le processus d'extraction des données, en particulier pour les tâches de scraping à grande échelle.
-
Réduction des blocages. Les sites web ont recours à diverses mesures anti-scraping. Les proxys, en particulier lorsqu'ils sont changés fréquemment, peuvent aider à contourner ces mesures, garantissant ainsi un scraping ininterrompu.
Pourquoi extraire des données de CloudFront.net ?
Voici quelques exemples concrets d'utilisation des données pouvant être collectées sur CloudFront.net (ou sur des sites web diffusés via CloudFront) :
-
Analyse concurrentielle. Les entreprises peuvent souhaiter comprendre le contenu, la structure ou les ressources du site web d'un concurrent diffusé via CloudFront afin d'évaluer ses stratégies en ligne, ses offres ou sa présence numérique.
-
Agrégation de contenu. Les agrégateurs, tels que les plateformes d’actualités ou de comparaison de prix, peuvent extraire des données de sites diffusés via CloudFront afin de collecter et de présenter des informations consolidées à leurs utilisateurs, leur apportant ainsi une valeur ajoutée grâce à des données exhaustives.
-
Recherche et fins académiques. Les chercheurs ou les étudiants peuvent extraire des données de sites web hébergés sur CloudFront afin de collecter des informations pour des projets universitaires, des études ou des articles, dans le but d’analyser des tendances, des schémas ou des phénomènes.
[Photo](https://Photo par Vlada Karpovich https) sur Pexels
-
Analyse SEO. Les professionnels du référencement naturel peuvent extraire des données de sites hébergés sur CloudFront afin de comprendre leurs stratégies de référencement sur la page, leurs profils de liens entrants ou la structure de leur contenu, ce qui les aide à affiner leurs propres tactiques de référencement ou celles de leurs clients.
-
Surveillance du contenu. Les marques ou les particuliers peuvent souhaiter surveiller des sites web spécifiques hébergés sur CloudFront à la recherche de mentions, d’avis ou de mises à jour, ce qui leur permet de rester informés et de réagir rapidement aux nouveaux contenus.
-
Sauvegarde et archivage. Certaines entités peuvent souhaiter créer des sauvegardes de leur propre contenu web diffusé via CloudFront, afin de disposer de versions historiques ou d’archives pour référence future.
-
Analyse de marché. Les entreprises de commerce électronique ou les analystes de marché peuvent extraire des listes de produits, des avis ou des données tarifaires à partir de sites hébergés sur CloudFront afin de comprendre les tendances du marché, les préférences des consommateurs ou les stratégies de tarification.
Il est essentiel de noter que, bien que ces cas d’utilisation constituent des raisons légitimes de pratiquer le web scraping, vous devez toujours veiller à respecter les principes éthiques, en particulier lorsque vous traitez des sites diffusés via des CDN robustes tels que CloudFront.
Comment extraire des données de CloudFront.net
- Identifiez l'URL cible. Déterminez l'URL CloudFront.net spécifique que vous souhaitez analyser.

- Inspectez la page Web. Utilisez les outils de développement de votre navigateur pour inspecter la structure de la page et identifier les données que vous souhaitez extraire.

- Écrivez le script de scraping. Utilisez des bibliothèques Python pour écrire un script qui récupère et analyse la page Web.
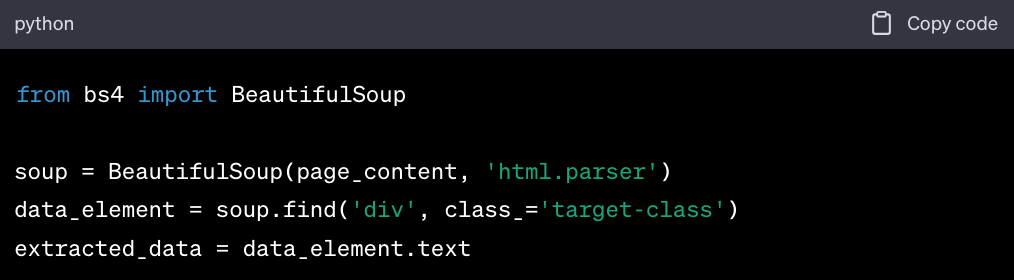
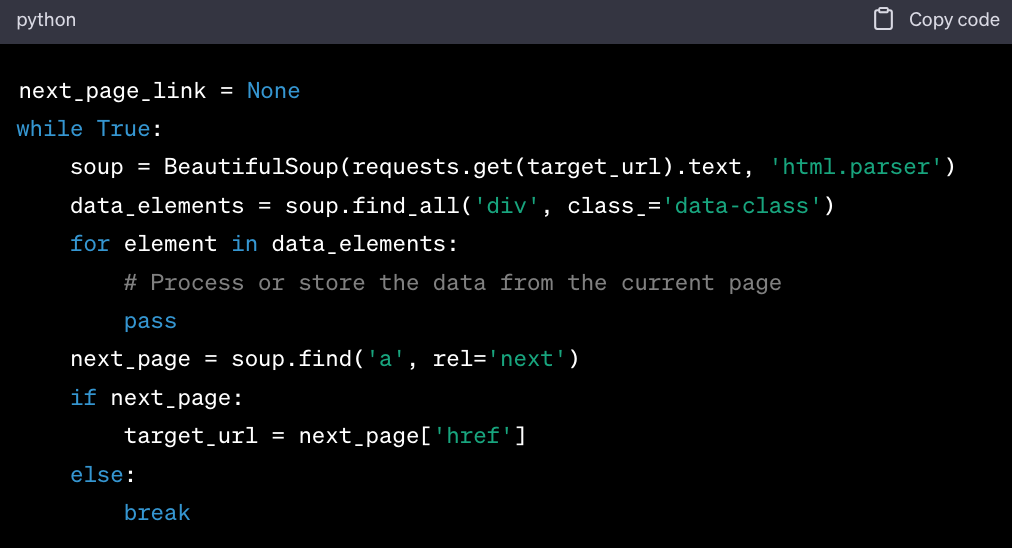
- Gérer la pagination. Si le contenu s’étend sur plusieurs pages, assurez-vous que votre script puisse naviguer et extraire les données de toutes les pages. (En supposant que chaque page comporte un bouton « Suivant » renvoyant à la page suivante.)
- Stocker les données. Enregistrez les données extraites dans un format structuré tel qu’un fichier CSV, JSON ou une base de données.

- Respectez le fichier
robots.txt : Vérifiez et respectez toujours le fichier robots.txt de CloudFront.net afin de vous assurer que vous n’enfreignez aucune règle relative à l’extraction de données. 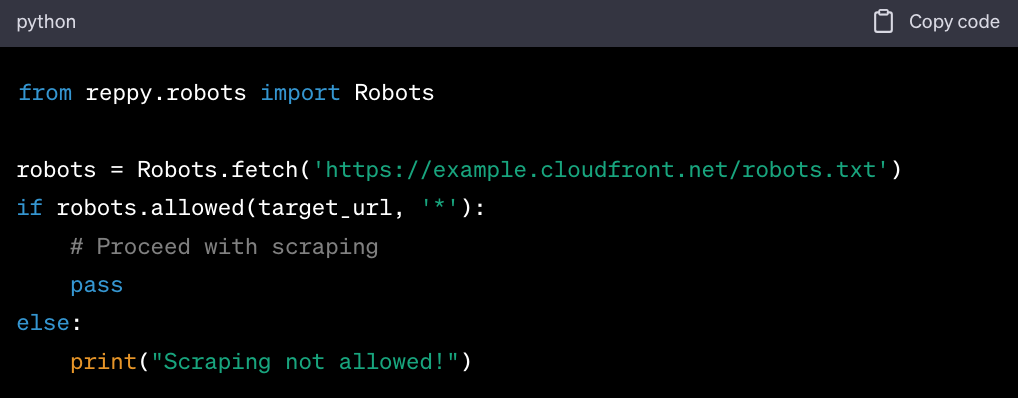
Comprendre le cadre juridique du scraping sur CloudFront.net
Le scraping Web, en particulier sur des plateformes telles que CloudFront.net, nécessite une compréhension approfondie des subtilités juridiques en jeu, telles que
-
Les conditions générales d'utilisation (CGU). Avant de procéder au scraping de CloudFront.net ou de tout autre site, consultez toujours ses CGU.
Consultez systématiquement les Conditions d’utilisation des services AWS avant de lancer toute activité de scraping sur CloudFront.net ou d’autres services AWS. Le non-respect de ces conditions peut entraîner des conséquences juridiques.
-
Lois sur le droit d’auteur. Les données présentes sur CloudFront.net, même si elles sont accessibles au public, peuvent être protégées par le droit d’auteur.
Assurez-vous que les données extraites sont utilisées d’une manière qui ne porte pas atteinte à ces lois.
Photo de Pexels
-
Réglementations en matière de protection des données. Des réglementations telles que le RGPD et le CCPA mettent l’accent sur la vie privée des utilisateurs.
Lorsque vous effectuez du scraping de données à caractère personnel sur CloudFront.net, veillez à respecter ces lois, notamment en matière de stockage sécurisé et d’autorisations nécessaires.
-
Loi sur la fraude et les abus informatiques (CFAA). Cette loi américaine érige en infraction pénale l’accès non autorisé aux systèmes informatiques.
Assurez-vous que vos activités de scraping sur CloudFront.net ne violent pas ses conditions d’utilisation afin d’éviter tout conflit avec la CFAA.
Respecter les limites numériques sur CloudFront.net
Le web scraping éthique consiste à respecter l’espace numérique de plateformes telles que CloudFront.net :
-
Limitation de débit. Évitez de surcharger CloudFront.net en envoyant trop de requêtes en peu de temps.
Respectez les limites de débit et échelonnez vos activités de scraping.
-
Informations sensibles. CloudFront.net peut héberger des données personnelles ou sensibles. Privilégiez la confidentialité des utilisateurs et évitez tout web scraping malveillant.
-
Citer la source. Si vous utilisez des données provenant de CloudFront.net à des fins de recherche ou autres, citez toujours la plateforme comme source.
-
Demandez l’autorisation. En cas de doute concernant le scraping de CloudFront.net, il est préférable de demander l’autorisation aux administrateurs de la plateforme.
Contourner les mesures anti-scraping sur CloudFront.net
CloudFront.net, comme de nombreuses plateformes, peut disposer de mesures visant à dissuader les scrapers :
- User-Agents. CloudFront.net peut bloquer les user-agents connus pour être utilisés par des scrapers. Alternez les user-agents ou imitez un navigateur authentique pour contourner cette restriction.
- CAPTCHA. CloudFront.net peut utiliser des CAPTCHA pour vérifier que les utilisateurs sont bien des humains. Bien qu’il existe des outils pour les contourner, des tentatives fréquentes peuvent entraîner des blocages d’adresse IP.
- Blocages d’adresse IP. Si CloudFront.net détecte une activité inhabituelle, il peut bloquer l’adresse IP. Utilisez des proxys de manière responsable pour alterner les adresses IP et poursuivre le scraping.
- Honeypots. Méfiez-vous des pièges « honeypots » sur CloudFront.net : il s'agit de fausses données mises en place pour détecter les scrapers.
Optimisation des tâches de scraping sur CloudFront.net grâce aux proxys résidentiels d’Geonode
L’intégration des proxys Geonode aux outils et scripts de scraping Web peut considérablement améliorer le processus de scraping, en particulier lorsqu’il s’agit de cibler des plateformes robustes telles que CloudFront.net.

Geonode s’est imposé comme un prestataire de services de proxy de premier plan grâce à sa large gamme de fonctionnalités exceptionnelles.
Reconnu pour son réseau de proxys fiable qui garantit un temps d’indisponibilité minimal et des performances constantes, Geonode bénéficie d’une large couverture, soutenue par un grand nombre d’adresses IP réparties dans plusieurs pays.
De plus, Geonode offre des temps de réponse rapides grâce à son infrastructure robuste, un facteur crucial pour un web scraping efficace. Il fournit des connexions sécurisées et répond à des besoins variés en matière de web scraping, garantissant la confidentialité des données et la protection contre les menaces potentielles.
Questions fréquentes
Comment CloudFront.net améliore-t-il la diffusion de contenu ?
CloudFront.net est un service de réseau de diffusion de contenu (CDN) fourni par Amazon Web Services (AWS).
En termes simples, un CDN s'apparente à un réseau de livreurs rapides répartis à travers le monde, garantissant que le contenu en ligne parvienne aux utilisateurs rapidement et efficacement. Voici comment cela fonctionne :
-
Distribution mondiale. CloudFront dispose de nombreux centres de données, appelés « sites périphériques », répartis dans le monde entier.
Lorsqu'un utilisateur demande du contenu, celui-ci est diffusé depuis le site périphérique le plus proche, ce qui garantit un délai ou une latence minimale.
-
Intégration à AWS. Faisant partie de l’écosystème AWS, CloudFront s’intègre de manière transparente aux autres services AWS.
Si votre site web ou votre application est hébergé(e) sur AWS, l’utilisation de CloudFront peut rendre la diffusion de contenu encore plus efficace.
-
Contenu dynamique et statique. Alors que certains CDN sont particulièrement adaptés à la diffusion de contenu statique (comme des images ou des feuilles de style), CloudFront est capable de diffuser aussi bien du contenu statique que dynamique (comme des pages web spécifiques à un utilisateur).
-
Sécurité. CloudFront offre des fonctionnalités de sécurité robustes, notamment le protocole HTTPS pour un transfert sécurisé des données, une protection contre les attaques DDoS et une intégration avec le pare-feu d’applications web d’AWS.
-
Rentabilité. Grâce à son modèle «pay-as-you-go» (paiement à l’utilisation), les utilisateurs ne paient que pour le contenu qu’ils diffusent, ce qui en fait une solution rentable pour les entreprises de toutes tailles.
En substance, CloudFront.net garantit que votre contenu en ligne parvienne à vos utilisateurs rapidement, en toute sécurité et efficacement, où qu’ils se trouvent dans le monde.
Pourquoi les proxys tels que Geonode sont-ils essentiels pour le web scraping ?
Le web scraping consiste à collecter différents types de données à partir de sites web. Cependant, ce processus n’est pas toujours simple.
Les sites web peuvent disposer de mesures visant à bloquer ou à limiter les accès automatisés. C’est là que les proxys, en particulier ceux qui sont fiables comme Geonode, entrent en jeu :
-
Contourner les restrictions. CloudFront.net, qui fait partie de la suite AWS, dispose de mesures de sécurité robustes.
Les proxys de Geonode peuvent aider à contourner les restrictions basées sur l’adresse IP et à accéder aux données sans déclencher d’alertes.
-
Équilibrage de charge. Lors de l’extraction de grands ensembles de données depuis CloudFront.net, les proxys Geonode peuvent répartir les requêtes, garantissant ainsi un équilibrage de charge efficace et une récupération plus rapide des données.
-
Accès à des données actualisées. CloudFront.net peut servir du contenu mis en cache en fonction de la localisation géographique de la requête.
La large gamme d’adresses IP deGeonode garantit l’accès à des données récentes et en temps réel.
-
Gestion des erreurs. En cas de blocages ou de captchas, les scripts intégrés à Geonode peuvent basculer automatiquement vers un autre proxy, assurant ainsi un scraping ininterrompu.
-
Contournement des limites de débit. CloudFront impose des limites au nombre de requêtes provenant d’une même adresse IP dans un laps de temps donné.
En alternant entre les proxys de Geonode, les scrapers peuvent effectuer des requêtes plus fréquentes sans être bloqués.
-
Fiabilité. Tous les proxys ne se valent pas. Geonode est réputé pour ses proxys stables et haut débit, garantissant un scraping efficace et ininterrompu.
-
Sécurité. L’utilisation des proxys de Geonode assure une connexion sécurisée, protégeant le scraper contre les menaces potentielles et les regards indiscrets.
Pour toute personne qui s’intéresse sérieusement au web scraping, des proxys fiables comme ceux de Geonode ne sont pas seulement utiles ; ils sont indispensables.
Le web scraping est-il légal ?
Aux États-Unis, la légalité du web scraping fait l’objet de débats et a été abordée dans diverses affaires judiciaires.
L’une des affaires les plus citées est hiQ Labs, Inc. c. LinkedIn Corp., dans laquelle la Cour d’appel du neuvième circuit a estimé que le scraping de sites web accessibles au public ne constituait probablement pas une violation de la CFAA.
La cour a statué en faveur de hiQ, une entreprise qui avait procédé au scraping des données publiques de LinkedIn.
La décision de la cour reposait sur l’interprétation selon laquelle la CFAA vise les violations des restrictions d’accès aux systèmes informatiques et non l’utilisation abusive de données par des parties disposant d’un accès autorisé.
Bien que le « web scraping » ne soit pas illégal en soi, il est essentiel de l’aborder de manière responsable.
Respectez toujours les conditions générales d’utilisation d’un site web, tenez compte des lois sur le droit d’auteur et la protection des données, et en cas de doute, demandez conseil à un juriste.
Conclusion
L'interaction entre CloudFront.net, le web scraping et les proxys Geonode offre une vision convaincante de l'efficacité, de l'innovation et de l'acquisition responsable des données.
Grâce à sa portée mondiale, CloudFront.net facilite la diffusion rapide de contenu et favorise une expérience utilisateur fluide.
Le web scraping, quant à lui, permet d’obtenir des informations précieuses qui, lorsqu’il est utilisé de manière éthique, alimente la recherche et l’innovation.
Les proxys Geonode viennent compléter ce processus en permettant une navigation anonyme sur le Web, en contournant les restrictions géographiques et en assurant un flux de données constant.
Mais alors que nous exploitons les capacités combinées de CloudFront.net, du web scraping et des proxys Geonode, il est impératif de donner la priorité aux pratiques éthiques.
Photo de Vecteezy
Le respect des limites numériques, le respect des directives légales et la garantie de la vie privée et des droits des entités en ligne doivent être au cœur de toutes nos initiatives.
Engageons-nous tous à adopter des pratiques éthiques et à rechercher sans cesse le savoir. Le monde numérique est en constante évolution, et en agissant de manière responsable et en restant informés, nous pouvons nous assurer que nos actions profitent non seulement à nous-mêmes, mais aussi à l'ensemble de la communauté en ligne.
.

