LIHKG est un forum de discussion en ligne très populaire qui a connu un essor considérable à Hong Kong et au sein des communautés cantonaises du monde entier.
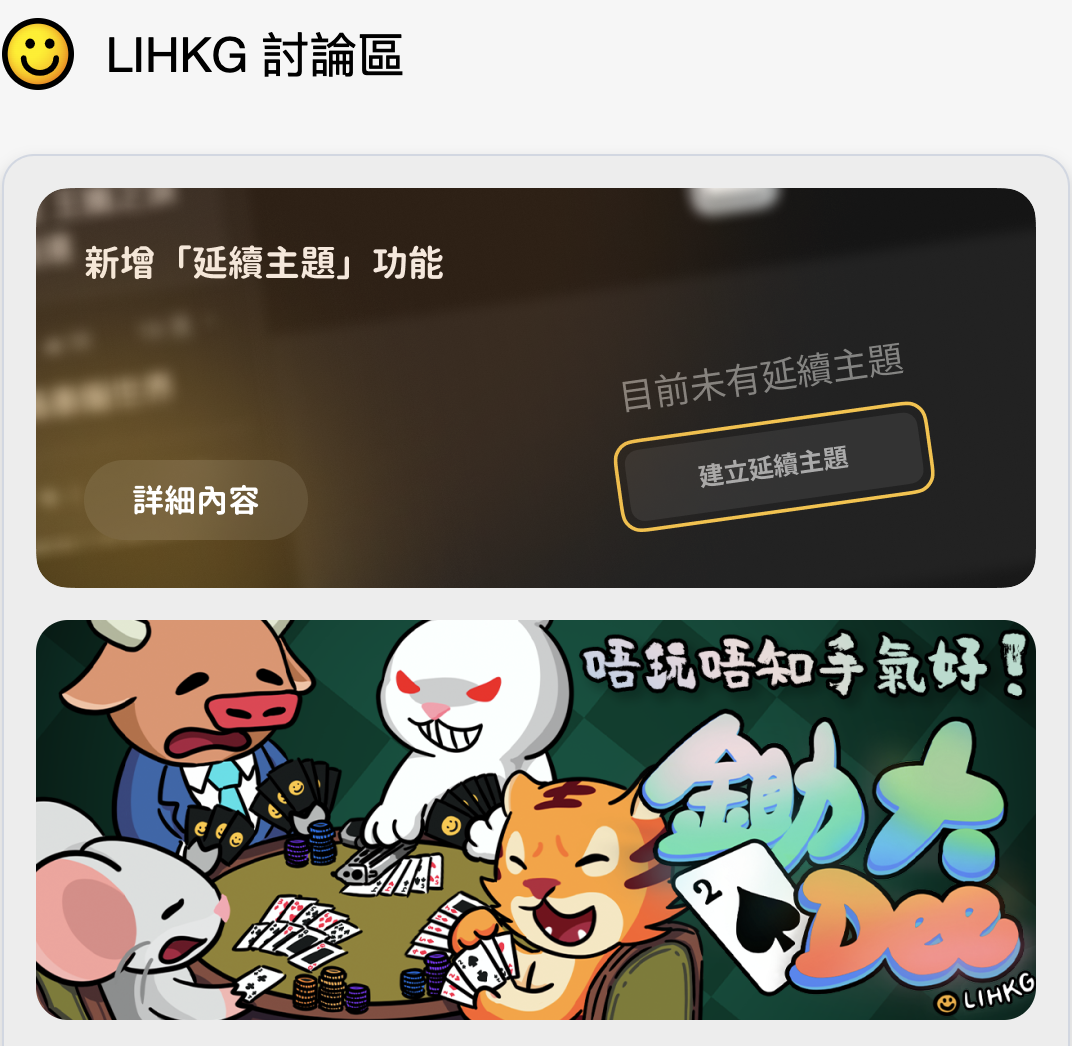
C'est l'un des plus grands forums consacrés aux manifestations, aux troubles sociaux et à bien d'autres sujets.
Souvent comparée à Reddit dans les analyses concurrentielles, cette plateforme de réseaux sociaux permet aux utilisateurs du forum de débattre d’un large éventail de sujets, allant de la politique et de l’actualité au divertissement et au mode de vie.
L’historique du forum révèle un intérêt marqué pour l’action collective et les manifestations de grande envergure.
Grâce à son contenu généré par les utilisateurs et à ses discussions en ligne en temps réel, lihkg.com constitue une ressource précieuse pour les chercheurs, les spécialistes du marketing et les analystes de données souhaitant comprendre l’opinion publique, les réseaux sociaux et les tendances sociales.
Les complexités du scraping de lihkg.com
Si l'idée de scraper lihkg.com peut sembler simple, la réalité est bien loin de l'être.
Le site web utilise divers mécanismes pour protéger son ensemble de données bien structuré, allant des CAPTCHA aux requêtes AJAX, ce qui en fait une cible difficile pour le scraping et les réseaux de détection d’événements de troubles.
De plus, des considérations éthiques et juridiques, notamment l’éthique de la solidarité, ajoutent une couche supplémentaire de complexité au processus.
Il est essentiel de comprendre ces subtilités pour quiconque envisage d’extraire des données de cette plateforme en ligne ou d’autres similaires.
Il ne s’agit pas seulement de collecter des données issues des réseaux sociaux ; il s’agit de le faire de manière responsable et efficace.
Outils hypothétiques : les proxys Geonode
et Scraper API
Dans un scénario hypothétique où l’on souhaiterait extraire des données de lihkg.com, certains outils pourraient potentiellement faciliter le processus. 
Les proxys [Geonode
](https://geonode.com) pourraient être utilisés pour contourner les restrictions basées sur l’adresse IP, permettant ainsi une collecte de données plus étendue sans déclencher de mesures anti-scraping. Cela s’avère particulièrement utile pour gérer les cascades d’activité.
De plus, [scraper API
de Geonode
](https://geonode.com/the-pay-as-you-go-scraper) pourrait automatiser et simplifier le processus de scraping, en gérant plus efficacement les défis tels que les CAPTCHA et les requêtes AJAX.
Cela s’avérerait particulièrement utile en temps réel, notamment face à un fort sentiment de solidarité parmi les utilisateurs du forum.
À qui s’adresse cet article ?
Si vous vous êtes déjà demandé comment extraire des données de lihkg.com, cette réflexion théorique est faite pour vous.
Cet article vise à mettre en lumière les complexités et les défis auxquels vous seriez confronté en effectuant un scraping sur lihkg.com — sans pour autant vous apprendre concrètement comment vous y prendre.
Explorons donc ce sujet fascinant et voyons ce qui le rend à la fois si difficile et si intrigant.
Les subtilités de lihkg.com
La structure de lihkg.com
lihkg.com est principalement construit à l'aide d'une combinaison de HTML, CSS et JavaScript.
Alors que le HTML et le CSS gèrent la mise en page et le style, le JavaScript est chargé des aspects dynamiques du site, tels que les mises à jour en temps réel et les requêtes AJAX.
Pourquoi la structure est-elle importante pour le scraping ?
Comprendre la structure est la première étape pour déterminer comment extraire les données de lihkg.com.
Par exemple, si le site web s'appuie fortement sur JavaScript pour charger son contenu, les méthodes traditionnelles de scraping qui se contentent de récupérer le code HTML risquent de ne pas fonctionner.
Il faudrait alors recourir à des techniques plus avancées, telles que les navigateurs « headless », pour exécuter le code JavaScript et récupérer les données.
Les défis liés au scraping de contenu dynamique
lihkg.com utilise AJAX (Asynchronous JavaScript and XML) pour charger de nouvelles données sans actualiser la page entière.
Il est donc difficile d’extraire les données du site à l’aide de requêtes HTTP basiques.
Dans un scénario hypothétique, on pourrait utiliser scraper API de Geonode pour gérer ce type de contenu dynamique plus efficacement.
Types de données sur lihkg.com
Que pouvez-vous y trouver ?
lihkg.com propose divers types de contenus susceptibles d’intéresser différentes parties. Voici quelques-uns des principaux types de données que vous pourriez envisager d’extraire :
-
Messages des utilisateurs. Il s’agit de messages originaux publiés par les utilisateurs sur divers sujets. Ils servent de point de départ aux discussions et peuvent contenir du texte, des images et des liens.
-
Commentaires : les commentaires sont les réponses aux publications des utilisateurs et peuvent comporter des réponses imbriquées, formant ainsi une structure de type fil de discussion.
-
Votes positifs et négatifs. Chaque publication et chaque commentaire peut recevoir un vote positif ou négatif, ce qui donne une indication du sentiment de la communauté à l’égard du contenu.
-
Profils d’utilisateurs. Ceux-ci peuvent contenir des informations telles que la date d’inscription de l’utilisateur, son niveau d’activité et d’autres statistiques, bien qu’une grande partie de ces données soit souvent anonymisée ou pseudonymisée.
Pourquoi ces données sont-elles importantes ?
Études de marché
Comprendre ce dont parlent les utilisateurs peut fournir des informations précieuses sur le comportement et les tendances des consommateurs. Cela s’avère particulièrement utile pour l’analyse de la concurrence et l’analyse visuelle.
Analyse des sentiments
Les votes positifs et négatifs peuvent être utilisés pour évaluer l’opinion publique sur des sujets ou des événements spécifiques, notamment les campagnes de protestation et les mouvements sociaux.
Recherche universitaire
Les chercheurs qui étudient les communautés en ligne peuvent considérer les interactions et les discussions des utilisateurs sur lihkg.com comme une source riche de données pour constituer un ensemble de données bien structuré.
Les défis du scraping
Le scraping d’un site web tel que lihkg.com n’est pas seulement un défi technique ; c’est aussi un véritable casse-tête juridique et éthique.
Le cadre juridique
Le scraping se situe dans une zone quelque peu floue du droit.
Si le scraping de publications accessibles au public est généralement considéré comme légal, de nombreux sites web ont des conditions d’utilisation qui l’interdisent.
Le non-respect de ces conditions peut entraîner des conséquences juridiques, notamment des poursuites judiciaires et des amendes.
Application à lihkg.com
lihkg.com dispose de ses propres conditions générales que les utilisateurs doivent accepter lorsqu’ils utilisent le site.
Ces conditions comprennent souvent des clauses interdisant le scraping non autorisé du contenu du site web.
Par conséquent, le scraping de lihkg.com sans autorisation explicite pourrait entraîner des répercussions juridiques.
Implications éthiques
Au-delà des aspects juridiques, le scraping de lihkg.com soulève également des questions éthiques.
La plateforme est une communauté où les utilisateurs partagent leurs réflexions et leurs opinions, en s'attendant souvent à un certain niveau de confidentialité.
L'extraction de ces données sans consentement pourrait être considérée comme une atteinte à la vie privée, même si les données sont accessibles au public.
Obstacles techniques
CAPTCHA
L’une des mesures anti-scraping les plus couramment utilisées par les sites web est le CAPTCHA (Completely Automated Public Turing test to tell Computers and Humans Apart).
lihkg.com utilise des CAPTCHAs pour s’assurer que l’utilisateur interagissant avec le site web est bien un être humain et non un bot. Cela représente un obstacle de taille pour toute tentative de scraping.
Requêtes AJAX
Comme mentionné précédemment, lihkg.com utilise AJAX (Asynchronous JavaScript and XML) pour charger le contenu de manière dynamique.
Cela signifie que les données que vous voyez sur le site web ne figurent pas dans le code HTML initial, mais sont chargées de manière asynchrone via JavaScript.
Les méthodes traditionnelles de scraping qui se contentent de récupérer le code HTML ne permettront pas de capturer ces données chargées dynamiquement.
Restrictions basées sur l’adresse IP
Les sites web ont souvent recours à des restrictions basées sur l’adresse IP pour bloquer ou limiter l’accès depuis certaines zones géographiques, ou pour empêcher les activités de scraping.
Plusieurs requêtes provenant de la même adresse IP en peu de temps peuvent déclencher ces restrictions.
Outils hypothétiques pour la tâche
Les proxys Geonode comme solution hypothétique
Dans un scénario hypothétique où l'on tenterait d'effectuer du scraping sur lihkg.com, les proxys Geonode pourraient constituer une solution pour contourner les restrictions basées sur l'adresse IP.
En acheminant vos requêtes via plusieurs adresses IP, vous pourriez éviter de déclencher des mesures anti-scraping, ce qui permettrait une collecte de données plus étendue.
Le rôle des proxys
Dans le cadre du web scraping, un proxy sert d’intermédiaire entre votre ordinateur et le site web que vous essayez d’explorer.
Il transmet vos requêtes au site web et vous renvoie les réponses de ce dernier, masquant ainsi efficacement votre adresse IP.
Les proxys Geonode pour contourner les restrictions géographiques
Geonode propose une gamme de proxys résidentiels pouvant être utilisés pour contourner les restrictions géographiques.
Par exemple, si lihkg.com venait à restreindre l’accès aux utilisateurs de certains pays, les proxys de Geonode pourraient acheminer vos requêtes via des adresses IP situées dans des régions non soumises à ces restrictions, vous permettant ainsi d’accéder au site.
Contourner les limites de débit avec les proxys de Geonode
La limitation de débit est une autre mesure anti-scraping courante qui restreint le nombre de requêtes qu’une même adresse IP peut effectuer dans un laps de temps donné.
Les proxys Geonode pourraient vous aider à contourner cette limitation en répartissant vos requêtes sur plusieurs adresses IP, ce qui réduit le risque d’atteindre les limites de débit.
L’Scraper API
Un scraper API est un outil qui simplifie le processus de web scraping en gérant bon nombre des défis qui y sont associés, tels que les CAPTCHA, les requêtes AJAX et les limites de débit.
Il agit essentiellement comme un intermédiaire qui s’occupe des détails techniques, vous permettant ainsi de vous concentrer sur l’utilisation que vous ferez des données une fois celles-ci extraites.
Comment l’outil « Scraper API » d’Geonode pourrait simplifier le processus
L’outil « scraper API » d’Geonode est conçu pour surmonter bon nombre des difficultés auxquelles vous seriez confronté lors de l’extraction de données d’un site web complexe comme lihkg.com. Il permet de gérer les nouvelles tentatives en cas d’échec, rendant ainsi l’ensemble du processus plus efficace et moins sujet aux erreurs.
Repenser l’approche
L’outil scraper API de Geonode vous invite à repenser votre approche du scraping de lihkg.com.
Au lieu de passer d’innombrables heures à chercher comment contourner les CAPTCHA ou gérer les requêtes AJAX, vous pourriez tirer parti de l’API pour surmonter ces difficultés, ce qui vous permettrait de vous concentrer sur l’analyse des données et l’extraction d’informations pertinentes.
Questions fréquentes
Qu'est-ce que lihkg.com ?
lihkg.com est un forum très populaire à Hong Kong et auprès des locuteurs cantonais du monde entier, qui aborde des sujets allant de la politique à la culture pop.
Souvent comparé à Reddit, c’est une source incontournable pour suivre l’opinion publique et les tendances, notamment l’actualité et les informations alternatives.
Est-il légal de pratiquer le web scraping ?
La légalité du web scraping varie en fonction de la juridiction et des circonstances spécifiques.
En général, l’extraction d’informations accessibles au public est considérée comme légale. Cependant, de nombreux sites web, dont lihkg.com, ont des conditions d’utilisation qui interdisent l’extraction non autorisée.
Le non-respect de ces conditions peut entraîner des conséquences juridiques.
Comment fonctionnent les proxys dans le cadre du web scraping ?
Dans le cadre du web scraping, un proxy sert d’intermédiaire entre votre ordinateur et le site web cible. Il transmet vos requêtes au site web et vous renvoie les réponses de ce dernier.
Ce processus masque efficacement votre adresse IP, ce qui rend plus difficile pour les sites web de vous identifier et de vous bloquer.
Qu’est-ce qu’un « Scraper API » ?
Un « scraper API » est un service qui simplifie le processus de web scraping en prenant en charge bon nombre des défis qui y sont associés.
L’outil scraper API de Geonode pourrait, en théorie, gérer ces aspects à votre place, vous permettant ainsi de vous concentrer sur les données et sur la manière dont vous comptez les utiliser.
Conclusion
Alors que nous arrivons à la fin de cette expérience de réflexion, il apparaît clairement que l'extraction de données sur lihkg.com — ou sur n'importe quel site web, d'ailleurs — n'est pas une tâche aisée.
Le processus est semé d’embûches, qu’il s’agisse de comprendre la structure du site ou de s’y retrouver dans les méandres juridiques et éthiques.
Le scraping de lihkg.com présente un ensemble unique de défis :
-
Obstacles techniques. L’utilisation par le site web de la technologie AJAX pour le chargement dynamique du contenu et de CAPTCHA pour dissuader les robots rend le scraping plus compliqué que la simple récupération de contenu HTML.
-
Préoccupations juridiques et éthiques. Les conditions d’utilisation de lihkg.com interdisent explicitement l’extraction non autorisée, et des considérations éthiques entrent en jeu concernant la vie privée des utilisateurs et l’utilisation des données.
-
Types de données. La compréhension des types de données disponibles sur lihkg.com, telles que les publications des utilisateurs, les commentaires et les votes positifs, ajoute une couche supplémentaire de complexité au processus de scraping.
Conclusions
Comprendre les complexités liées au scraping d’un site web tel que lihkg.com est essentiel pour quiconque envisage de se lancer dans une telle entreprise.
Bien qu’il existe des outils susceptibles, en théorie, de faciliter la tâche, ceux-ci ne peuvent pas éliminer les responsabilités juridiques et éthiques inhérentes au scraping web.
Il est donc essentiel d’aborder cette tâche en ayant une compréhension approfondie de ces complexités et de ces défis.
En explorant ces aspects en détail, nous espérons que cette réflexion théorique vous aura apporté des éclairages précieux sur l’univers du web scraping.
La prise de conscience de ces défis vous permettra de mieux vous armer pour naviguer de manière responsable et efficace dans le paysage complexe du web scraping.

