Souvent qualifié de « une première page d'Internet », Reddit est une plateforme gigantesque dédiée au contenu généré par les utilisateurs.
Avec 430 millions d'utilisateurs actifs par mois participant à des milliers de discussions thématiques, allant des dernières tendances technologiques aux loisirs de niche, Reddit est un outil précieux et une mine d'or de données prêtes à être exploitées.
Mais comment extraire ces données de manière efficace et éthique ?
Dans ce guide, nous nous penchons sur les scrapers Reddit, l’API officielle, les outils, les techniques et les bonnes pratiques permettant de collecter efficacement les données de Reddit.
L'importance du scraping sur Reddit
Les analyses fondées sur les données sont la clé du succès.
L'extraction de données sur Reddit permet aux entreprises, aux chercheurs et aux passionnés de données de comprendre l'opinion publique, de suivre les tendances du marché et de collecter du contenu généré par les utilisateurs.
Ces données riches et non structurées offrent de nombreux cas d’utilisation, tels que :
-
Études de marché. Les communautés variées de Reddit, appelées « subreddits », couvrent pratiquement tous les centres d’intérêt imaginables. Les entreprises extraient les publications de Reddit pour évaluer en temps réel les sentiments des consommateurs, leurs préférences et les tendances émergentes.
-
Avis sur les produits. Les utilisateurs discutent fréquemment de produits et de services, en donnant des avis francs. Ces données inestimables aident les entreprises à affiner leurs offres et à répondre aux préoccupations.
-
Analyse concurrentielle. En surveillant les discussions concernant leurs concurrents, les entreprises peuvent identifier les forces, les faiblesses et les opportunités sur le marché.
-
Idées de contenu. Les créateurs de contenu et les spécialistes du marketing utilisent Reddit pour découvrir les publications les plus populaires et les sujets tendance, s’assurant ainsi que leur contenu reste pertinent et captivant.
-
Recherche universitaire. Les chercheurs exploitent le vaste réservoir de données de Reddit pour étudier les comportements en ligne, les tendances culturelles et les dynamiques sociales.
-
Gestion de crise. Les marques peuvent détecter précocement des crises de relations publiques potentielles en surveillant les sentiments négatifs ou les polémiques sur Reddit.
-
Ensembles de données d’entraînement. Pour les professionnels de l’IA et de l’apprentissage automatique, Reddit fournit de vastes ensembles de données pour l’entraînement des modèles, notamment dans le domaine du traitement du langage naturel.
Comprendre la structure de Reddit pour un web scraping efficace
Reddit est une plateforme complexe dotée d’une structure unique qui la distingue des autres réseaux sociaux.
Il est essentiel de bien comprendre cette structure pour quiconque souhaite extraire des données de Reddit, car cela garantit l’obtention d’informations pertinentes et exhaustives.
Voici une analyse approfondie :
-
Les subreddits. Il s’agit de sections centrées sur la communauté et consacrées à des sujets ou des centres d’intérêt spécifiques.
Chaque subreddit possède son URL unique, souvent notée sous la forme « r/[nom_du_subreddit] ».
Par exemple, il existe des « subreddits de bonnes affaires » consacrés aux promotions et aux réductions.
Connaître la structure des URL des subreddits est essentiel pour cibler des communautés spécifiques.
-
Messages. Les utilisateurs peuvent publier des messages au sein des subreddits. Ces messages peuvent aller d’articles de blog approfondis à des images, des vidéos ou des liens vers des sites externes.
Chaque message possède une structure unique, souvent appelée « dictionnaire de message », qui comprend des détails tels que l’auteur du message, son titre et son contenu actuel.
-
Commentaires. Chaque publication peut faire l’objet de commentaires, ce qui donne lieu à des discussions imbriquées.
Comprendre le nombre moyen de commentaires par publication ou cibler les publications suscitant de nombreux commentaires peut fournir des données plus riches pour l’analyse.
-
Profils d’utilisateurs et utilisateurs de l’application. Chaque utilisateur de Reddit, qu’il utilise l’application Reddit ou un navigateur, dispose d’un profil qui affiche son activité, notamment ses publications et ses commentaires.
Il s’agit d’une mine d’or de données, en particulier pour analyser le comportement des utilisateurs.
-
Produits numériques et achats via l’application. Reddit propose diverses options de distribution de produits numériques, notamment des récompenses et Reddit Premium.
Comprendre comment les utilisateurs interagissent avec ces produits, en particulier via les achats effectués dans l’application, peut fournir des informations sur leur comportement d’achat.
-
Publicité sur l’application. Reddit propose des opportunités publicitaires permettant aux marques de cibler des segments démographiques spécifiques ou des communautés de subreddits.
Il s’agit d’un outil essentiel pour les entreprises souhaitant faire de la publicité sur la plateforme.
-
Interactions avec le navigateur. Que les utilisateurs accèdent à Reddit via une session de navigateur ou utilisent des extensions de navigateur, chaque interaction génère des données.
Savoir comment extraire les interactions et les profils de navigateur peut fournir des informations plus approfondies sur le comportement des utilisateurs.
-
Cloud et déploiement. Reddit utilise des solutions de services cloud, et il peut être crucial de bien comprendre ce fonctionnement, notamment lorsqu’on envisage le cloud lors du déploiement.
-
Analyse et outils. Grâce à des outils d’analyse adaptés, les entreprises peuvent déterminer comment un sujet est abordé au sein de dizaines de communautés ou comment les utilisateurs interagissent avec le bouton « upvote » ou l’élément « upvote ».
-
Automatisation et IA. Les outils modernes de scraping des réseaux sociaux sont dotés de fonctionnalités d’automatisation. Certains utilisent même des outils d’IA générative pour prédire le comportement des utilisateurs ou générer du contenu.
-
Considérations éthiques. Lors du scraping, il est essentiel de respecter les propriétaires respectifs du contenu et de veiller à utiliser des agents utilisateurs descriptifs pour éviter toute fausse représentation.
Visez toujours l’URL cible correcte pour extraire les informations dont vous avez besoin sans porter atteinte aux droits des utilisateurs.
- Éléments supplémentaires. Reddit est un univers vaste, et d’autres éléments tels que le dictionnaire des subreddits, les champs de description et bien d’autres encore peuvent être ciblés pour obtenir des données plus détaillées.
La structure multiforme de Reddit est un véritable terrain de jeu pour les scrapers web. Pour extraire des données pertinentes, il faut en comprendre les subtilités.
Que vous analysiez les commentaires des subreddits, étudiez des lignes de code à la recherche de modèles ou exploriez la manière dont les produits sont commercialisés, la connaissance de la structure de Reddit garantit que vos efforts de scraping sont à la fois efficaces et éthiques.
Outil de scraping n° 1 : l'API officielle de Reddit
Certaines personnes considèrent Reddit comme une simple plateforme de réseaux sociaux parmi tant d'autres. Cependant, sa structure unique et son système de vote démocratique en font bien plus que cela.
Reddit se nourrit de contenus générés par les utilisateurs, regroupés au sein de communautés de niche appelées « subreddits ».
Chaque subreddit traite d’un sujet spécifique, permettant aux utilisateurs de participer à des discussions, de partager des ressources et de demander des conseils.
Les contenus les plus plébiscités — c'est-à-dire les publications les plus populaires — remontent en tête de liste, faisant de Reddit un reflet en temps réel de l'intérêt et de l'opinion publics.
Présentation et conditions d'utilisation de l'API Reddit
L'API DATA officielle de Reddit est un outil puissant qui offre un accès structuré au vaste contenu de la plateforme.
Il s’agit d’un outil indispensable pour les développeurs, les chercheurs et les entreprises qui souhaitent exploiter les nombreuses informations disponibles sur la plateforme.
L’API permet aux développeurs tiers de lire les commentaires, de récupérer des informations sur les utilisateurs, d’accéder aux détails des subreddits et bien plus encore, de manière à la fois efficace et conforme aux directives de Reddit.
Directives d’utilisation, limites et restrictions
- Inscription et éligibilité. Avant d’accéder à l’API de données, les utilisateurs doivent s’inscrire et s’assurer qu’ils remplissent les critères d’éligibilité. Cela implique notamment d’avoir l’âge légal et de ne pas faire l’objet d’une interdiction d’utilisation de l’API en vertu de toute loi applicable.
- Licence. Reddit accorde une licence non exclusive, non transférable et révocable pour accéder à l’API de données et l’utiliser. Cela signifie que les utilisateurs ne peuvent pas concéder de sous-licence ni transférer leurs droits d’accès à l’API à un tiers.
- Contenu des utilisateurs. Bien que le contenu de Reddit soit généré par les utilisateurs, l’API permet d’accéder à ce contenu sans le modifier. Toute utilisation du contenu des utilisateurs doit respecter les droits des créateurs de contenu d’origine.
- Confidentialité et traitement des données. Les développeurs doivent indiquer comment ils traitent les données collectées via l’API, en garantissant la transparence et le respect des lois sur la protection de la vie privée.
- Limites de l’API. Reddit peut imposer des limites d’utilisation de l’API, telles que le nombre de requêtes par heure. Il est essentiel de connaître et de respecter ces limites afin d’éviter toute perturbation.
- Frais et utilisation commerciale. Bien que l’API soit généralement gratuite pour une utilisation de base, Reddit se réserve le droit de facturer les niveaux d’utilisation plus élevés ou les utilisations à des fins commerciales.
- Conformité. Les utilisateurs de l’API doivent se conformer aux Conditions d’utilisation, à la Politique de confidentialité et à toute autre condition applicable de Reddit. Cela garantit que l’accès aux données reste éthique et conforme aux normes communautaires de Reddit.
Il est essentiel de comprendre et de respecter ces conditions pour toute personne souhaitant utiliser les données de Reddit dans ses applications ou ses recherches. Cela garantit un accès aux données fluide et ininterrompu, tout en préservant l’intégrité et l’éthique de la communauté Reddit.
Outil de scraping n° 2 : Python et Selenium
Python est un langage de programmation très répandu, réputé pour sa simplicité et sa polyvalence.
Python propose une multitude de bibliothèques et de frameworks qui facilitent le scraping. L'un de ces outils est Selenium, initialement conçu pour les tests web, mais qui est depuis devenu un incontournable pour les tâches de scraping.
Selenium fonctionne en automatisant les navigateurs web. Il peut simuler un comportement de navigation similaire à celui d’un utilisateur humain, ce qui permet d’extraire des données de pages web comme si un véritable utilisateur les parcourait.
Associé à Python, Selenium permet aux développeurs d’écrire des scripts capables d’effectuer des tâches telles que se connecter à des comptes, accéder à des pages spécifiques, cliquer sur des boutons et, surtout, extraire des données.
Pour des plateformes comme Reddit, riches en contenu dynamique (contenu chargé ou modifié sans que la page ne soit actualisée), Selenium s’avère inestimable.
Les outils de scraping traditionnels peuvent rencontrer des difficultés avec ce type de contenu, mais Selenium, en tant qu’outil d’automatisation de navigateur, y accède facilement.
Avantages de l’utilisation de Python et de Selenium pour le scraping de Reddit
- Accès au contenu dynamique. Comme mentionné précédemment, Selenium peut interagir avec le contenu dynamique, garantissant ainsi qu’aucune donnée n’est omise pendant le processus de scraping.
- Interactions similaires à celles d’un humain. La capacité de Selenium à imiter les interactions humaines, comme le défilement ou les clics, permet de contourner certaines mesures anti-scraping.
- Flexibilité. Les bibliothèques très complètes de Python et les capacités d’automatisation des navigateurs de Selenium forment une combinaison flexible. Qu'il s'agisse de gérer les cookies, les sessions ou les fenêtres contextuelles, Python et Selenium peuvent tout prendre en charge.
- Prise en charge étendue des navigateurs. Selenium prend en charge plusieurs navigateurs, notamment Chrome, Firefox et Safari, ce qui permet un scraping multi-navigateurs si nécessaire.
Défis potentiels
- Performances. Comme Selenium automatise un véritable navigateur, il peut s’avérer plus lent que d’autres outils de scraping légers qui récupèrent directement le code source des pages.
- Complexité. La mise en place d’un scraper basé sur Selenium peut s’avérer plus complexe que l’utilisation d’outils simples basés sur des requêtes HTTP, en particulier pour les débutants.
- Mesures anti-scraping. Bien que Selenium puisse contourner certaines techniques anti-scraping, des plateformes comme Reddit font évoluer en permanence leurs défenses. Cela signifie que les scrapers pourraient se heurter à des obstacles tels que les CAPTCHA, les limitations de débit ou les blocages temporaires d’adresses IP.
- Maintenance. Les pages Web évoluent au fil du temps. Si Reddit procède à une refonte de son design ou modifie sa structure, le scraper risque de ne plus fonctionner et de nécessiter des mises à jour.
Outil de scraping n° 3 : PRAW (Python Reddit API Wrapper)
PRAW, acronyme de Python Reddit API Wrapper, est essentiellement une passerelle entre les applications Python et l'API de Reddit.
Au lieu de gérer des requêtes HTTP brutes et d'analyser des réponses JSON complexes, les développeurs peuvent utiliser les méthodes intuitives de PRAW pour récupérer des données Reddit et interagir avec celles-ci.
Avantages de l’utilisation de PRAW
-
Simplicité. PRAW masque les complexités de l’API Reddit, offrant aux développeurs des méthodes simples pour accéder aux données.
Par exemple, récupérer les messages les plus populaires d’un subreddit ou les commentaires d’un fil de discussion spécifique ne nécessite que quelques lignes de code.
-
Gestion des limites de débit. Reddit impose des restrictions quant à la fréquence d’accès à son API.
PRAW gère automatiquement ces limites de débit, garantissant ainsi que votre application ne les dépasse pas et ne s’expose pas à des suspensions temporaires.
-
Conformité. En utilisant PRAW, les développeurs respectent d’emblée les conditions d’utilisation de l’API de Reddit, ce qui minimise le risque de problèmes d’accès aux données.
-
Documentation complète. PRAW est fourni avec une documentation exhaustive, ce qui facilite la prise en main et le dépannage tant pour les débutants que pour les développeurs expérimentés.
-
Communauté active. PRAW bénéficie d’une communauté active. Cela se traduit par des mises à jour régulières, une multitude de ressources en ligne et un soutien communautaire pour surmonter tout défi rencontré.
Configuration de base et exemples d’utilisation
Configuration
-
Avant d’utiliser PRAW, enregistrez une application de script sur le portail des développeurs de Reddit afin d’obtenir les identifiants API nécessaires.
-
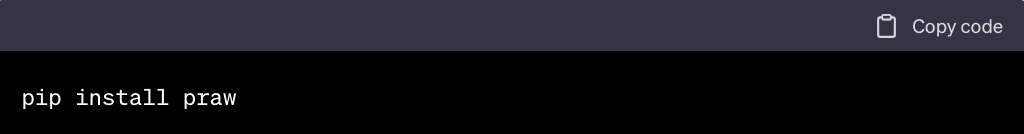
Installez PRAW via pip.
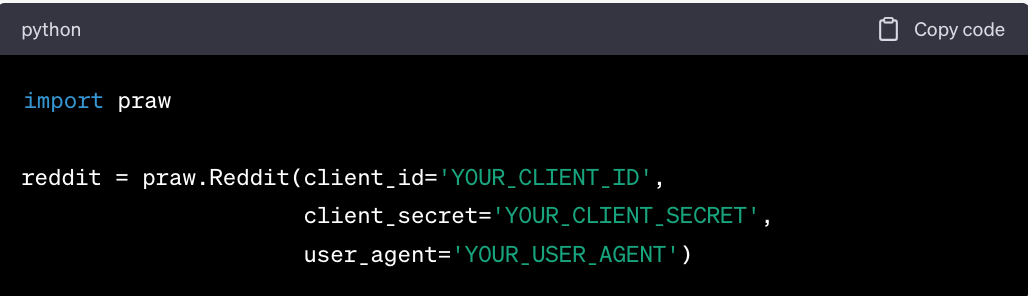
- Initialisez l’instance Reddit avec vos identifiants API.
Exemples d’utilisation
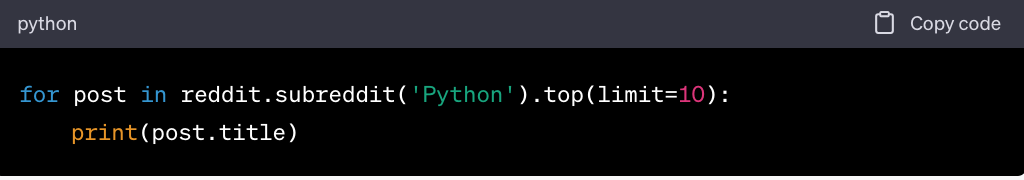
- Extraire les 10 meilleurs messages d’un subreddit
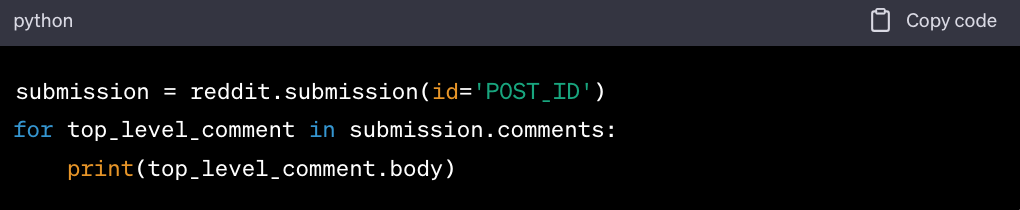
- Récupérer les commentaires d’un fil de discussion spécifique
- Recherche de messages contenant un mot-clé
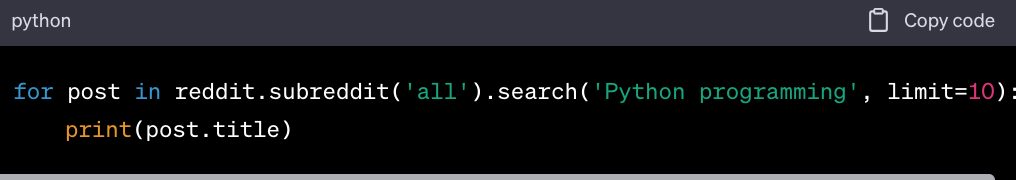
PRAW est un outil incontournable pour tous ceux qui souhaitent explorer les données de Reddit à l’aide de Python. Sa simplicité, alliée à sa puissance, en fait un choix idéal pour des projets allant de simples tâches d’extraction de données à des initiatives complexes d’analyse de données.
Outil de scraping n° 4 : le framework Scrapy
Scrapy est un framework open source de haut niveau, écrit en Python, dédié à l'exploration et au scraping du Web. Il est conçu pour prendre en charge un large éventail de tâches de scraping, allant de simples extractions ponctuelles de données à des projets complexes de crawling Web à grande échelle. Scrapy ne se limite pas à Reddit, mais peut être utilisé pour extraire des données de n'importe quel site Web.
Principales fonctionnalités
-
Polyvalence. Scrapy peut extraire des données de sites web à l’aide de sélecteurs CSS, de XPath ou même d’expressions régulières, s’adaptant ainsi à diverses structures de sites web.
-
Middlewares et extensions. Scrapy prend en charge les middlewares et les extensions, ce qui permet aux développeurs de personnaliser le processus de scraping, de gérer les tentatives de connexion, les agents utilisateurs et même d’intégrer des pools de proxys.
-
Pipeline. Une fois les données extraites, Scrapy propose des pipelines d’éléments pour traiter, valider et stocker les données. Cela peut se faire dans des bases de données, des fichiers ou même sur un espace de stockage cloud.
-
Exploration simultanée. Scrapy s’appuie sur la bibliothèque réseau asynchrone Twisted, ce qui lui permet de traiter plusieurs requêtes simultanément et d’accélérer ainsi le processus d’extraction des données.
-
Gestion robuste des erreurs. Scrapy gère les erreurs avec souplesse, garantissant qu’un incident mineur n’interrompt pas l’ensemble du processus de scraping.
-
Exportateurs intégrés. Scrapy peut exporter les résultats dans plusieurs formats, tels que JSON, CSV et XML, sans nécessiter de plugins ou d’outils supplémentaires.
Comment configurer et utiliser Scrapy pour l’extraction de données sur Reddit
Configuration de Scrapy : tutoriel étape par étape
-
Installez Scrapy à l’aide de pip 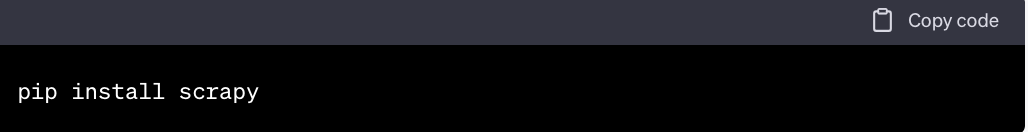
-
Lancez un nouveau projet Scrapy 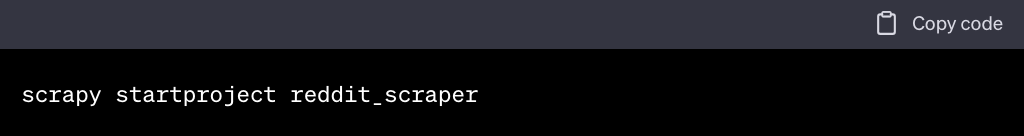
Utilisation de Scrapy pour l’extraction de données sur Reddit
-
Créez un spider. Au sein de votre projet Scrapy, vous allez créer des spiders, qui sont des classes définissant comment suivre les liens et extraire les données. Pour Reddit, vous pourriez créer un spider comme celui-ci : 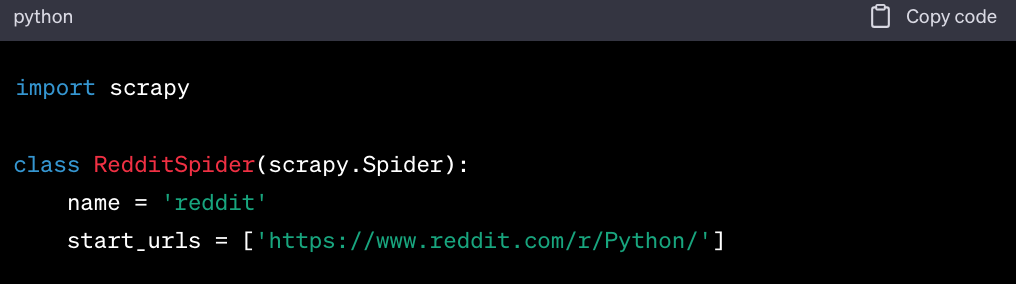
-
Définissez la logique d’extraction. Utilisez des sélecteurs CSS ou XPath pour extraire les données de la page Reddit. 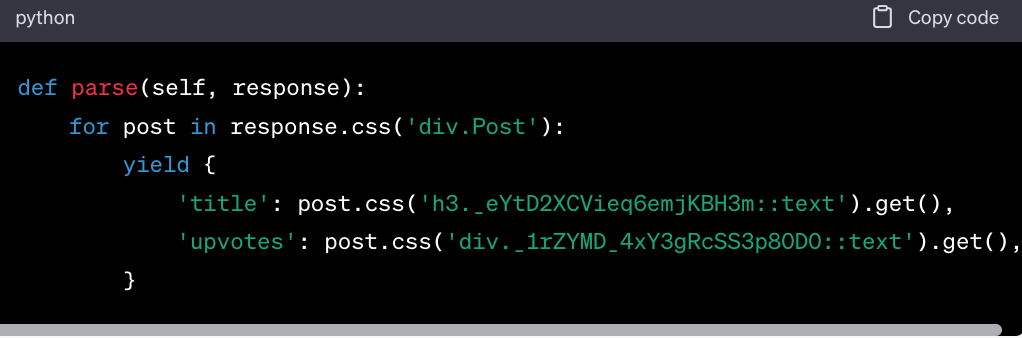
-
Suivre la pagination. Reddit comporte plusieurs pages de contenu. Scrapy peut être configuré pour suivre les liens et extraire les données sur différentes pages. 
-
Lancer le spider : Une fois votre spider configuré, accédez au répertoire du projet et exécutez : 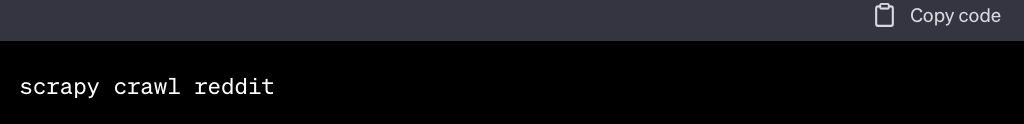
-
Stockage des données : Scrapy peut stocker les données extraites dans divers formats. Par exemple, pour stocker les données dans un fichier JSON : 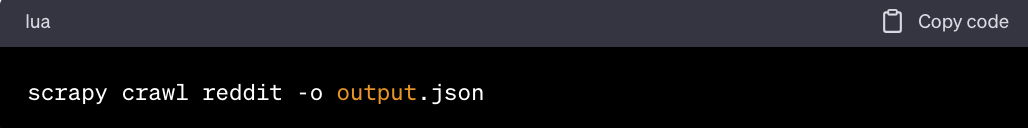
Outil de scraping n° 5 : les dépôts GitHub
GitHub, la première plateforme mondiale de développement logiciel, héberge une multitude de dépôts dédiés à diverses tâches, notamment le web scraping.
Parmi ceux-ci, de nombreux dépôts se concentrent spécifiquement sur l’extraction de données de Reddit.
Ces dépôts fournissent souvent des outils, des scripts ou des bibliothèques prêts à l’emploi qui peuvent simplifier le processus d’extraction de données de Reddit et le rendre accessible même à ceux qui ont une expérience limitée en programmation.
Avantages de l’utilisation des dépôts GitHub pour l’extraction de données de Reddit
-
Solutions prêtes à l’emploi. De nombreux dépôts GitHub proposent des solutions complètes ne nécessitant qu’une configuration minimale. Les utilisateurs peuvent cloner le dépôt, suivre les instructions fournies et commencer le scraping sans avoir à créer un outil à partir de zéro.
-
Soutien de la communauté. Les dépôts populaires disposent souvent de communautés actives. Les utilisateurs peuvent signaler des problèmes, demander de l’aide ou même contribuer au projet, améliorant ainsi les capacités de l’outil.
-
Mises à jour continues. Compte tenu de la nature dynamique des sites web, les outils de scraping nécessitent des mises à jour régulières. Les dépôts GitHub actifs sont fréquemment mis à jour pour s’adapter aux changements dans la structure du site web cible ou pour améliorer les fonctionnalités.
-
Diversité des approches. Différents dépôts peuvent recourir à diverses techniques ou outils de scraping, allant de solutions basées sur Python comme PRAW ou Scrapy à Node.js, voire à des applications Dockerisées. Cette diversité permet aux utilisateurs de choisir un outil qui correspond à leur expertise technique et aux exigences de leur projet.
-
Documentation et exemples. La plupart des dépôts réputés fournissent une documentation complète, des guides d’installation et des exemples d’utilisation, garantissant ainsi aux utilisateurs une mise en route sans difficulté.
Explorer GitHub à la recherche de scrapers Reddit
Une simple recherche sur GitHub avec le terme « reddit-scraper » révèle toute une gamme de référentiels spécialement conçus pour l’extraction de données Reddit.
Voici quelques dépôts potentiels que vous pourriez trouver :
-
Bots de scraping Reddit. Il s’agit de scripts automatisés capables de récupérer des publications, des commentaires et bien plus encore à partir de subreddits ou de fils de discussion spécifiques.
-
Wrappers de l’API Reddit. Bien que PRAW soit le plus populaire, d’autres wrappers peuvent offrir des fonctionnalités uniques ou prendre en charge différents langages de programmation.
-
Scrapers Reddit sur Docker. Pour ceux qui recherchent des solutions conteneurisées, certains dépôts proposent des configurations Docker afin de garantir des opérations de scraping cohérentes et évolutives.
-
Outils spécialisés. Certains outils de crawling Reddit peuvent se concentrer sur des tâches spécifiques, comme le téléchargement de toutes les images d’un subreddit, l’extraction des sujets tendance ou la surveillance de mots-clés spécifiques.
Étapes à suivre pour utiliser un dépôt GitHub destiné au scraping de Reddit
-
Choisissez un dépôt. Rendez-vous sur la page dédiée aux scrapers Reddit sur GitHub et sélectionnez un dépôt qui correspond à vos besoins.
-
Clonez et installez. Suivez les instructions du dépôt, qui consistent généralement à cloner le dépôt et à installer les dépendances requises.
-
Configurez. De nombreux outils nécessitent une certaine configuration, comme la spécification du sous-forum cible, la configuration des clés API ou la définition des formats de sortie.
-
Exécution et extraction des données. Exécutez les scripts ou commandes fournis pour lancer le processus de scraping.
-
Post-traitement. Selon l’outil, vous devrez peut-être traiter davantage les données extraites, par exemple en les filtrant, en les nettoyant ou en les convertissant au format souhaité.
Outil de scraping n° 6 : les outils de scraping Reddit tiers
L'ampleur et la richesse des données disponibles sur Reddit ont conduit à l'émergence de plusieurs outils de scraping tiers. Ces outils visent à simplifier le processus de scraping, le rendant ainsi accessible à un public plus large, allant des entreprises aux chercheurs. Découvrons ensemble certains des outils de scraping Reddit tiers les plus populaires :
- Modèle tarifaire : propose un modèle d’pay-as-you-gos flexible.
- Expérience utilisateur : interface intuitive adaptée aussi bien aux débutants qu’aux experts.
- Performances : extraction de données rapide et fiable.
- Confidentialité : Met l’accent sur la confidentialité des utilisateurs, en garantissant l’intégrité et la sécurité des données.
- Automatisation : Intègre une automatisation basée sur l’IA pour un scraping adaptatif.
- Transformation des données : Outils intégrés pour affiner et analyser les données extraites.
- Polyvalence : Solution complète de scraping ciblant plusieurs sites web.
- Interface : Interface visuelle facilitant la conception de projets.
- Fonctionnalités avancées : Prise en charge d’AJAX et de JavaScript pour une extraction exhaustive des données.
- Planification : Offre des fonctionnalités permettant de configurer des tâches de scraping récurrentes.
- Déploiement : Propose à la fois des options d’extraction dans le cloud et en local.
- Convivialité : Configuration simple avec des fonctionnalités permettant de gérer les CAPTCHA et les blocages d’adresses IP.
- Intégration : Intègre une API pour un transfert de données fluide.
- Simplicité : Se concentre sur la fourniture de modules prêts à l'emploi pour faciliter le scraping.
- Prix abordable : Met l'accent sur des solutions économiques adaptées à différents budgets.
- Service principal : Reconnu comme un fournisseur de proxys spécialisé dans le scraping.
- Anonymat : Propose des adresses IP tournantes et un vaste pool de proxys résidentiels pour un scraping anonyme.
- Accompagnement : Fournit des guides détaillés sur le scraping web, notamment sur Reddit.
- Approche basée sur une API : propose une API simple pour une intégration aisée dans les systèmes existants.
- Évolutivité : conçu pour gérer des tâches de scraping à grande échelle sans compromettre la vitesse.
- Anonymat : utilise un système de proxys rotatifs pour garantir un scraping anonyme et ininterrompu.
- Polyvalence : prend en charge plusieurs plateformes, Reddit étant l’une de ses spécialités.
Si chaque outil de scraping tiers apporte ses propres atouts, l’approche centrée sur l’utilisateur et la tarification flexible d’Geonode en font une option de choix.
Cependant, le meilleur outil dépend souvent des besoins individuels, de l’expertise technique et du budget.
Bonnes pratiques et considérations éthiques
Le scraping de Reddit, bien qu'il s'agisse d'un outil puissant pour l'extraction de données, s'accompagne d'un certain nombre de responsabilités.
Le respect des pratiques éthiques permet non seulement de protéger les droits des utilisateurs, mais aussi d’assurer la pérennité et la réputation de vos activités de scraping.
Voici une analyse approfondie des meilleures pratiques et des considérations éthiques à respecter lors du scraping de Reddit :
Respecter la vie privée des utilisateurs
L’ère numérique a suscité des préoccupations accrues concernant la vie privée des utilisateurs. Lors du scraping de Reddit, il est essentiel de donner la priorité à la vie privée des utilisateurs de la plateforme.
-
Scraping éthique. Assurez-vous toujours que les données que vous extrayez sont accessibles au public. Évitez de récupérer des informations personnelles ou du contenu provenant de subreddits privés. N’oubliez pas que ce n’est pas parce que des données sont accessibles qu’il est éthique de les extraire.
-
Anonymat. Bien que les utilisateurs de Reddit utilisent des pseudonymes, il est essentiel de traiter ces données avec précaution. Évitez toute action susceptible de lever l’anonymat des utilisateurs ou de révéler leur identité réelle.
-
Protection des données. Si vous stockez des données extraites, assurez-vous qu’elles soient chiffrées et conservées en toute sécurité. Mettez en place des mesures de cybersécurité robustes pour empêcher tout accès non autorisé.
-
Transparence. Si vous utilisez des données extraites à des fins de recherche ou commerciales, faites preuve de transparence quant à vos sources de données et à la manière dont celles-ci seront utilisées.
Gestion des limites de débit et des restrictions
Reddit, comme de nombreuses plateformes, applique des limites de débit afin de garantir la stabilité de ses serveurs et d’empêcher toute utilisation abusive.
-
Comprenez les limites de l’API. Si vous utilisez l’API de Reddit, familiarisez-vous avec ses limites de débit. En général, celles-ci sont fixées à un certain nombre de requêtes par minute. Le dépassement de ces limites peut entraîner des suspensions temporaires ou définitives.
-
Prévoyez des délais. Intégrez des délais entre les requêtes de scraping. Cela permet non seulement de respecter les serveurs de la plateforme, mais aussi de réduire les risques que votre scraper soit identifié et bloqué.
-
Alternez les adresses IP et les user-agents grâce à un fournisseur de services proxy fiable. L'utilisation des proxys résidentiels d'Geonode peut vous aider à contourner les restrictions en mettant à votre disposition un pool d'adresses IP tournantes, ce qui rend vos activités de scraping plus naturelles. Associée à la rotation des user-agents, cette stratégie peut réduire considérablement le risque d'être bloqué. Cependant, veillez à toujours utiliser cette stratégie de manière éthique et évitez tout scraping agressif susceptible de perturber la plateforme.
-
Respectez le fichier robots.txt de Reddit. Le fichier robots.txt fournit des directives sur ce qui peut et ne peut pas être scrapé. Vérifiez toujours les règles de Reddit et respectez-les.
Stockage et utilisation des données
La responsabilité ne s’arrête pas après le scraping des données. La manière dont vous stockez et utilisez ces données est également cruciale.
-
Stockage sécurisé. Assurez-vous que toutes les données stockées sont conservées dans des bases de données chiffrées. Sauvegardez régulièrement ces données et mettez en place des mesures de sécurité pour prévenir les violations.
-
Minimisation des données. Ne stockez que les données nécessaires à votre objectif. Évitez d’accumuler des quantités excessives d’informations, en particulier si elles sont sensibles ou personnelles.
-
Utilisation éthique. Si vous publiez ou partagez des données extraites, assurez-vous qu’elles ne nuisent pas à la communauté Reddit et ne la présentent pas sous un faux jour.
Demandez toujours le consentement des utilisateurs si vous utilisez les données d’une manière susceptible d’avoir un impact sur eux ou sur leur réputation.
-
Restez informé : les conditions d’utilisation et les directives communautaires de Reddit peuvent évoluer. Consultez-les régulièrement pour vous assurer que vos pratiques de scraping restent conformes.
Bien que le scraping sur Reddit offre de vastes possibilités d’extraction de données, il est primordial de l’aborder avec respect et responsabilité.
L'utilisation d'outils tels que les proxys résidentiels d'Geonode peut améliorer vos capacités de scraping, mais les considérations éthiques doivent toujours être au cœur de tout projet de scraping, afin de garantir que les droits des utilisateurs et de la plateforme soient toujours respectés.
Questions fréquentes
Q : Quelle est la différence entre l'utilisation de l'API officielle de Reddit et celle d'outils de scraping tiers ?
R : L'API officielle de Reddit est fournie par Reddit et est soumise à des limites de débit et à des conditions d'utilisation spécifiques. Les outils de scraping tiers peuvent offrir davantage de flexibilité, mais ne respectent pas toujours les directives de Reddit.
Q : Comment puis-je m'assurer que je pratique le scraping sur Reddit de manière éthique et légale ?
R : Respectez toujours la vie privée des utilisateurs, conformez-vous aux conditions d’utilisation de Reddit et évitez de collecter des informations privées ou sensibles.
Q : L’utilisation de l’API Reddit entraîne-t-elle des coûts ?
R : Bien que l’accès de base soit gratuit, des coûts peuvent s’appliquer en cas de volumes de requêtes élevés ou pour l’utilisation de fonctionnalités premium.
Q : Comment gérer les limites de débit et éviter d’être banni ?
R : Prévoyez des délais entre les requêtes, respectez le fichier robots.txt de Reddit et envisagez d’utiliser des proxys rotatifs.
Q : Quels sont les meilleurs outils pour extraire les commentaires Reddit et d’autres données ?
R : Parmi les outils populaires, on trouve Geonode, Parsehub et Octoparse, mais le meilleur outil dépend des besoins et de l’expertise de chacun.
Faire ses premiers pas dans le scraping sur Reddit
Le scraping de Reddit peut sembler intimidant au premier abord, surtout compte tenu de la multitude d’outils et de techniques à votre disposition.
Cependant, n’oubliez pas que chaque expert a été un jour un débutant. L’essentiel est de commencer modestement et de progresser petit à petit à mesure que vous gagnez en confiance et en compréhension.
Que vous soyez un chercheur en quête d’informations, un professionnel du marketing à l’affût des tendances ou un passionné de données curieux, le scraping de Reddit peut vous ouvrir les portes d’une mine d’informations. C’est une compétence qui incarne véritablement l’adage : « Dans le domaine du codage, les possibilités sont infinies. »
Alors, retroussez vos manches et lancez-vous dès aujourd’hui dans l’aventure du scraping de Reddit. Relevez les défis et n’oubliez pas que chaque obstacle est un tremplin vers la maîtrise.

