しばしば「インターネットのフロントページ」と呼ばれるRedditは、ユーザー生成コンテンツの巨大なハブです。
月間アクティブユーザー数4億3000万人が、最新のテクノロジートレンドからニッチな趣味に至るまで、数千ものトピック別ディスカッションに参加しているRedditは、活用すべき貴重なツールであり、データの宝庫です。
しかし、このデータを効率的かつ倫理的に抽出するにはどうすればよいのでしょうか?
このガイドでは、Redditスクレイパー、公式API、ツール、手法、そしてRedditデータを効果的に収集するためのベストプラクティスについて詳しく解説します。
Redditのスクレイピングの重要性
データに基づく洞察は成功の鍵となります。
Redditからデータを抽出することで、企業、研究者、データ愛好家は、世論を把握し、市場動向を追跡し、ユーザー生成コンテンツを収集することができます。
この豊富で非構造化されたデータには、以下のような幅広い活用事例があります:
-
市場調査。 「サブレディット」として知られるRedditの多様なコミュニティは、考えられるほぼすべての興味分野を網羅しています。企業はRedditの投稿をスクレイピングすることで、消費者の感情、嗜好、そして新たなトレンドをリアルタイムで把握します。
-
製品フィードバック。 ユーザーは頻繁に製品やサービスについて議論し、率直なフィードバックを提供しています。この貴重なデータは、企業が自社製品やサービスを改善し、懸念事項に対処するのに役立ちます。
-
競合分析。 競合他社に関する議論を監視することで、企業は市場における強み、弱み、および機会を特定できます。
-
コンテンツのアイデア。 コンテンツクリエイターやマーケターは、Redditを利用して注目度の高い投稿やトレンドトピックを発見し、コンテンツの関連性と魅力を維持しています。
-
学術研究。 研究者は、Redditの膨大なデータを活用して、オンライン上の行動、文化的トレンド、社会的ダイナミクスを研究しています。
-
危機管理。 ブランドは、Reddit上の否定的な感情や論争を監視することで、潜在的なPR危機を早期に検知できます。
-
データトレーニングセット。 AIや機械学習に携わる人々にとって、Redditはモデルのトレーニング、特に自然言語処理のための膨大なデータセットを提供します。
効果的なウェブスクレイピングのためのRedditの構造理解
Redditは、他のソーシャルメディアプラットフォームとは一線を画す独自の構造を持つ複雑なプラットフォームです。
Redditからデータをスクレイピングしようとする者にとって、この構造を把握することは極めて重要です。そうすることで、関連性が高く包括的な情報を確実に抽出できるからです。
以下に、その構造について詳しく解説します。
-
サブレディット。 これらは、特定のトピックや関心事に特化した、コミュニティ中心のセクションです。
各サブレディットには固有のURLがあり、多くの場合「r/[サブレディット名]」という形式で表されます。
例えば、プロモーションや割引に焦点を当てた「お得な情報サブレディット」などがあります。
特定のコミュニティをターゲットにするには、サブレディットのURL構造を理解することが不可欠です。
-
投稿。 ユーザーはサブレディット内で投稿を行うことができます。投稿の内容は、詳細なブログ記事から画像、動画、外部サイトへのリンクまで多岐にわたります。
各投稿には固有の構造(「投稿辞書」と呼ばれることが多い)があり、投稿者、投稿タイトル、現在の投稿内容などの詳細が含まれています。
-
コメント。 個々の投稿にはコメントが付けられ、ネスト化されたディスカッションが生まれることがあります。
投稿あたりの平均コメント数を把握したり、コメントの多い投稿をターゲットにしたりすることで、分析に役立つより豊富なデータが得られます。
-
ユーザープロフィールとアプリユーザー。 Redditアプリまたはブラウザのいずれを使用しているかにかかわらず、すべてのRedditユーザーには、投稿やコメントなどのアクティビティが表示されるプロフィールがあります。
これは、特にユーザー行動を分析する上で、データの宝庫となります。
-
デジタル製品とアプリ内課金。 Redditでは、アワードやReddit Premiumなど、さまざまなデジタル製品の提供オプションが用意されています。
ユーザーがこれらとどのように関わっているか、特にアプリ内課金を通じて理解することは、ユーザーの消費行動に関する洞察をもたらします。
-
アプリ広告。 Redditは、ブランドが特定のデモグラフィック層やサブレディット・コミュニティにリーチできる広告機会を提供しています。
これは、プラットフォーム上で広告を出稿しようとする企業にとって不可欠なツールです。
-
ブラウザとのやり取り。 ユーザーがブラウザセッションを通じてRedditにアクセスする場合でも、ブラウザ拡張機能を使用する場合でも、それぞれのやり取りがデータとして残されます。
ブラウザとのやり取りやブラウザプロファイルをスクレイピングする方法を理解することで、ユーザーの行動に関するより深い洞察が得られます。
-
クラウドとデプロイメント。 Redditはクラウドサービスソリューションを採用しており、特にデプロイメントの際にクラウドを検討する際には、この点を理解することが極めて重要となります。
-
分析とツール。 適切な分析ツールを使用することで、企業は特定のトピックが数十のコミュニティでどのように取り上げられているか、あるいはユーザーが「アップボート」ボタンやアップボート要素とどのようにインタラクションしているかを解明できます。
-
自動化とAI。 現代のソーシャルメディアスクレイパーには、自動化機能が備わっています。中には、ユーザーの行動を予測したり、コンテンツを生成したりするために、生成AIツールを使用するものもあります。
-
倫理的配慮。 スクレイピングを行う際は、コンテンツの所有者を尊重し、誤った表示を避けるために説明的なユーザーエージェントを使用することが不可欠です。
ユーザーの権利を侵害することなく、必要な情報を抽出できるよう、常に正しいターゲットURLを指定するようにしてください。
- その他の要素。 Redditは膨大な規模を誇り、サブレディット辞書や説明フィールドなど、より詳細なデータを取得するためにターゲットとできる要素が他にも存在します。
Redditの多面的な構造は、ウェブスクレイパーにとって格好の舞台です。 有意義なデータを抽出するには、その複雑な仕組みを理解する必要があります。
サブレディットのコメントを分析する場合でも、コード行からパターンを調査する場合でも、あるいは製品のマーケティング手法を探る場合でも、Redditの構造を理解することで、スクレイピング作業を効率的かつ倫理的に行うことができます。
スクレイパーツール 1:Reddit 公式 API
Reddit を単なるソーシャルメディアプラットフォームの一つと捉える人もいます。 しかし、その独自の構造と民主的な投票システムにより、Redditは単なるソーシャルメディア以上の存在となっています。
Redditは、「サブレディット」と呼ばれるニッチなコミュニティに分類されたユーザー生成コンテンツによって成り立っています。
各サブレディットは特定のトピックを扱っており、ユーザーはそこで議論に参加したり、リソースを共有したり、アドバイスを求めたりすることができます。
最も多くの「アップボート」を獲得したコンテンツ(最も人気のある投稿)が上位に表示されるため、Redditは世間の関心や世論をリアルタイムに反映する場となっています。
Reddit APIの概要と利用規約
Redditの公式DATA APIは、プラットフォームの膨大なコンテンツへ構造化されたアクセスを提供する強力なツールです。
これは、プラットフォーム上で得られる豊富なインサイトを活用しようとする開発者、研究者、企業にとって不可欠なツールです。
このAPIにより、サードパーティの開発者は、Redditのガイドラインに準拠しつつ効率的な方法で、コメントの読み取り、ユーザー情報の取得、サブレディットの詳細へのアクセスなど、さまざまな操作を行うことができます。
利用ガイドライン、制限および制約
- 登録および利用資格。 Data API にアクセスする前に、ユーザーは登録を行い、利用資格基準を満たしていることを確認する必要があります。これには、法定年齢に達していること、および適用される法律に基づき API の利用が禁止されていないことが含まれます。
- ライセンス。 Redditは、Data APIへのアクセスおよび利用に関する非独占的、譲渡不可、かつ取り消し可能なライセンスを付与します。つまり、ユーザーはAPIへのアクセス権を第三者に再許諾したり譲渡したりすることはできません。
- ユーザーコンテンツ。 Reddit上のコンテンツはユーザーによって生成されたものですが、本APIは、そのコンテンツを変更することなくアクセスする手段を提供します。ユーザーコンテンツの利用にあたっては、元のコンテンツ作成者の権利を尊重しなければなりません。
- プライバシーおよびデータ取り扱い。 開発者は、APIを通じて収集したデータの取り扱い方法を開示し、透明性を確保するとともに、プライバシー関連法規を遵守しなければなりません。
- APIの制限。 Redditは、1時間あたりのリクエスト数など、APIの利用に制限を設ける場合があります。サービスの混乱を避けるため、これらの制限を認識し、遵守することが極めて重要です。
- 利用料金および商用利用。 APIの基本利用は一般的に無料ですが、Redditは利用量が多い場合や商用目的の場合に料金を請求する権利を留保しています。
- コンプライアンス。 APIの利用者は、Redditの利用規約、プライバシーポリシー、およびその他の関連する規約を遵守しなければなりません。 これにより、データへのアクセスが倫理的であり、Redditのコミュニティ基準に沿ったものであることが保証されます。
アプリケーションや研究でRedditのデータを利用しようとする方にとって、これらの規約を理解し遵守することは極めて重要です。これにより、Redditコミュニティの完全性と精神を維持しつつ、スムーズで中断のないデータアクセス体験が保証されます。
スクレイピングツール 2:Python と Selenium
Python は、そのシンプルさと汎用性で知られる、広く利用されているプログラミング言語です。
Pythonには、スクレイピング作業をより容易にする豊富なライブラリやフレームワークが用意されています。その一つがSeleniumです。SeleniumはもともとWebテスト用に設計されましたが、現在ではWebスクレイピングの定番ツールとなっています。
Seleniumは、Webブラウザを自動化する仕組みで動作します。 人間のようなブラウジング動作をシミュレートできるため、あたかも実際のユーザーが操作しているかのようにウェブページからデータをスクレイピングすることが可能です。
Pythonと組み合わせることで、Seleniumを使用する開発者は、アカウントへのログイン、特定のページへの移動、ボタンのクリック、そして最も重要なデータ抽出といったタスクを実行できるスクリプトを作成できます。
Redditのように、動的コンテンツ(ページを更新せずに読み込まれたり変更されたりするコンテンツ)が豊富なプラットフォームでは、Seleniumは極めて有用です。
従来のスクレイピングツールではこのようなコンテンツの処理に苦労することがありますが、ブラウザ自動化ツールであるSeleniumなら、容易にアクセスできます。
RedditのスクレイピングにPythonとSeleniumを使用するメリット
- 動的コンテンツへのアクセス。 前述の通り、Seleniumは動的コンテンツとやり取りできるため、スクレイピングの過程でデータを見逃すことはありません。
- 人間のような操作。 スクロールやクリックといった人間の操作を模倣できるSeleniumの機能は、一部のスクレイピング対策の回避に役立ちます。
- 柔軟性。 Pythonの豊富なライブラリとSeleniumのブラウザ自動化機能は、柔軟な組み合わせです。 クッキーの処理、セッションの管理、ポップアップへの対応など、PythonとSeleniumならすべてに対応可能です。
- 幅広いブラウザ対応。 SeleniumはChrome、Firefox、Safariなど複数のブラウザに対応しており、必要に応じてクロスブラウザでのスクレイピングが可能です。
想定される課題
- パフォーマンス。 Seleniumは実際のブラウザを自動操作するため、ページのソースコードを直接取得する他の軽量なスクレイピングツールに比べて処理が遅くなる可能性があります。
- 複雑さ。 Seleniumベースのスクレイパーの設定は、特に初心者にとっては、単純なHTTPリクエストベースのツールを使用するよりも複雑になる可能性があります。
- スクレイピング対策。 Seleniumは一部のスクレイピング対策技術を回避できますが、Redditのようなプラットフォームは防御策を絶えず進化させています。そのため、スクレイパーはCAPTCHA、レート制限、一時的なIPブロックなどの課題に直面する可能性があります。
- メンテナンス。 ウェブページは時間の経過とともに変化します。Redditがデザインを一新したり、構造を変更したりした場合、スクレイパーが動作しなくなり、更新が必要になる可能性があります。
スクレイパーツール 3: PRAW (Python Reddit API Wrapper)
PRAW(Python Reddit API Wrapper)は、本質的にPythonアプリケーションとRedditのAPIをつなぐ架け橋となるものです。
開発者は、生のHTTPリクエストを扱ったり、複雑なJSONレスポンスを解析したりする代わりに、PRAWの直感的なメソッドを使用してRedditのデータを取得し、操作することができます。
PRAW を使用するメリット
-
シンプルさ。 PRAW は Reddit API の複雑さを抽象化し、開発者にデータにアクセスするための直感的なメソッドを提供します。
例えば、サブレディットのトップ投稿を取得したり、特定のスレッドからコメントを取得したりする作業も、わずか数行のコードで済みます。
-
レート制限の処理。 Redditは、APIへのアクセス頻度に制限を設けています。
PRAWはこれらのレート制限を自動的に管理し、アプリケーションが制限を超過して一時的な利用停止処分を受けるリスクを防ぎます。
-
コンプライアンス。 PRAWを使用することで、開発者はRedditのAPI利用規約を自然に遵守することになり、データアクセスに関する問題のリスクを最小限に抑えられます。
-
充実したドキュメント。 PRAWには包括的なドキュメントが付属しており、初心者から経験豊富な開発者まで、簡単に使い始めたり、問題のトラブルシューティングを行ったりできます。
-
活発なコミュニティ。 PRAWには活発なコミュニティがあります。これにより、定期的なアップデート、豊富なオンラインリソース、そして直面するあらゆる課題に対するコミュニティからのサポートが得られます。
基本的な設定と使用例
設定
-
PRAW を使用する前に、Reddit の開発者ポータルでスクリプトアプリケーションを登録し、必要な API 認証情報を取得してください。
-
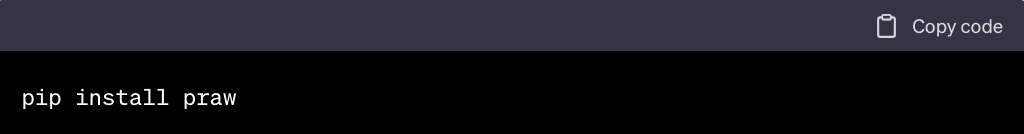
pip を使用して PRAW をインストールします。
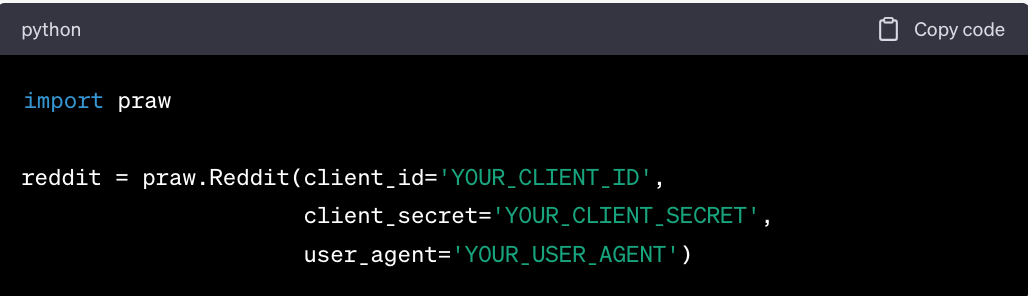
- API 認証情報を使用して Reddit インスタンスを初期化します。
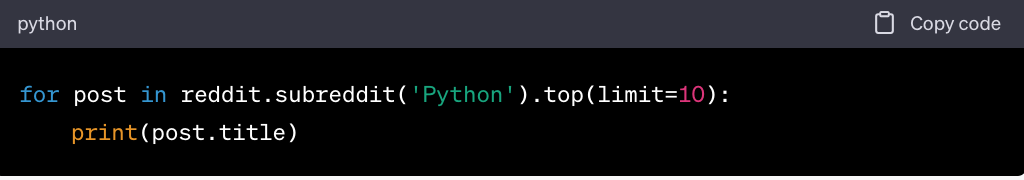
使用例
- サブレディットの投稿上位10件を取得する
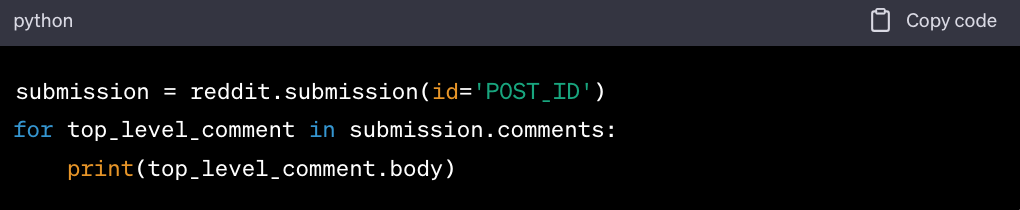
- 特定のスレッドからコメントを取得する
- キーワードを含む投稿の検索
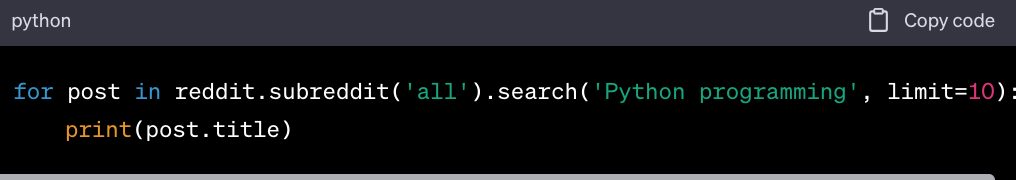
PRAWは、Pythonを使ってRedditのデータを掘り下げたい人にとって欠かせないツールです。そのシンプルさと強力な機能を兼ね備えているため、単純なデータ抽出タスクから複雑なデータ分析プロジェクトに至るまで、幅広い用途に最適です。
スクレイピングツール 4:Scrapy フレームワーク
Scrapy は、Python で記述された高水準のオープンソースの Web クローリングおよびスクレイピングフレームワークです。 単純な単発のデータ抽出から、大規模で複雑なウェブクロールプロジェクトに至るまで、幅広いスクレイピングタスクに対応するように設計されています。ScrapyはRedditに限定されるものではなく、あらゆるウェブサイトからのデータスクレイピングに使用できます。
主な機能
-
汎用性。 Scrapyは、CSSセレクタ、XPath、さらには正規表現を使用してウェブサイトからデータを抽出でき、さまざまなウェブサイトの構造に対応しています。
-
ミドルウェアと拡張機能。 Scrapyはミドルウェアと拡張機能をサポートしており、開発者はスクレイピングプロセスをカスタマイズしたり、リトライやユーザーエージェントを処理したり、さらにはプロキシプールを統合したりすることができます。
-
パイプライン処理。 データがスクレイピングされると、Scrapyはアイテムパイプラインを提供し、データの処理、検証、保存を行います。保存先はデータベース、ファイル、さらにはクラウドストレージにも可能です。
-
並行クロール。 ScrapyはTwistedという非同期ネットワークライブラリを基盤としており、複数のリクエストを並行して処理できるため、データ抽出プロセスを高速化します。
-
堅牢なエラー処理。 Scrapyはエラーを適切に処理できるため、些細な不具合によってスクレイピングプロセス全体が停止することはありません。
-
組み込みのエクスポーター。 Scrapyは、追加のプラグインやツールを必要とせずに、JSON、CSV、XMLなどの複数の形式で結果をエクスポートできます。
Redditのデータ抽出のためにScrapyを設定・使用する方法
Scrapy のセットアップ:ステップバイステップチュートリアル
-
pip を使用して Scrapy をインストールしましょう!
-
新しい Scrapy プロジェクトを開始しましょう!
Reddit データ抽出に Scrapy を使用する
-
スパイダーを作成する。 Scrapyプロジェクト内で、リンクの追跡方法やデータの抽出方法を定義するクラスである「スパイダー」を作成します。Redditの場合は、次のようなスパイダーを作成します: 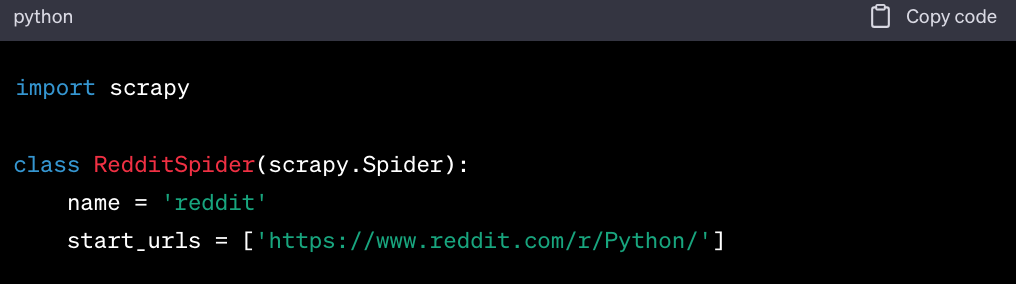
-
抽出ロジックを定義する。 CSSセレクタやXPathを使用して、Redditページからデータを抽出します。 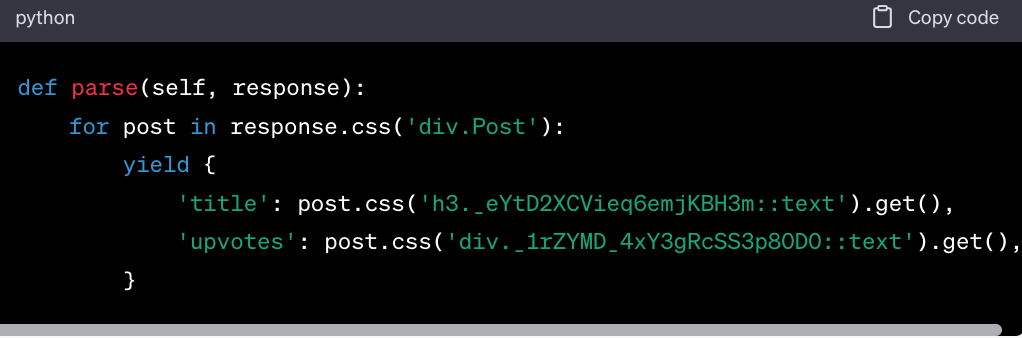
-
ページネーションを追跡する。 Redditには複数のページにまたがるコンテンツがあります。Scrapyを設定することで、リンクをたどって異なるページにわたるデータをスクレイピングできます。
-
スパイダーの実行: スパイダーの設定が完了したら、プロジェクトディレクトリに移動して、以下のコマンドを実行します: 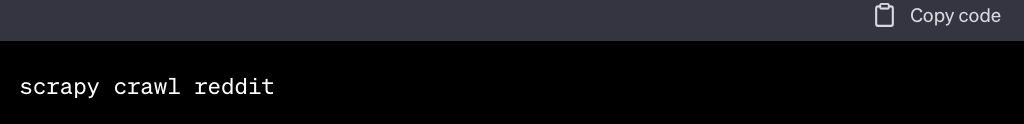
-
データの保存: Scrapyでは、スクレイピングしたデータをさまざまな形式で保存できます。たとえば、データをJSONファイルに保存するには: 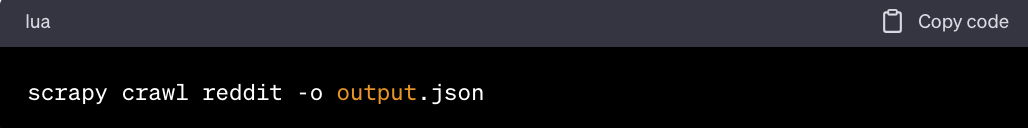
スクレイパーツール 5:GitHub リポジトリ
世界をリードするソフトウェア開発プラットフォームであるGitHubには、ウェブスクレイピングをはじめとする様々なタスクに特化したリポジトリが数多くホストされています。
その中でも、Redditデータのスクレイピングに特化したリポジトリが数多く存在します。
これらのリポジトリでは、多くの場合、あらかじめ構築されたツール、スクリプト、またはライブラリが提供されており、Redditのスクレイピングプロセスを簡素化し、コーディング経験が限られている人でも利用できるようにしています。
RedditのスクレイピングにGitHubリポジトリを利用するメリット
-
すぐに使えるソリューション。 多くの GitHub リポジトリは、最小限の設定で利用できる完全なソリューションを提供しています。ユーザーはリポジトリをクローンし、提供された手順に従うだけで、ツールをゼロから構築することなくスクレイピングを開始できます。
-
コミュニティによるサポート。 人気のあるリポジトリには、多くの場合、活発なコミュニティが存在します。 ユーザーはイシューを報告したり、助けを求めたり、さらにはプロジェクトに貢献したりすることで、ツールの機能を強化することができます。
-
継続的な更新。 ウェブサイトは常に変化するため、スクレイピングツールには定期的な更新が必要です。活発なGitHubリポジトリは、対象ウェブサイトの構造の変化に対応したり、機能を改善したりするために頻繁に更新されます。
-
多様なアプローチ。 リポジトリによって、PRAWやScrapyのようなPythonベースのソリューションから、Node.js、さらにはDocker化されたアプリケーションに至るまで、スクレイピングに様々な手法やツールが採用されています。この多様性により、ユーザーは自身の技術的専門知識やプロジェクトの要件に合ったツールを選択できます。
-
ドキュメントとサンプル。 信頼性の高いリポジトリのほとんどは、包括的なドキュメント、セットアップガイド、使用例を提供しており、ユーザーが支障なくすぐに使い始められるようになっています。
GitHubでのRedditスクレイパーの探索
GitHubで「reddit-scraper」というキーワードで簡単に検索するだけで、Redditのデータ抽出に特化したさまざまなリポジトリが見つかります。
見つけられる可能性のあるリポジトリには、次のようなものがあります:
-
Redditスクレイパーボット。 これらは、指定されたサブレディットやスレッドから投稿やコメントなどを取得できる自動化スクリプトです。
-
Reddit API ラッパー。 PRAW が最も人気がありますが、他のラッパーには独自の機能があったり、異なるプログラミング言語に対応していたりする場合があります。
-
Docker 化された Reddit スクラッパー。 コンテナ化されたソリューションをお探しの方には、一貫性がありスケーラブルなスクレイピング操作を保証するDockerセットアップを提供するリポジトリもあります。
-
専用ツール。 Redditクローラーツールの中には、サブレディットからすべての画像をダウンロードしたり、トレンドトピックを抽出したり、特定のキーワードを監視したりするなど、特定のタスクに特化したものもあります。
RedditスクレイピングにGitHubリポジトリを使用する手順
-
リポジトリの選択。 GitHubのreddit-scraperトピックにアクセスし、ニーズに合ったリポジトリを選択します。
-
クローンとセットアップ。 リポジトリの指示に従ってください。通常、リポジトリのクローン作成と、必要な依存関係の設定が含まれます。
-
設定。 多くのツールでは、対象のサブレディットの指定、API キーの設定、出力形式の定義など、何らかの設定が必要になります。
-
実行とデータの抽出。 提供されているスクリプトやコマンドを実行して、スクレイピングプロセスを開始します。
-
後処理。 ツールによっては、抽出されたデータに対して、フィルタリング、クリーニング、または希望の形式への変換など、さらなる処理が必要になる場合があります。
スクレイピングツール 6:サードパーティ製のRedditスクレイパー
Reddit上のデータは膨大かつ豊富であるため、いくつかのサードパーティ製スクレイピングツールが登場しています。これらのツールは、スクレイピングのプロセスを簡素化し、企業から研究者まで、より幅広いユーザー層が利用できるようにすることを目的としています。ここでは、最も人気のあるサードパーティ製Redditスクレイパーをいくつか詳しく見ていきましょう:
- 料金体系: 柔軟なpay-as-you-goモデルを提供しています。
- ユーザー体験: 初心者から専門家まで使いやすい直感的なインターフェース。
- パフォーマンス: 高速かつ信頼性の高いデータ抽出。
- プライバシー: ユーザーのプライバシーを重視し、データの完全性とセキュリティを確保しています。
- 自動化: 適応型スクレイピングを実現するAI駆動の自動化機能を備えています。
- データ変換: スクレイピングしたデータを精製・分析するための統合ツール。
- 汎用性: 複数のウェブサイトを対象とした包括的なスクレイピングソリューション。
- インターフェース: プロジェクト設計を容易にするビジュアルインターフェース。
- 高度な機能: AJAXやJavaScriptに対応し、徹底的なデータ抽出を実現。
- スケジュール機能: 定期的なスクレイピングタスクを設定する機能を提供。
- 展開: クラウドベースとローカルの両方の抽出オプションを提供。
- 使いやすさ: CAPTCHA や IP ブロックへの対応機能を備え、セットアップが簡単です。
- 連携: シームレスなデータ転送を実現する API 連携機能を備えています。
- シンプルさ: 簡単なスクレイピングを実現する、あらかじめ構築されたモジュールの提供に重点を置いています。
- 手頃な価格: さまざまな予算に適した、費用対効果の高いソリューションを重視しています。
- 主なサービス: スクレイピングに関する知見を持つプロキシプロバイダーとして知られています。
- 匿名性: ローテーションIPや、匿名でのスクレイピングに最適な膨大な住宅用プロキシプールを提供しています。
- ガイダンス: Redditを含むウェブスクレイピングに関する詳細なガイドを提供しています。
- APIベースのアプローチ: 既存システムへの容易な統合を可能にするシンプルなAPIを提供しています。
- スケーラビリティ: 速度を損なうことなく、大規模なスクレイピングタスクを処理できるよう設計されています。
- 匿名性: ローテーションプロキシシステムを採用し、匿名かつ中断のないスクレイピングを保証します。
- 汎用性: 複数のプラットフォームに対応しており、特にRedditのスクレイピングに強みを持っています。
各サードパーティ製スクレイパーにはそれぞれ独自の強みがありますが、Geonodeのユーザー中心のアプローチと柔軟な価格設定は、このツールを際立った選択肢にしています。
ただし、最適なツールは、個々の要件、技術的な専門知識、および予算によって異なることがよくあります。
ベストプラクティスと倫理的配慮
Redditのスクレイピングは、データ抽出のための強力なツールである一方で、それに伴う責任も存在します。
倫理的な実践を確保することは、ユーザーの権利を保護するだけでなく、スクレイピング活動の持続性と評判を保証することにもつながります。
ここでは、Redditをスクレイピングする際のベストプラクティスと倫理的配慮について詳しく解説します:
ユーザーのプライバシーを尊重する
デジタル時代の到来に伴い、ユーザーのプライバシーに対する懸念が高まっています。Redditをスクレイピングする際は、プラットフォームのユーザーのプライバシーを最優先にすることが極めて重要です。
-
倫理的なスクレイピング。 抽出するデータが公開されているものであることを常に確認してください。個人情報や非公開のサブレディットからのコンテンツをスクレイピングすることは避けてください。 データにアクセスできるからといって、それをスクレイピングすることが倫理的であるとは限らないことを忘れないでください。
-
匿名性。 Redditユーザーはペンネームで活動していますが、このデータを慎重に取り扱うことが不可欠です。ユーザーの匿名性を解除したり、実世界の身元を明らかにしたりする可能性のある行為は避けてください。
-
データ保護。 スクレイピングしたデータを保存する場合は、暗号化して安全に保管してください。不正アクセスを防ぐため、強固なサイバーセキュリティ対策を講じてください。
-
透明性。 スクレイピングしたデータを研究やビジネス目的で使用する場合は、データソースやデータの用途について透明性を確保してください。
レート制限と制限事項への対応
Redditは、多くのプラットフォームと同様に、サーバーの安定性を確保し、悪用を防ぐためにレート制限を設けています。
-
APIの制限を理解する。 RedditのAPIを使用する場合は、そのレート制限についてよく理解しておいてください。通常、これらは1分あたりのリクエスト数として設定されています。これらの制限を超えると、一時的または恒久的な利用停止処分を受ける可能性があります。
-
遅延を設ける。 スクレイピングリクエストの間に遅延を設けてください。これはプラットフォームのサーバーへの配慮となるだけでなく、スクレイパーが特定されてブロックされる可能性も低減します。
-
信頼できるプロキシサービスプロバイダーを利用して、IPアドレスとユーザーエージェントをローテーションさせる。 Geonodeのレジデンシャルプロキシを利用すれば、IPアドレスのローテーションプールが提供されるため、制限を回避し、スクレイピング活動をより自然なものと見せることができます。ユーザーエージェントのローテーションと組み合わせることで、この戦略はブロックされる可能性を大幅に低減できます。ただし、この戦略は常に倫理的に使用し、プラットフォームの運営を妨げるような過度なスクレイピングは避けてください。
-
Redditのrobots.txtを遵守する。 robots.txtファイルには、スクレイピングが許可される内容と禁止される内容に関するガイドラインが記載されています。常にRedditのルールを確認し、遵守してください。
データの保存と利用
責任はデータのスクレイピングが終わった時点で終わるわけではありません。このデータをどのように保存し、利用するかという点も極めて重要です。
-
安全な保存。 保存するデータはすべて、暗号化されたデータベースに保管するようにしてください。定期的にデータのバックアップを取り、情報漏洩を防ぐためのセキュリティ対策を講じてください。
-
データの最小化。 目的に必要なデータのみを保存してください。特に機密情報や個人情報については、過剰な情報の蓄積を避けてください。
-
倫理的な利用。 スクレイピングしたデータを公開または共有する場合は、Redditコミュニティに害を与えたり、誤った印象を与えたりしないようにしてください。
ユーザーやその評判に影響を与える可能性のある方法でデータを使用する場合は、必ず同意を得てください。
-
最新情報の確認: Redditの利用規約やコミュニティガイドラインは変更される可能性があります。スクレイピングの実践が引き続き規約に準拠していることを確認するため、これらを定期的に確認してください。
Redditのスクレイピングはデータ抽出の大きな機会を提供しますが、敬意と責任を持って取り組むことが極めて重要です。
Geonodeの住宅用プロキシなどのツールを活用することでスクレイピング能力を向上させることができますが、いかなるスクレイピングプロジェクトにおいても、倫理的な配慮を常に最優先し、ユーザーおよびプラットフォームの権利が常に守られるようにする必要があります。
よくある質問
Q: Redditの公式APIとサードパーティ製のスクレイパーを使う場合の違いは何ですか?
A: 公式のReddit APIはRedditによって提供されており、特定のレート制限や利用規約があります。サードパーティ製のスクレイパーはより柔軟性が高い場合もありますが、必ずしもRedditのガイドラインを遵守しているとは限りません。
Q: Redditからのスクレイピングを倫理的かつ合法的に行うにはどうすればよいですか?
A: 常にユーザーのプライバシーを尊重し、Redditの利用規約を遵守し、非公開情報や機密情報のスクレイピングは避けてください。
Q: Reddit APIの利用には費用はかかりますか?
A: 基本的なアクセスは無料ですが、リクエスト量が多い場合やプレミアム機能を利用する場合は費用が発生する可能性があります。
Q: レート制限に対処し、利用停止を避けるにはどうすればよいですか?
A: リクエスト間に遅延を設け、Redditのrobots.txtを遵守し、プロキシのローテーション利用を検討してください。
Q: Redditのコメントやその他のデータをスクレイピングするのに最適なツールは何ですか?
A: Geonode、Parsehub、Octoparseなどが人気ですが、最適なツールは個々のニーズや専門知識によって異なります。
Redditスクレイピングへの第一歩
Redditのスクレイピングは、特に利用可能なツールや手法が数多くあるため、最初は難しそうに思えるかもしれません。
しかし、どんな専門家も最初は初心者だったことを忘れないでください。重要なのは、小さなことから始め、自信と理解を深めながら徐々に規模を広げていくことです。
洞察を求める研究者であれ、トレンドを追うマーケターであれ、あるいは好奇心旺盛なデータ愛好家であれ、Redditのスクレイピングは膨大な情報の扉を開くことができます。これはまさに、「コーディングの世界では、可能性は無限大だ」という言葉を体現するスキルです。
さあ、今すぐ袖をまくり上げて、Redditスクレイピングの旅に出かけましょう。課題に積極的に取り組み、一つひとつのハードルが熟達への足がかりであることを忘れないでください。

