

O Scrapy é uma estrutura de código aberto para rastreamento da Web que pode ser utilizada gratuitamente por qualquer pessoa na Internet. O Scrapy é utilizado principalmente para rastreamento da Web e web scraping. É uma forma rápida e fácil de extrair dados de qualquer página Web e, atualmente, é mantido pela Zyte.
Instalação do Scrapy
Para instalar o Scrapy, é necessária uma versão do Python 3.7 ou superior. Recomenda-se também instalá-lo num virtualenv dedicado, para evitar eventuais conflitos com os pacotes do sistema.
Descarregue o Scrapy na sua plataforma preferida.
Para instalar o Scrapy, tem de instalar o Anaconda ou o Miniconda, abrir o Python e executar o comando:
conda install -c conda-forge scrapy
Em alternativa, também pode executar:
pip install Scrapy
Se estiver a utilizar um sistema Ubuntu, terá primeiro de instalar todas estas dependências:
sudo apt-get install python3 python3-dev python3-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
Se estiver a utilizar um sistema macOS, terá de instalar as ferramentas de linha de comandos do Xcode. Deve abrir uma janela de terminal e executar:
xcode-select --install
Parabéns! Já instalou o Scrapy no seu dispositivo. Agora, podemos tentar rastrear um site e extrair os seus dados.
Iniciar um projeto Scrapy
Para iniciar um novo projeto Scrapy, é necessário indicar um diretório onde pretende que o seu código seja guardado. Deve executar:
scrapy startproject scrapetest
Ao executar este código, será criado um diretório chamado «scrapetest», que conterá o seguinte:
_scrapetest/ scrapy.cfg # ficheiro de configuração de implementação
scrapetest/             # módulo Python do projeto; o seu código será importado a partir daqui
    __init__.py

    items.py

    middlewares.py

    pipelines.py

    settings.py

    spiders/          # um diretório onde, mais tarde, colocará os seus spiders
        __init__.py
_
Depois de iniciar um projeto Scrapy, tem agora de criar um Spider. Um spider é necessário porque é ele que o Scrapy utiliza para extrair informações de uma página web. A título de exemplo, vamos fazer o scraping do site “quotes.toscrape.com”.
Em primeiro lugar, tem de executar o código:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" # Os nomes dos spiders devem ser únicos para cada spider que criar
def start_requests(self):
    urls = [
        'https://quotes.toscrape.com/page/1/',
        # Altere estas URLs para
as páginas web que pretende extrair 'https://quotes.toscrape.com/page/2/', ] for url in urls: yield scrapy.Request(url=url, callback=self.parse)
def parse(self, response):
    page = response.url.split("/")[-2]
    filename = f'quotes-{page}.html'
    with open(filename, 'wb') as f:
        f.write(response.body)
    self.log(f'Ficheiro guardado {filename}')
_
Para que o spider comece a rastrear, tem de executar:
scrapy crawl test
Deve então obter uma saída que indique que rastreou o site “quotes.toscrape.com”.
Se pretender extrair determinados dados de uma página web, pode utilizar a palavra-chave “yield” do Python e executar o código:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', 'https://quotes.toscrape.com/page/2/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }
_
Este código extrai os textos, o autor e as etiquetas da página web que extraiu, os quais serão apresentados no registo.
Se pretender extrair todas as páginas de um site, em vez de apenas páginas específicas, pode executar:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }

    next_page = response.css('li.next a::attr(href)').get()
    if next_page is not None:
        next_page = response.urljoin(next_page)
        yield scrapy.Request(next_page, callback=self.parse)
_
Agora, precisa de guardar os dados que o spider extraiu. Para guardar os dados extraídos, basta executar:
scrapy crawl test -O test.json
Se quiser acrescentar qualquer conteúdo novo a um ficheiro já existente, pode executar este código em vez disso:
scrapy crawl quotes -o quotes.jsonl
Parabéns! Concluiu a extração e o armazenamento dos dados que recolheu com o Scrapy. Ainda pode adicionar algo para garantir que a recolha de dados da Web com o Scrapy seja bem-sucedida: utilizar proxies do Scrapy.
Configurar proxies do Scrapy
Um proxy do Scrapy irá tratar de todos os teus pedidos à Web por ti, pelo que qualquer site que explorares só poderá ver o endereço IP do servidor proxy. O seu endereço IP ficará completamente oculto. Ao alternar continuamente os endereços IP e utilizar proxies residenciais, os sites serão levados a acreditar que as suas solicitações provêm de utilizadores reais e não apenas de alguém que utiliza um bot de scraping como o Scrapy.
A título de exemplo, iremos utilizar um proxy Geonode. Pode avançar para «Obter detalhes do servidor proxy com Geonode» se ainda não tiver obtido os detalhes do seu proxy Geonode.
Existem dois métodos para configurar um proxy no Scrapy.
O primeiro método consiste em utilizar o middleware do Scrapy, denominado HTTPProxyMiddleware, que configura automaticamente o seu parâmetro de proxy como proxy predefinido.
Pode executar:
_def start_requests(self): for url in self.start_urls: return Request(url=url, callback=self.parse, headers={"User-Agent": "My UserAgent"}, meta={"proxy": "premium-residential.geonode.com:9001"}) _
O segundo método consistiria em criar o seu próprio middleware. Este método é mais isolado e oferece-lhe um maior grau de liberdade.
Pode executar:
_from w3lib.http import basic_auth_header
DOWNLOADER_MIDDLEWARES = { 'myproject.middlewares.CustomProxyMiddleware': 350, 'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 400, }
class CustomProxyMiddleware(object): def process_request(self, request, spider): request.meta[“proxy”] = "premium-residential.geonode.com:9001" request.headers[“Proxy-Authorization”] = basic_auth_header(“geonode_xbYe9H2LYr”, “9806022c-cd4a-4776-a053-73fee44344dd”) _
Parabéns! Acabou de adicionar um servidor proxy para quando fizer o scraping de qualquer site com o Scrapy. Se quiser verificar se o seu proxy está a funcionar, pode visitar https://www.geonode.com/what-is-my-ip.
Obter detalhes do servidor proxy com o Geonode
Passo 1. Aceda a **Geonode
** e inicie sessão com a sua conta existente ou registe-se para criar uma nova.
Passo 2. Na página inicial, clique em «Serviços Residenciais».

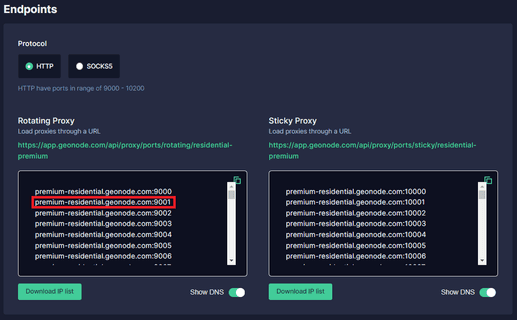
Passo 3. Desça a página até ver «Endpoints».
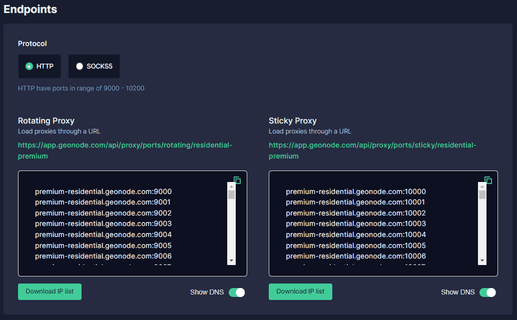
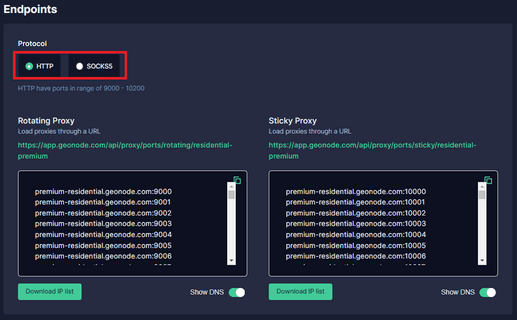
Passo 4. Escolha qual o «Protocolo de proxy» que pretende utilizar: «Protocolo HTTP» ou **«[Protocolo SOCKS5
](https://geonode.com/blog/beginners-guide-to-socks5-proxies)»**.
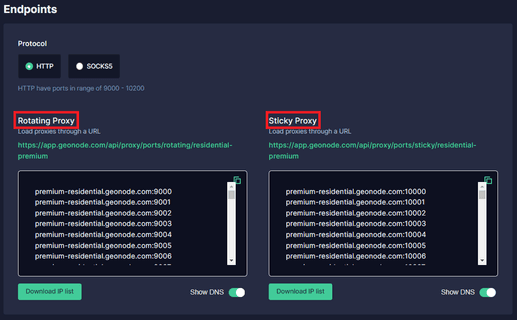
Passo 5. Selecione o «Tipo de sessão» que pretende utilizar: «Proxy rotativo» ou Proxy fixo.
Passo 6. Escolha o proxy que pretende utilizar. A título de exemplo, vamos utilizar o proxy destacado **“premium-residential.geonode
.com:9001”**.
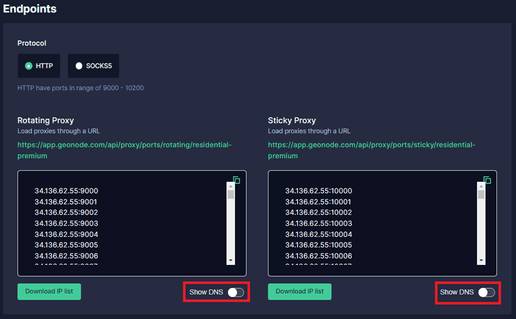
Se pretender utilizar um endereço IP em vez de um DNS, basta desativar o botão «Mostrar DNS» e os endereços IP serão apresentados.
Passo 7. Agora precisa dos «Detalhes de autenticação» da sua conta de proxy. No caso do Geonode
, estes encontram-se na página inicial da sua conta.
