O que é o web scraping?
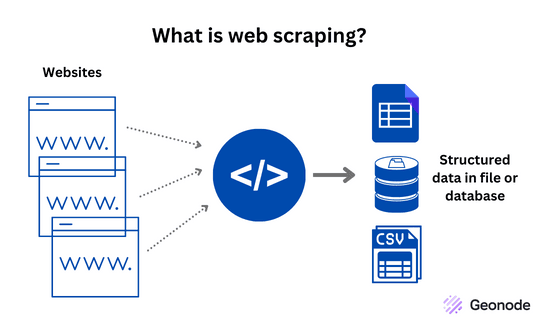
O web scraping, também conhecido como extração de dados da Web ou recolha de dados da Web, é o processo de extrair dados de sítios Web utilizando software automatizado. Pode ser feito manualmente, como copiar e colar dados à mão, ou automaticamente, como extrair informações através de um web scraper.
Fazê-lo manualmente requer tempo e esforço, especialmente se pretender extrair grandes volumes de dados. É por isso que a maioria dos utilizadores prefere recorrer a web scrapers para fazer o trabalho por si. Esta tecnologia permite que indivíduos e organizações recolham informações de várias fontes de forma rápida e eficiente.
Que tipos de dados é possível extrair da Internet?
Existem muitos tipos diferentes de dados que é possível extrair da Internet, incluindo:
Dados de texto. Isto inclui tudo, desde títulos, artigos e descrições de produtos até comentários, avaliações e muito mais.
Imagens e vídeos. É possível extrair fotografias e vídeos de sítios Web, incluindo imagens de produtos, infográficos e muito mais.
Dados estruturados. Este tipo de dados está organizado num formato específico, como tabelas, folhas de cálculo e bases de dados. Exemplos de dados estruturados incluem listas de produtos, anúncios imobiliários e dados financeiros.
Dados não estruturados. Este tipo de dados não está organizado num formato específico e pode incluir elementos como publicações nas redes sociais, comentários e muito mais.
Metadados. Este tipo de dados fornece informações sobre outros tipos de dados, tais como a data da última atualização de uma página web, o autor de uma publicação e muito mais.
Ao compreender os diferentes tipos de dados disponíveis para a extração de dados da Web, pode determinar quais os dados mais úteis para as suas necessidades específicas e desenvolver uma estratégia para extrair esses dados de forma eficaz.
O web scraping é legal?
O web scraping é legal, embora os sites não fiquem propriamente entusiasmados com a ideia de os utilizadores extraírem dados dos seus sites. Se detetarem que está a utilizar um web scraper ou qualquer outra ferramenta de automatização no site deles, irão bloquear imediatamente a sua conta e colocar o seu endereço IP na lista negra.
Se quiseres saber mais sobre a legalidade do web scraping, podes ler um artigo detalhado sobre o assunto aqui: Legalidade e mitos do web scraping.
Como funcionam os web scrapers?
Na sua essência, o web scraping é um processo que envolve o envio de um pedido ao servidor de um site, o descarregamento do código HTML e, em seguida, a extração da informação pretendida. O pedido é normalmente efetuado através de uma ferramenta de web scraping ou de uma abordagem programática, como a utilização de uma linguagem de programação como o Python.
Assim que o código HTML é recebido, a ferramenta ou o programa de web scraping analisa o código para encontrar os dados específicos que se pretende extrair. Isto é frequentemente feito através de uma técnica denominada «extração de dados», que utiliza regras ou padrões para extrair informações do código HTML.
Os dados extraídos são, em seguida, armazenados num formato estruturado, como uma folha de cálculo ou uma base de dados, para posterior análise ou utilização.
Quais são os diferentes tipos de web scrapers?
Existem vários tipos diferentes de web scrapers, cada um com o seu próprio conjunto de funcionalidades e capacidades. Neste guia, vamos explorar os diferentes tipos de web scrapers, para que possa escolher aquele que melhor se adequa às suas necessidades.
Scrapers de ecrã simples
Os scrapers de ecrã simples são o tipo mais básico de scrapers da Web. Extraem dados de sites, copiando e colando informações do site para um ficheiro local. São normalmente utilizados em projetos de pequena escala e não requerem muitos conhecimentos técnicos.
Scrapers de ecrã complexos
Os scrapers de ecrã complexos são mais avançados do que os simples e são utilizados em projetos de maior escala. Extraem dados de sites utilizando scripts para automatizar o processo de extração, tornando-o mais rápido e eficiente. Os scrapers de ecrã complexos utilizam frequentemente APIs para aceder aos dados, o que lhes permite extrair maiores quantidades de informação.
Navegadores sem interface gráfica
Os navegadores sem interface gráfica são programas de extração de dados da Web que não utilizam uma interface gráfica de utilizador. Funcionam em segundo plano e extraem dados de sites sem apresentar o site numa janela do navegador.
Os navegadores sem interface gráfica são úteis para a extração de dados da Web porque são mais rápidos e eficientes do que os navegadores tradicionais e permitem extrair dados de sites sem ter de carregar a página na íntegra.
Rastreadores da Web
Os rastreadores da Web são um tipo de web scraper concebido para percorrer sites de grande dimensão, extraindo informações de várias páginas. Funcionam começando numa página específica e seguindo, em seguida, links para outras páginas, extraindo informações à medida que avançam.
Os rastreadores da Web são utilizados para uma vasta gama de tarefas, desde a recolha de informações para motores de busca até à monitorização de alterações em sites.
Web scrapers criados pelo próprio utilizador
Os web scrapers criados pelo próprio utilizador são ferramentas de web scraping que indivíduos ou organizações criam por conta própria utilizando linguagens de programação como Python, Ruby ou JavaScript. Esta abordagem permite-lhes adaptar o seu web scraper especificamente às suas necessidades, tais como a extração de um site específico, um tipo de dados ou uma determinada frequência.
Os web scrapers criados pelo próprio requerem, normalmente, mais conhecimentos técnicos e tempo em comparação com a utilização de uma solução pronta a usar. No entanto, a vantagem desta abordagem é que o web scraper resultante pode ser altamente personalizado, proporcionando um maior controlo sobre o processo de extração e os dados resultantes.
Web Scrapers sob a forma de extensões de navegador
Um web scraper sob a forma de extensão de navegador é uma ferramenta de software que se integra diretamente no seu navegador e automatiza o processo de extração de dados de sites. Este tipo de scraper foi concebido para funcionar de forma integrada no seu navegador, proporcionando-lhe um acesso fácil aos dados de que necessita sem ter de alternar entre diferentes programas ou aplicações.
Com um scraper de extensão de navegador, pode selecionar facilmente os dados que pretende extrair e definir os parâmetros para a sua extração. O scraper tratará então do resto. Irá extrair os dados de que necessita e apresentá-los num formato claro e organizado, poupando-lhe tempo e esforço em comparação com a extração manual.
Scrapers com interface de utilizador
Um scraper com interface de utilizador funciona apresentando ao utilizador uma interface onde este pode selecionar os dados que pretende extrair. O utilizador pode interagir com a interface, selecionar os dados que pretende extrair e o scraper trata do resto. Pode percorrer automaticamente o site, extrair os dados e guardá-los num formato estruturado, como CSV, Excel ou uma base de dados.
Uma das principais vantagens de utilizar um scraper de web com interface de utilizador é que elimina a necessidade de conhecimentos de programação. Basta apontar e clicar para selecionar os dados que pretende extrair. Isto torna-o uma excelente opção para quem pretende realizar tarefas simples de extração de dados sem necessidade de conhecimentos técnicos.
Outra vantagem dos scrapers de web com interface de utilizador é a sua facilidade de utilização. Foram concebidos para serem intuitivos, e pode começar rapidamente sem ter de aprender a utilizar um novo software. Basta seguir os passos e terá os seus dados num instante.
Scrapers de web na nuvem
Um web scraper na nuvem é uma ferramenta que lhe permite executar tarefas de web scraping numa infraestrutura baseada na nuvem. Em vez de utilizar o seu computador para realizar o scraping, pode aproveitar a capacidade de processamento de servidores remotos na nuvem. Isto significa que pode extrair dados de sites em grande escala e lidar com volumes maiores de dados sem se preocupar com as limitações do seu hardware local.
Uma das principais vantagens de utilizar web scrapers na nuvem é a capacidade de aceder a uma quantidade praticamente ilimitada de recursos, incluindo armazenamento, capacidade de processamento e largura de banda. Isto significa que pode extrair dados mesmo dos sites maiores e mais complexos sem se preocupar com problemas de desempenho.
Outra vantagem é a capacidade de executar tarefas de web scraping 24 horas por dia, 7 dias por semana, sem interrupção, mesmo que o seu computador esteja desligado. Isto deve-se ao facto de os web scrapers na nuvem poderem ser configurados para funcionar em servidores remotos que estão sempre ligados.
Web Scrapers Locais
Os web scrapers locais são um tipo de ferramenta de web scraping que funciona no seu computador, em vez de num servidor remoto na nuvem. São uma boa opção para projetos de web scraping de pequena escala, em que apenas é necessário extrair uma quantidade limitada de dados. São também uma boa opção se tiver preocupações com a privacidade dos dados ou se precisar de extrair dados de sites que não são acessíveis a partir da Internet pública.
Uma das principais vantagens de utilizar um web scraper local é que é simples de configurar e utilizar. Não é necessário ter conhecimentos especializados nem competências técnicas para começar, e pode começar a extrair dados imediatamente.
Outra vantagem é que tem controlo total sobre o processo de extração. Pode configurar o extrator para extrair dados no formato de que necessita e também definir a frequência e o horário das tarefas de extração.
Quais são as linguagens de programação mais populares para a extração de dados da Web?
Existem muitas linguagens de programação que podem ser utilizadas para a extração de dados da Web, cada uma com os seus pontos fortes e fracos. Vamos explorar algumas das linguagens de programação mais populares para a extração de dados da Web.
Python: O Python é uma das linguagens de programação mais populares para o web scraping. Conta com uma comunidade vasta e ativa, que desenvolveu muitas bibliotecas e ferramentas especificamente para o web scraping. A BeautifulSoup e o Scrapy são duas das bibliotecas Python mais utilizadas para o web scraping.
Ruby: O Ruby é outra linguagem de programação popular para a extração de dados da Web. Possui uma comunidade vasta e ativa, e existem muitas bibliotecas e ferramentas disponíveis para a extração de dados da Web. A Nokogiri é uma biblioteca Ruby popular para a extração de dados da Web.
JavaScript: O JavaScript é uma linguagem popular para a extração de dados da Web, uma vez que é utilizada para alimentar muitos sites. Com o surgimento do Node.js, o JavaScript tornou-se uma escolha popular para a extração de dados da Web do lado do servidor. O Puppeteer é uma biblioteca popular em JavaScript para a extração de dados da Web.
PHP: O PHP é uma linguagem de programação popular para a extração de dados da Web, uma vez que é amplamente utilizada na criação de sites. Existem muitas bibliotecas e ferramentas disponíveis para a extração de dados da Web com PHP. A Simple HTML DOM é uma biblioteca PHP popular para a extração de dados da Web.
Java: O Java é uma linguagem de programação popular para a extração de dados da Web devido à sua eficiência e escalabilidade. Existem muitas bibliotecas e ferramentas disponíveis para a extração de dados da Web com Java, incluindo o JSoup e o HtmlUnit.
Para que servem os web scrapers?
O web scraping é utilizado para diversos fins, incluindo:
Recolha de dados: Pode ser utilizado para recolher grandes quantidades de dados de sítios Web e transformá-los em informação estruturada que pode ser utilizada para análise e investigação. Estes dados podem ser utilizados para tomar decisões empresariais informadas, acompanhar as tendências do setor e muito mais.
Monitorização da marca: Pode ser utilizado para monitorizar a opinião dos clientes através da recolha de avaliações de clientes disponíveis publicamente. Esta informação pode ajudá-lo a manter e até a melhorar a sua reputação online.
Anúncios imobiliários: Podem ser utilizados para recolher informações sobre vários dados imobiliários, incluindo preço, tipo e localização dos imóveis, entre muitos outros.
Monitorização de Preços: Pode ser utilizada para monitorizar preços em sites de comércio eletrónico e acompanhar os preços da concorrência. Estas informações podem ser utilizadas para ajustar a sua estratégia de preços e manter-se competitivo.
Geração de leads: Pode ser utilizado para recolher informações sobre potenciais clientes e criar listas direcionadas para fins de vendas e marketing.
Monitorização das redes sociais: Pode ser utilizado para monitorizar as redes sociais em busca de menções à sua marca, aos seus concorrentes ou ao seu setor, e para recolher insights e dados valiosos sobre o seu público.
Inteligência de Preços: Pode ser utilizada para recolher e comparar informações globais sobre preços de produtos e reunir tudo num único local.
Monitorização de Notícias e Conteúdos: Pode ser utilizada para recolher informações de várias fontes, incluindo sites de notícias, e compilá-las num único local, facilitando o acesso e a análise.
Ofertas de emprego: Pode ser utilizado para recolher ofertas de emprego de vários sites e compilá-las num único local, facilitando a procura de oportunidades de emprego.
Agregação de viagens: Pode ser utilizado para recolher informações de muitos sites de hotéis e companhias aéreas e compilá-las num único local.
O que é uma ferramenta de web scraping?
As ferramentas de web scraping são programas de software concebidos para extrair automaticamente dados de sítios web. São utilizadas para recolher informações para diversos fins, incluindo análise de dados, investigação, monitorização de preços e muito mais. Vamos apresentar-lhe o mundo das ferramentas de web scraping e explicar-lhe como estas podem ajudá-lo a atingir os seus objetivos.
Como funcionam as ferramentas de web scraping?
As ferramentas de web scraping funcionam enviando um pedido a um site e, em seguida, extraindo os dados do código HTML que o site devolve. Estes dados podem depois ser armazenados e analisados para obter insights ou utilizados para outros fins.
Quais são as vantagens de utilizar uma ferramenta de web scraping?
As principais vantagens de utilizar uma ferramenta de web scraping incluem a poupança de tempo, a redução do trabalho manual e a recolha de grandes quantidades de dados de múltiplas fontes. Com uma ferramenta de web scraping, pode recolher de forma rápida e fácil os dados de que necessita, libertando tempo para outras tarefas importantes.
Quais são os diferentes tipos de ferramentas de web scraping?
Existem vários tipos diferentes de ferramentas de web scraping, incluindo scrapers baseados na nuvem, scrapers locais e extensões de navegador. Cada tipo de ferramenta tem as suas características e vantagens únicas, e a ferramenta certa para si dependerá das suas necessidades e objetivos específicos.
Como escolher uma ferramenta de web scraping?
Ao escolher uma ferramenta de web scraping, tenha em conta fatores como a facilidade de utilização, a velocidade e o custo. Também é importante considerar o tipo de dados que precisa de extrair, uma vez que algumas ferramentas podem não ser capazes de lidar com sites complexos ou dinâmicos.
Que ferramentas pode utilizar para extrair dados da Web?
Eis algumas das ferramentas de web scraping mais populares disponíveis:
Beautiful Soup: O Beautiful Soup é uma biblioteca Python que facilita a extração de dados de ficheiros HTML e XML. É uma das ferramentas de web scraping mais utilizadas e é excelente para lidar com sites complexos e mal formatados.
Scrapy: O Scrapy é outra biblioteca Python para a extração de dados da Web. É mais potente do que o Beautiful Soup, mas também mais complexo. Se tiver experiência com Python, o Scrapy é uma excelente opção para projetos de extração de dados da Web em grande escala.
Octoparse: O Octoparse é uma ferramenta para extração de dados da Web baseada no Windows que não requer programação. É fácil de utilizar e oferece uma interface visual para criar fluxos de trabalho de extração de dados da Web.
Parsehub: Parsehub é uma ferramenta baseada na Web para web scraping que não requer programação. É semelhante ao Octoparse, mas funciona em qualquer sistema operativo com um navegador da Web.
WebHarvy: WebHarvy é outra ferramenta visual de web scraping que não requer programação. É fácil de utilizar e é compatível tanto com Windows como com Mac.
Scraper API: O flexível scraper da Geonode foi concebido para tornar a extração de dados da Web fácil e eficiente para os programadores, quer sejam principiantes ou experientes.
Estas são apenas algumas das muitas ferramentas de extração de dados da Web disponíveis. Ao escolher uma ferramenta, é importante ter em conta o seu nível de competências técnicas, a dimensão dos projetos em que irá trabalhar e as suas necessidades específicas. Independentemente da ferramenta que escolher, irá certamente descobrir que a extração de dados da Web é uma forma valiosa e eficiente de recolher dados da Web.
O que é o processo de web scraping?
O processo de web scraping pode ser dividido em várias etapas:
- Determinar o site alvo e os dados a extrair: O primeiro passo consiste em identificar o site do qual pretende extrair dados e os dados específicos que pretende recolher.
- Analisar o site: Antes de iniciar o scraping, é importante analisar o site para compreender como está estruturado e quais os dados disponíveis. Isto pode ajudar a identificar as ferramentas e técnicas adequadas a utilizar no processo de scraping.
- Escolher uma ferramenta de scraping ou escrever código: Existem muitas ferramentas disponíveis para o web scraping, incluindo ferramentas de código aberto e ferramentas pagas. Algumas opções populares incluem o BeautifulSoup, o Scrapy e o Selenium. Em alternativa, pode escrever o seu próprio código para extrair dados do site utilizando uma linguagem de programação como o Python ou o Java.
- Escreva o código ou configure a ferramenta de extração: Depois de escolher uma ferramenta ou de decidir escrever o seu próprio código, terá de configurá-la para extrair os dados que pretende do site. Isto pode envolver escrever código para navegar no site e extrair elementos específicos, ou configurar a ferramenta de extração para identificar os dados que pretende.
- Executar o scraper: Assim que o seu código ou ferramenta de scraping estiver configurado, pode executar o scraper para extrair os dados do site. Dependendo do tamanho do site e da quantidade de dados que pretende recolher, este processo pode demorar vários minutos ou até horas.
- Limpar e analisar os dados: O passo final consiste em limpar e analisar os dados que recolheu. Isto pode envolver a remoção de dados irrelevantes, a formatação dos dados para um formato utilizável e a realização de quaisquer análises necessárias para obter insights a partir dos dados.
Seguindo estes passos, pode extrair dados de forma eficaz a partir de sites e utilizá-los para obter insights ou apoiar as suas decisões empresariais.
Considerações finais
Os web scrapers são ferramentas úteis que o ajudam a obter os dados de que necessita de forma rápida e eficiente. Existem muitos tipos diferentes de web scrapers e pode utilizá-los para obter vários tipos de dados.
Com as ferramentas certas, pode otimizar o processo de recolha e poupar muito tempo e esforço. Ao escolher uma ferramenta, é importante ter em conta o seu nível de competências técnicas, a dimensão dos projetos em que irá trabalhar e as suas necessidades específicas.
Se quiser experimentar uma excelente ferramenta de web scraping, pode consultar o Scraper API da Geonode. Pode experimentá-la gratuitamente e ver se se adequa a si e às suas necessidades.