Was ist Web-Scraping?
Web-Scraping, auch bekannt als Web-Datenextraktion oder Web-Harvesting, ist der Vorgang, bei dem mithilfe automatisierter Software Daten aus Websites extrahiert werden. Dies kann entweder manuell erfolgen, beispielsweise durch manuelles Kopieren und Einfügen von Daten, oder automatisch, beispielsweise durch das Extrahieren von Informationen mittels eines Web-Scrapers.
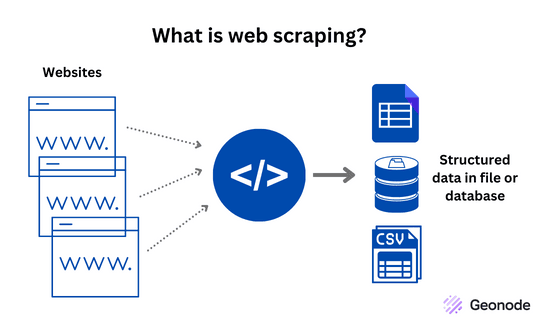
Die manuelle Durchführung ist zeit- und arbeitsaufwendig, insbesondere wenn große Datenmengen extrahiert werden sollen. Aus diesem Grund ziehen es die meisten Nutzer vor, Web-Scraper einzusetzen, die diese Aufgabe für sie übernehmen. Diese Technologie ermöglicht es Einzelpersonen und Organisationen, Informationen aus verschiedenen Quellen schnell und effizient zu sammeln.
Welche Arten von Daten können Sie aus dem Internet extrahieren?
Es gibt viele verschiedene Arten von Daten, die Sie aus dem Internet extrahieren können, darunter:
Textdaten. Dazu gehören unter anderem Überschriften, Artikel und Produktbeschreibungen sowie Kommentare, Bewertungen und vieles mehr.
Bilder und Videos. Sie können Fotos und Videos von Websites extrahieren, darunter Produktbilder, Infografiken und vieles mehr.
Strukturierte Daten. Diese Art von Daten ist in einem bestimmten Format organisiert, beispielsweise in Tabellen, Tabellenkalkulationen und Datenbanken. Beispiele für strukturierte Daten sind Produktlisten, Immobilienanzeigen und Finanzdaten.
Unstrukturierte Daten. Diese Art von Daten ist nicht in einem bestimmten Format organisiert und kann beispielsweise Social-Media-Beiträge, Kommentare und vieles mehr umfassen.
Metadaten. Diese Art von Daten liefert Informationen über andere Datentypen, wie zum Beispiel das Datum der letzten Aktualisierung einer Webseite, den Autor eines Beitrags und vieles mehr.
Wenn Sie die verschiedenen für das Web-Scraping verfügbaren Datentypen verstehen, können Sie feststellen, welche Daten für Ihre spezifischen Anforderungen am nützlichsten sind, und eine Strategie entwickeln, um diese Daten effektiv zu scrapen.
Ist Web-Scraping legal?
Web-Scraping ist legal, auch wenn Websites nicht gerade begeistert davon sind, dass Nutzer ihre Seiten scrapen. Wenn sie feststellen, dass Sie auf ihrer Website einen Web-Scraper oder ein anderes Automatisierungstool verwenden, werden sie Ihr Konto sofort sperren und Ihre IP-Adresse auf die schwarze Liste setzen.
Wenn Sie mehr über die Rechtmäßigkeit von Web-Scraping erfahren möchten, können Sie hier einen ausführlichen Artikel dazu lesen: Rechtmäßigkeit und Mythen rund um Web-Scraping.
Wie funktionieren Web-Scraper?
Im Kern ist Web-Scraping ein Prozess, bei dem eine Anfrage an den Server einer Website gesendet, der HTML-Code heruntergeladen und anschließend die gewünschten Informationen extrahiert werden. Die Anfrage erfolgt in der Regel mithilfe eines Web-Scraper-Tools oder eines programmatischen Ansatzes, beispielsweise unter Verwendung einer Programmiersprache wie Python.
Sobald der HTML-Code empfangen wurde, analysiert das Web-Scraper-Tool oder das Programm den Code, um die spezifischen Daten zu finden, die Sie extrahieren möchten. Dies geschieht häufig mithilfe einer Technik namens „Datenextraktion“, bei der Regeln oder Muster verwendet werden, um Informationen aus dem HTML-Code zu extrahieren.
Die extrahierten Daten werden anschließend in einem strukturierten Format, beispielsweise in einer Tabellenkalkulation oder einer Datenbank, gespeichert, um sie weiter zu analysieren oder zu nutzen.
Welche verschiedenen Arten von Web-Scrapern gibt es?
Es gibt verschiedene Arten von Web-Scrapern, von denen jede ihre eigenen Funktionen und Fähigkeiten aufweist. In diesem Leitfaden werden wir die verschiedenen Arten von Web-Scrapern näher betrachten, damit Sie den für Ihre Anforderungen passenden auswählen können.
Einfache Screen-Scraper
Einfache Screen-Scraper sind die grundlegendste Art von Web-Scrapern. Sie extrahieren Daten von Websites, indem sie Informationen von der Website kopieren und in eine lokale Datei einfügen. Sie werden in der Regel für kleinere Projekte verwendet und erfordern keine großen technischen Kenntnisse.
Komplexe Screen-Scraper
Komplexe Screen-Scraper sind fortgeschrittener als einfache Screen-Scraper und werden für größere Projekte eingesetzt. Sie extrahieren Daten von Websites, indem sie Skripte zur Automatisierung des Scraping-Prozesses nutzen, wodurch dieser schneller und effizienter wird. Komplexe Screen-Scraper greifen häufig über APIs auf Daten zu, wodurch sie größere Mengen an Informationen extrahieren können.
Headless-Browser
Headless-Browser sind Web-Scraper, die keine grafische Benutzeroberfläche verwenden. Sie laufen im Hintergrund und extrahieren Daten von Websites, ohne die Website in einem Browserfenster anzuzeigen.
Headless-Browser sind für das Web-Scraping nützlich, da sie schneller und effizienter sind als herkömmliche Webbrowser und es ermöglichen, Daten von Websites zu extrahieren, ohne die gesamte Seite laden zu müssen.
Webcrawler
Webcrawler sind eine Art von Webscraper, die dafür ausgelegt sind, große Websites zu durchlaufen und Informationen von mehreren Seiten zu extrahieren. Sie beginnen auf einer bestimmten Seite und folgen dann Links zu anderen Seiten, wobei sie nach und nach Informationen extrahieren.
Web-Crawler werden für eine Vielzahl von Aufgaben eingesetzt, von der Sammlung von Informationen für Suchmaschinen bis hin zur Überwachung von Websites auf Änderungen.
Selbst entwickelte Web-Scraper
Selbst entwickelte Web-Scraper sind Web-Scraping-Tools, die Einzelpersonen oder Organisationen mithilfe von Programmiersprachen wie Python, Ruby oder JavaScript selbst erstellen. Dieser Ansatz ermöglicht es ihnen, ihren Web-Scraper speziell auf ihre Bedürfnisse zuzuschneiden, beispielsweise hinsichtlich des Scrapings einer bestimmten Website, eines bestimmten Datentyps oder der Häufigkeit.
Selbst entwickelte Web-Scraper erfordern in der Regel mehr technisches Fachwissen und Zeit als die Verwendung einer Standardlösung. Der Vorteil dieses Ansatzes besteht jedoch darin, dass der resultierende Web-Scraper in hohem Maße angepasst werden kann, was eine bessere Kontrolle über den Scraping-Prozess und die resultierenden Daten ermöglicht.
Web-Scraper als Browser-Erweiterung
Ein Web-Scraper als Browser-Erweiterung ist ein Software-Tool, das sich direkt in Ihren Webbrowser integriert und den Prozess des Datenscrapings von Websites automatisiert. Diese Art von Scraper ist so konzipiert, dass er nahtlos in Ihrem Browser funktioniert und Ihnen einfachen Zugriff auf die benötigten Daten ermöglicht, ohne dass Sie zwischen verschiedenen Programmen oder Anwendungen wechseln müssen.
Mit einem Web-Scraper als Browser-Erweiterung können Sie ganz einfach die Daten auswählen, die Sie extrahieren möchten, und die Parameter für Ihren Scraping-Vorgang festlegen. Den Rest erledigt dann der Scraper. Er extrahiert die benötigten Daten und präsentiert sie in einem übersichtlichen und gut strukturierten Format, wodurch Sie im Vergleich zum manuellen Scraping Zeit und Aufwand sparen.
Web-Scraper mit Benutzeroberfläche
Ein Web-Scraper mit Benutzeroberfläche (UI) stellt dem Nutzer eine Oberfläche zur Verfügung, über die er die Daten auswählen kann, die er extrahieren möchte. Der Nutzer kann mit der Benutzeroberfläche interagieren, die Daten auswählen, die er extrahieren möchte, und der Scraper erledigt den Rest. Er kann die Website automatisch durchsuchen, die Daten extrahieren und sie in einem strukturierten Format wie CSV, Excel oder einer Datenbank speichern.
Einer der Hauptvorteile der Verwendung eines UI-Web-Scrapers besteht darin, dass keine Programmierkenntnisse erforderlich sind. Sie können die Daten, die Sie extrahieren möchten, einfach per Mausklick auswählen. Dies macht ihn zu einer hervorragenden Option für alle, die einfache Scraping-Aufgaben ohne technisches Fachwissen durchführen möchten.
Ein weiterer Vorteil von UI-Web-Scrapern ist ihre einfache Bedienung. Sie sind benutzerfreundlich gestaltet, und Sie können schnell loslegen, ohne sich in eine neue Software einarbeiten zu müssen. Folgen Sie einfach den Schritten, und schon haben Sie Ihre Daten im Handumdrehen.
Cloud-Web-Scraper
Ein Cloud-Web-Scraper ist ein Tool, mit dem Sie Web-Scraping-Aufgaben auf einer cloudbasierten Infrastruktur ausführen können. Anstatt Ihren Computer für das Scraping zu nutzen, können Sie die Rechenleistung von Remote-Servern in der Cloud nutzen. Das bedeutet, dass Sie Websites in großem Umfang scrapen und größere Datenmengen verarbeiten können, ohne sich Gedanken über die Einschränkungen Ihrer lokalen Hardware machen zu müssen.
Einer der Hauptvorteile der Verwendung von Cloud-Web-Scrapern ist der Zugriff auf eine praktisch unbegrenzte Menge an Ressourcen, darunter Speicherplatz, Rechenleistung und Bandbreite. Das bedeutet, dass Sie selbst die größten und komplexesten Websites scrapen können, ohne sich Gedanken über Leistungsprobleme machen zu müssen.
Ein weiterer Vorteil ist die Möglichkeit, Web-Scraping-Aufgaben rund um die Uhr ohne Unterbrechung auszuführen, selbst wenn Ihr Computer ausgeschaltet ist. Dies liegt daran, dass Cloud-Web-Scraper so konfiguriert werden können, dass sie auf Remote-Servern laufen, die stets eingeschaltet sind.
Lokale Web-Scraper
Lokale Web-Scraper sind eine Art von Web-Scraping-Tool, das auf Ihrem Computer und nicht auf einem Remote-Server in der Cloud ausgeführt wird. Sie sind eine gute Wahl für kleine Web-Scraping-Projekte, bei denen Sie nur eine begrenzte Datenmenge extrahieren müssen. Sie sind auch eine gute Option, wenn Sie Bedenken hinsichtlich des Datenschutzes haben oder wenn Sie Websites scrapen müssen, die über das öffentliche Internet nicht zugänglich sind.
Einer der Hauptvorteile der Verwendung eines lokalen Web-Scrapers ist, dass er einfach einzurichten und zu bedienen ist. Sie benötigen keine speziellen Kenntnisse oder technischen Fähigkeiten, um loszulegen, und können sofort mit dem Scraping von Daten beginnen.
Ein weiterer Vorteil ist, dass Sie die volle Kontrolle über den Scraping-Prozess haben. Sie können den Scraper so konfigurieren, dass er Daten in dem von Ihnen benötigten Format extrahiert, und Sie können auch die Häufigkeit und den Zeitplan der Scraping-Aufgaben festlegen.
Welche Programmiersprachen sind für das Web-Scraping beliebt?
Für das Web-Scraping können viele Programmiersprachen verwendet werden, von denen jede ihre Stärken und Schwächen hat. Wir werden einige der beliebtesten Programmiersprachen für das Web-Scraping näher betrachten.
Python: Python ist eine der beliebtesten Programmiersprachen für das Web-Scraping. Es verfügt über eine große und aktive Community, die viele Bibliotheken und Tools speziell für das Web-Scraping entwickelt hat. BeautifulSoup und Scrapy sind zwei der am häufigsten verwendeten Python-Bibliotheken für das Web-Scraping.
Ruby: Ruby ist eine weitere beliebte Programmiersprache für das Web-Scraping. Es verfügt über eine große und aktive Community, und es stehen zahlreiche Bibliotheken und Tools für das Web-Scraping zur Verfügung. Nokogiri ist eine beliebte Ruby-Bibliothek für das Web-Scraping.
JavaScript: JavaScript ist eine beliebte Sprache für das Web-Scraping, da es zur Umsetzung vieler Websites verwendet wird. Mit dem Aufkommen von Node.js hat sich JavaScript zu einer beliebten Wahl für serverseitiges Web-Scraping entwickelt. Puppeteer ist eine beliebte JavaScript-Bibliothek für das Web-Scraping.
PHP: PHP ist eine beliebte Programmiersprache für das Web-Scraping, da sie häufig zur Erstellung von Websites verwendet wird. Es gibt zahlreiche Bibliotheken und Tools für das Web-Scraping mit PHP. Simple HTML DOM ist eine beliebte PHP-Bibliothek für das Web-Scraping.
Java: Java ist aufgrund seiner Effizienz und Skalierbarkeit eine beliebte Programmiersprache für das Web-Scraping. Es gibt zahlreiche Bibliotheken und Tools für das Web-Scraping mit Java, darunter JSoup und HtmlUnit.
Wozu werden Web-Scraper verwendet?
Web-Scraping wird für eine Vielzahl von Zwecken genutzt, darunter:
Datenerfassung: Kann dazu verwendet werden, große Datenmengen von Websites zu erfassen und in strukturierte Informationen umzuwandeln, die für Analysen und Forschungszwecke genutzt werden können. Diese Daten können genutzt werden, um fundierte geschäftliche Entscheidungen zu treffen, Branchentrends zu verfolgen und vieles mehr.
Markenbeobachtung: Kann genutzt werden, um die Kundenmeinung zu beobachten, indem öffentlich zugängliche Kundenbewertungen gesammelt werden. Diese Informationen können Ihnen helfen, Ihre Online-Reputation zu pflegen und sogar zu verbessern.
Immobilienanzeigen: Können genutzt werden, um Informationen zu verschiedenen Immobiliendaten zu sammeln, darunter Immobilienpreise, Immobilientypen, Immobilienstandorte und vieles mehr.
Preisüberwachung: Kann genutzt werden, um Preise auf E-Commerce-Websites zu überwachen und die Preisgestaltung der Konkurrenz zu verfolgen. Diese Informationen können genutzt werden, um Ihre Preisstrategie anzupassen und wettbewerbsfähig zu bleiben.
Lead-Generierung: Kann genutzt werden, um Informationen über potenzielle Kunden zu sammeln und gezielte Listen für Vertriebs- und Marketingzwecke zu erstellen.
Social-Media-Monitoring: Kann genutzt werden, um soziale Medien auf Erwähnungen Ihrer Marke, Ihrer Wettbewerber oder Ihrer Branche zu überwachen und wertvolle Erkenntnisse und Daten über Ihre Zielgruppe zu gewinnen.
Preisauswertung: Kann genutzt werden, um globale Produktpreisinformationen zu sammeln, zu vergleichen und an einem Ort zusammenzufassen.
Nachrichten- und Content-Monitoring: Kann genutzt werden, um Informationen aus verschiedenen Quellen, einschließlich Nachrichtenseiten, zu sammeln und an einem Ort zusammenzufassen, wodurch der Zugriff und die Analyse erleichtert werden.
Stellenanzeigen: Kann genutzt werden, um Stellenanzeigen von verschiedenen Websites zu sammeln und an einem Ort zusammenzufassen, wodurch die Suche nach Stellenangeboten erleichtert wird.
Reise-Aggregation: Kann genutzt werden, um Informationen von vielen Hotel- und Fluggesellschaften-Websites zu sammeln und an einem Ort zusammenzufassen.
Was ist ein Web-Scraping-Tool?
Web-Scraping-Tools sind Softwareprogramme, die dazu dienen, Daten automatisch aus Websites zu extrahieren. Sie werden eingesetzt, um Informationen für verschiedene Zwecke zu sammeln, darunter Datenanalyse, Recherche, Preisüberwachung und vieles mehr. Wir führen Sie in die Welt der Web-Scraping-Tools ein und erklären Ihnen, wie diese Ihnen helfen können, Ihre Ziele zu erreichen.
Wie funktionieren Web-Scraping-Tools?
Web-Scraping-Tools senden eine Anfrage an eine Website und extrahieren anschließend die Daten aus dem HTML-Code, den die Website zurückgibt. Diese Daten können dann gespeichert und analysiert werden, um Erkenntnisse zu gewinnen, oder für andere Zwecke genutzt werden.
Was sind die Vorteile der Verwendung eines Web-Scraping-Tools?
Zu den wichtigsten Vorteilen der Nutzung eines Web-Scraping-Tools gehören Zeitersparnis, die Reduzierung manueller Arbeit und das Sammeln großer Datenmengen aus verschiedenen Quellen. Mit einem Web-Scraping-Tool können Sie die benötigten Daten schnell und einfach erfassen und so Zeit für andere wichtige Aufgaben gewinnen.
Welche verschiedenen Arten von Web-Scraping-Tools gibt es?
Es gibt verschiedene Arten von Web-Scraping-Tools, darunter cloudbasierte Scraper, lokale Scraper und Browser-Erweiterungen. Jede Art von Tool hat ihre eigenen Funktionen und Vorteile, und welches Tool für Sie das richtige ist, hängt von Ihren spezifischen Anforderungen und Zielen ab.
Wie wählt man ein Web-Scraping-Tool aus?
Berücksichtigen Sie bei der Auswahl eines Web-Scraping-Tools Faktoren wie Benutzerfreundlichkeit, Geschwindigkeit und Kosten. Es ist außerdem wichtig, die Art der Daten zu berücksichtigen, die Sie auslesen möchten, da manche Tools möglicherweise nicht in der Lage sind, komplexe oder dynamische Websites zu verarbeiten.
Welche Tools können Sie zum Web-Scraping verwenden?
Hier sind einige der beliebtesten verfügbaren Web-Scraping-Tools:
Beautiful Soup: Beautiful Soup ist eine Python-Bibliothek, die das Auslesen von Daten aus HTML- und XML-Dateien vereinfacht. Es ist eines der am häufigsten verwendeten Web-Scraping-Tools und eignet sich hervorragend für den Umgang mit komplexen und schlecht formatierten Websites.
Scrapy: Scrapy ist eine weitere Python-Bibliothek für das Web-Scraping. Sie ist leistungsfähiger als Beautiful Soup, aber auch komplexer. Wenn Sie Erfahrung mit Python haben, ist Scrapy eine hervorragende Wahl für umfangreiche Web-Scraping-Projekte.
Octoparse: Octoparse Scraper ist ein Windows-basiertes Tool für das Web-Scraping, das keinerlei Programmierkenntnisse erfordert. Es ist einfach zu bedienen und bietet eine visuelle Oberfläche zum Erstellen von Web-Scraping-Workflows.
Parsehub: Parsehub ist ein webbasiertes Tool für das Web-Scraping, das keine Programmierung erfordert. Es ähnelt Octoparse, funktioniert jedoch auf jedem Betriebssystem mit einem Webbrowser.
WebHarvy: WebHarvy ist ein weiteres visuelles Web-Scraping-Tool, das keine Programmierung erfordert. Es ist einfach zu bedienen und unterstützt sowohl Windows als auch Mac.
Scraper API: Der flexible Web-Scraper von Geonode wurde entwickelt, um das Web-Scraping für Entwickler einfach und effizient zu gestalten, egal ob sie Anfänger oder erfahrene Nutzer sind.
Dies sind nur einige der vielen verfügbaren Web-Scraping-Tools. Bei der Auswahl eines Tools ist es wichtig, Ihr technisches Niveau, den Umfang der Projekte, an denen Sie arbeiten werden, und Ihre spezifischen Anforderungen zu berücksichtigen. Ganz gleich, für welches Tool Sie sich entscheiden – Sie werden feststellen, dass Web-Scraping eine wertvolle und effiziente Methode ist, um Daten aus dem Internet zu sammeln.
Wie läuft der Web-Scraping-Prozess ab?
Der Web-Scraping-Prozess lässt sich in mehrere Schritte unterteilen:
- Festlegen der Zielwebsite und der zu extrahierenden Daten: Im ersten Schritt müssen Sie die Website identifizieren, von der Sie Daten extrahieren möchten, sowie die konkreten Daten, die Sie erfassen möchten.
- Die Website untersuchen: Bevor Sie mit dem Scraping beginnen, ist es wichtig, die Website zu untersuchen, um zu verstehen, wie sie aufgebaut ist und welche Daten verfügbar sind. Dies kann Ihnen dabei helfen, die richtigen Tools und Techniken für den Scraping-Prozess zu finden.
- Ein Scraping-Tool auswählen oder Code schreiben: Es stehen zahlreiche Tools für das Web-Scraping zur Verfügung, darunter sowohl Open-Source- als auch kostenpflichtige Tools. Zu den beliebten Optionen zählen BeautifulSoup, Scrapy und Selenium. Alternativ können Sie Ihren eigenen Code schreiben, um die Website mit einer Programmiersprache wie Python oder Java zu scrapen.
- Schreiben Sie den Code oder konfigurieren Sie das Scraping-Tool: Sobald Sie sich für ein Tool entschieden oder beschlossen haben, Ihren eigenen Code zu schreiben, müssen Sie es so konfigurieren, dass es die gewünschten Daten von der Website extrahiert. Dies kann das Schreiben von Code zur Navigation auf der Website und zum Extrahieren bestimmter Elemente beinhalten oder die Konfiguration des Scraping-Tools, um die gewünschten Daten zu identifizieren.
- Den Scraper ausführen: Sobald Ihr Code oder das Scraping-Tool konfiguriert ist, können Sie den Scraper ausführen, um die Daten von der Website zu extrahieren. Je nach Größe der Website und der Menge der Daten, die Sie erfassen möchten, kann dieser Vorgang mehrere Minuten oder sogar Stunden dauern.
- Die Daten bereinigen und analysieren: Der letzte Schritt besteht darin, die gesammelten Daten zu bereinigen und zu analysieren. Dazu gehört unter anderem das Entfernen irrelevanter Daten, das Aufbereiten der Daten in ein nutzbares Format sowie die Durchführung aller notwendigen Analysen, um Erkenntnisse aus den Daten zu gewinnen.
Wenn Sie diese Schritte befolgen, können Sie Daten effektiv von Websites scrapen und diese nutzen, um Erkenntnisse zu gewinnen oder Ihre geschäftlichen Entscheidungen zu unterstützen.
Abschließende Gedanken
Web-Scraper sind nützliche Tools, mit denen Sie die benötigten Daten schnell und effizient abrufen können. Es gibt viele verschiedene Arten von Web-Scrapern, mit denen Sie unterschiedliche Arten von Daten erfassen können.
Mit den richtigen Tools können Sie den Erfassungsprozess optimieren und sich viel Zeit und Mühe sparen. Bei der Auswahl eines Tools ist es wichtig, Ihr technisches Know-how, den Umfang der Projekte, an denen Sie arbeiten werden, sowie Ihre spezifischen Anforderungen zu berücksichtigen.
Wenn Sie ein hervorragendes Web-Scraping-Tool ausprobieren möchten, können Sie sich Geonodes „Scraper API“ ansehen. Sie können es kostenlos testen und prüfen, ob es für Sie und Ihre Anforderungen geeignet ist.