Der Zugriff auf Immobiliendaten von Plattformen wie redfin.com ist für viele Unternehmen mittlerweile unverzichtbar geworden.
Ganz gleich, ob Sie Immobilienanalyst, Datenwissenschaftler oder einfach nur Technikbegeisterter sind – zu wissen, wie man Daten von Redfin ausliest, kann Ihnen wertvolle Einblicke verschaffen.
Dieser umfassende Leitfaden führt Sie durch die besten Vorgehensweisen, Tools und Methoden, um Daten von Redfin effizient und ethisch einwandfrei auszulesen.
Warum Redfin scrapen?
Redfin: Eine hervorragende Quelle für Immobilienanzeigen
Redfin ist eine führende Immobilienwebsite, die Anzeigen für zum Verkauf stehende Immobilien, Daten zum Immobilienmarkt und weitere damit verbundene Dienstleistungen anbietet.
Redfin wurde 2004 gegründet und hat sich zu einer der führenden Plattformen in der Immobilienbranche entwickelt. Die Plattform bietet Nutzern eine benutzerfreundliche Oberfläche, über die sie nach Immobilien anhand verschiedener Kriterien wie Immobilientyp, Lage, Preisklasse, Anzahl der Schlafzimmer und mehr suchen können.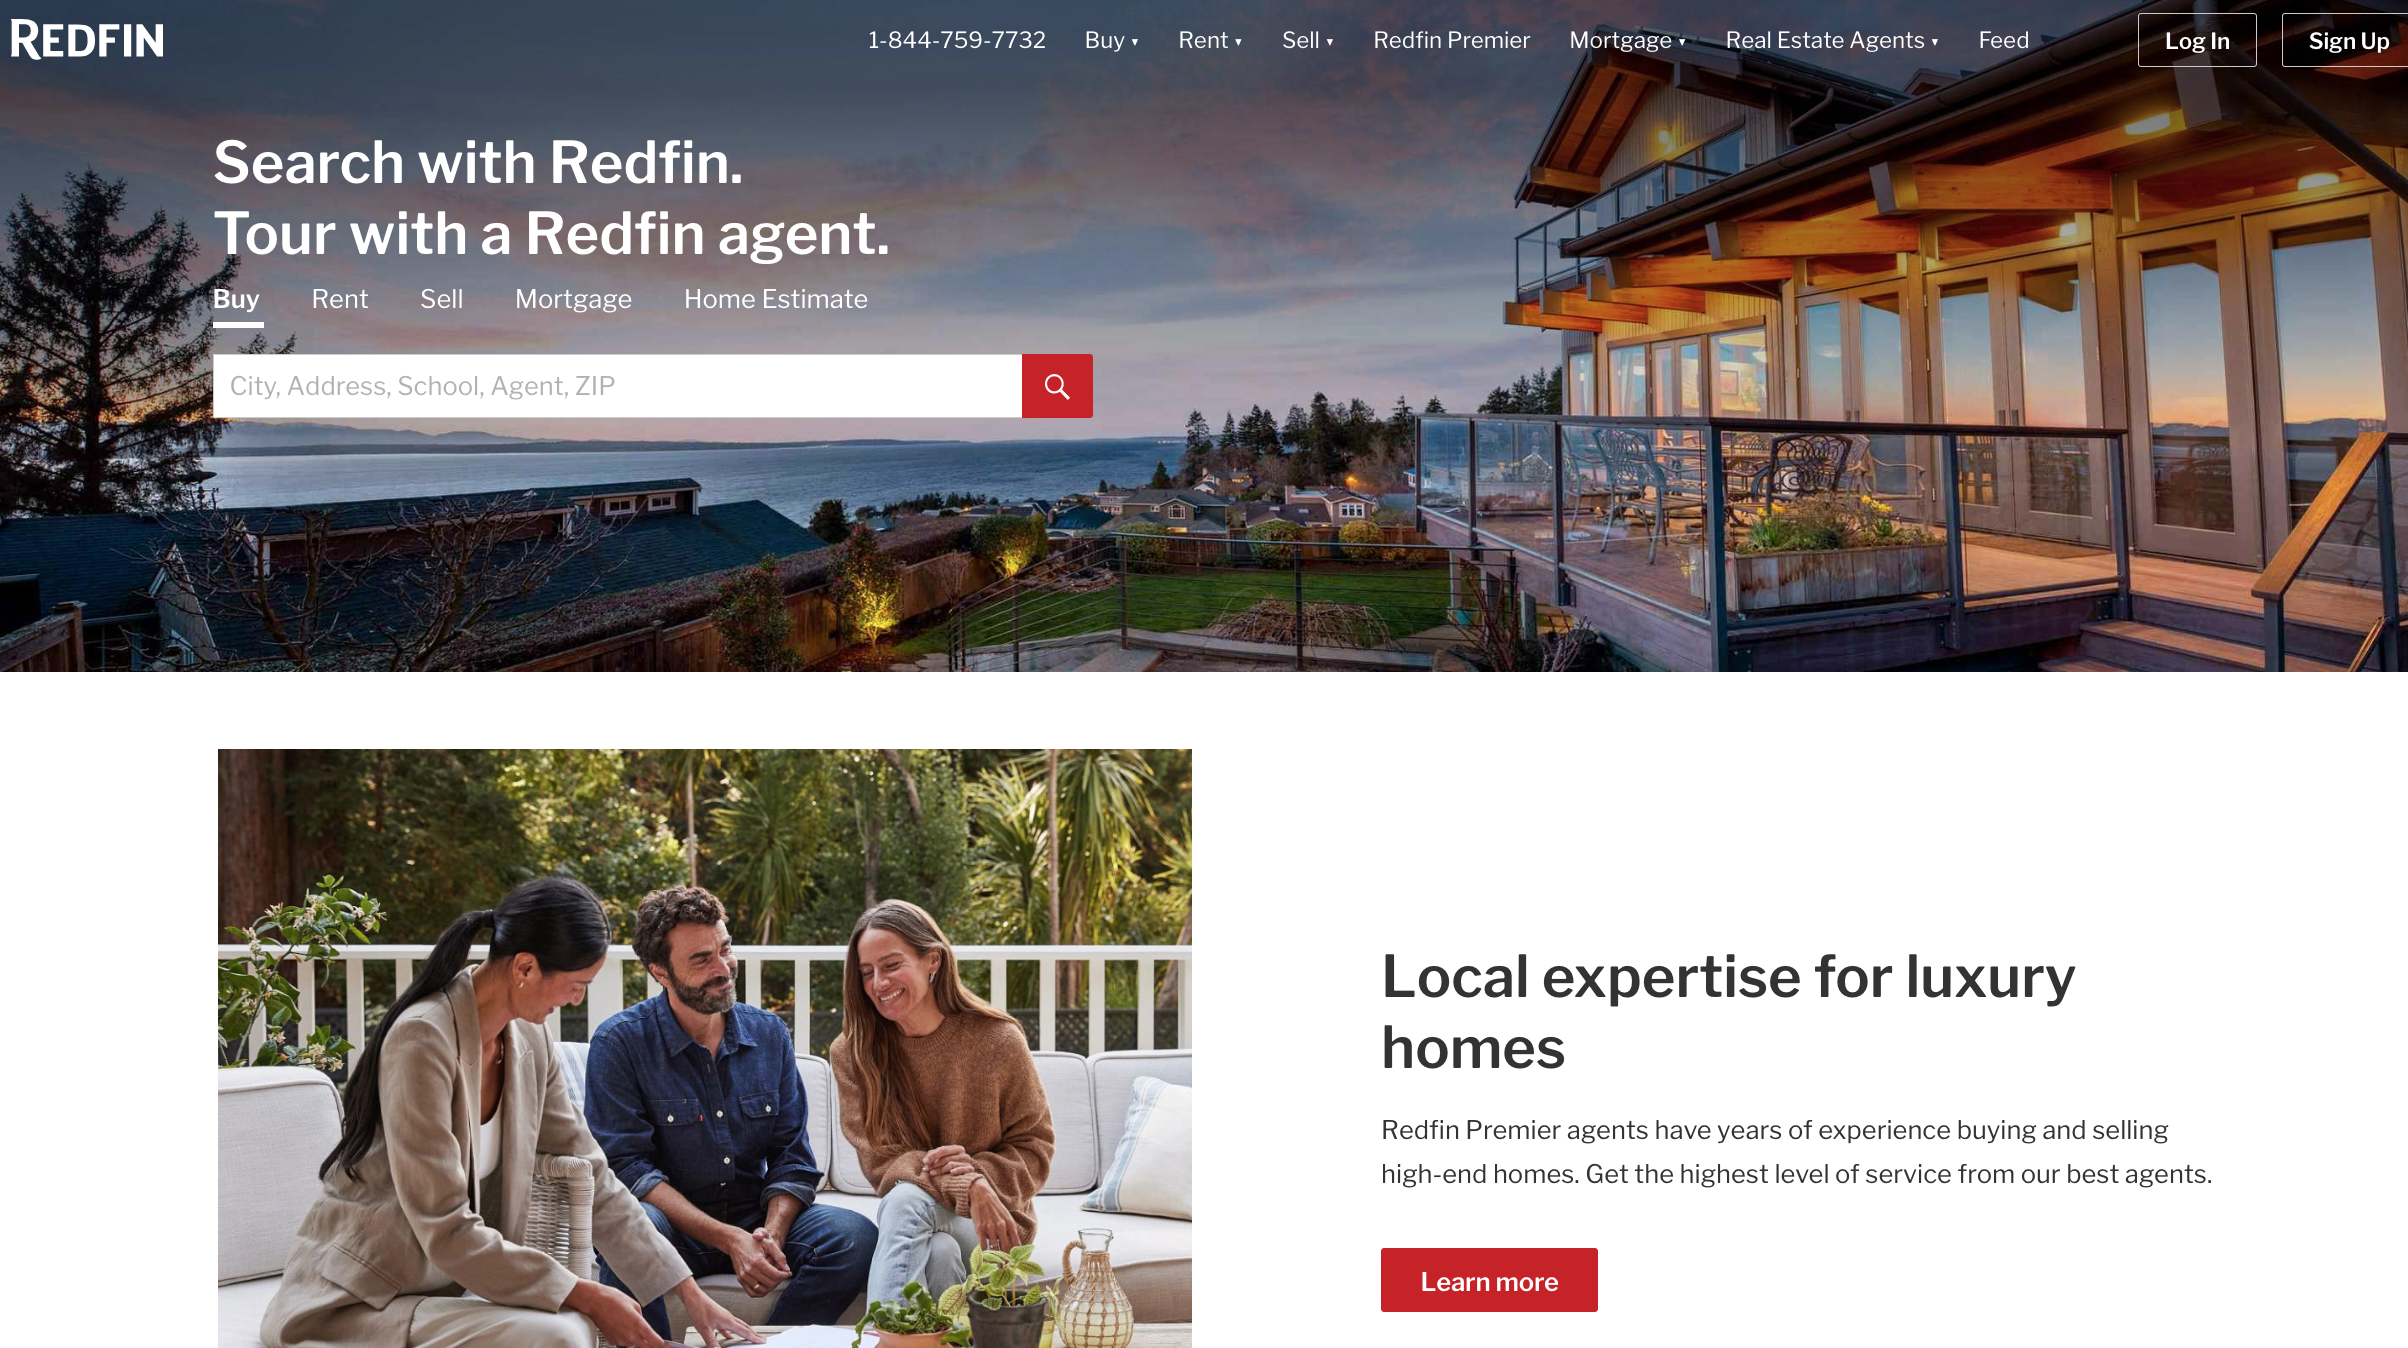
Eines der herausragenden Merkmale von Redfin sind die detaillierten Objektseiten, die umfassende Informationen zu einer Immobilie bieten, darunter hochauflösende Fotos, die Geschichte der Immobilie und Einblicke in die Nachbarschaft.
Darüber hinaus bietet Redfin Tools wie den „Redfin Estimate“, der einen geschätzten Marktwert für Häuser angibt, sowie interaktive Kartensuchen, mit denen Nutzer Immobilien in bestimmten Stadtvierteln oder Regionen erkunden können.
Für Makler, Immobilienvermittler oder Privatpersonen, die Daten zu Immobilienangeboten, Markttrends oder anderen Immobiliendetails sammeln möchten, ist Redfin eine wertvolle Ressource.
Die Bedeutung von Immobiliendaten
Immobiliendaten sind mehr als nur Zahlen und Angebote; sie spiegeln den Puls des Marktes wider.
Jedes inserierte Objekt, jede Preisänderung und jeder Verkauf erzählt eine Geschichte über die Gemeinde, die Wirtschaft und das Verbraucherverhalten.
Durch das Scraping von Redfin, einer der führenden Immobilienplattformen, können Immobilienmakler und Unternehmen auf eine wahre Fundgrube an Daten zugreifen.
Diese Daten können Einblicke in Immobilienwerte, Markttrends und Präferenzen der Bevölkerung bieten.
In einer von Daten geprägten Welt können zeitnahe und genaue Immobilieninformationen für viele Akteure – von Investoren bis hin zu Stadtplanern – entscheidend sein.
Einsatzmöglichkeiten des Redfin-Scrapers in der Marktanalyse
Marktanalysen sind für jedes Unternehmen und jeden Investor, der fundierte Entscheidungen treffen möchte, von entscheidender Bedeutung. Mit den Immobiliendaten von Redfin können Analysten:
- Trends erkennen. Mit einem Immobilien-Scraper lässt sich feststellen, welche Stadtteile an Beliebtheit gewinnen, in welchen das Interesse nachlässt oder wo die Immobilienwerte in die Höhe schnellen.
- Nachfrageanalyse. Das Web-Scraping von Immobiliendaten hilft Maklern zu verstehen, wonach Käufer oder Mieter suchen. Dies kann sich auf die Größe der Immobilie, die Ausstattung, die Nähe zu Schulen oder Arbeitsstätten und vieles mehr beziehen.
- Investitionsentscheidungen. Für Immobilieninvestoren können die Daten realistische Optionen liefern, wo sie als Nächstes kaufen, in welche Art von Immobilien sie investieren oder wann sie verkaufen sollten.
- Politische Entscheidungsfindung. Für Kommunalverwaltungen und Stadtplaner kann das Verständnis des Immobilienmarktes bei Entscheidungen über Infrastrukturentwicklung, Bebauungsvorschriften und Stadterneuerungsprojekte helfen.
Ethische Überlegungen
Auch wenn das Scraping eine Fülle von Daten liefert, ist es unerlässlich, verantwortungsbewusst damit umzugehen. Hier sind einige ethische Leitlinien, die es zu beachten gilt:
Beachten Sie die „robots.txt“-Datei. Diese Datei auf der Redfin-Website gibt an, auf welche Teile der Website zugegriffen und welche Daten dort gescrapt werden dürfen. Sie zu ignorieren ist nicht nur unethisch, sondern kann auch rechtliche Konsequenzen nach sich ziehen.
Überlastung der Server vermeiden. Das Senden zu vieler Anfragen in kurzer Zeit kann die Redfin-Website verlangsamen oder zum Absturz bringen. Es ist unerlässlich, die Anfragen zeitlich zu staffeln, um den Betrieb der Website nicht zu stören.
Datenschutz. Seien Sie stets vorsichtig bei der Verwendung von gescrapten Redfin-Daten, insbesondere wenn diese personenbezogene Daten enthalten. Der Missbrauch solcher Daten kann schwerwiegende rechtliche und ethische Konsequenzen nach sich ziehen.
Verschiedene Methoden zum Scraping von Redfin-Immobiliendaten
Web-Scraping ist zu einer unverzichtbaren Methode geworden, um wertvolle Erkenntnisse aus Online-Quellen wie Redfin zu gewinnen. Hier sind einige verfügbare Tools und Techniken, die jeweils ihre eigenen Stärken und Einschränkungen haben:
Verwendung von Python-Bibliotheken
-
- Requests und BeautifulSoup. Dies ist eine gängige Kombination für das Web-Scraping. „
Requests“ ruft die Webseite ab, und „BeautifulSoup“ analysiert den HTML-Inhalt.
- Scrapy. Ein fortgeschritteneres und leistungsfähigeres Scraping-Framework, das komplexe Scraping-Aufgaben bewältigen kann, darunter die Verwaltung von Sitzungen und Cookies sowie die Simulation von Benutzerinteraktionen.
Nutzung von Web-Scraping-Diensten
-
- ** Scraper API von „Geonode“. Geonode** bietet ein scraper API, mit dem man mit Webseiten interagieren und Daten extrahieren kann. Es ermöglicht Aktionen wie Klicken, Scrollen und Tippen, was beim Scraping dynamischer Inhalte nützlich sein kann.
- Weitere Extraktionsdienste. Es gibt zahlreiche Anbieter, die Scraping-Dienste für Redfin-Immobiliendaten anbieten. Eine kurze Suche hilft Ihnen dabei, die Auswahl einzugrenzen und schließlich den für Ihre Anforderungen am besten geeigneten Anbieter zu finden.
Tools zur Browser-Automatisierung
-
- Selenium: Ein Tool, das in erster Linie zum Testen von Webanwendungen verwendet wird, sich aber auch hervorragend für das Web-Scraping eignet, insbesondere für Websites, die Inhalte dynamisch mithilfe von JavaScript laden.
Manueller Scraping-Prozess
Beim manuellen Scraping werden Daten von einer Website manuell kopiert und in ein gewünschtes Format oder Tool eingefügt.
Diese Methode, auch als Screen Scraping bezeichnet, ist arbeitsintensiv und zeitaufwendig, kann jedoch für kleine Aufgaben oder dann eingesetzt werden, wenn automatisiertes Scraping nicht möglich ist.
Schritt-für-Schritt-Anleitung zum Scraping von Redfin mit Python
Schritt 1: Richten Sie Ihre Umgebung ein
Installieren Sie Python. Stellen Sie sicher, dass Python auf Ihrem System installiert ist. Falls nicht, laden Sie es von der offiziellen Python-Website herunter und installieren Sie es.
Installieren Sie die erforderlichen Bibliotheken. Sie benötigen einige Python-Bibliotheken, die Ihnen beim Scraping helfen. Installieren Sie diese mit pip. 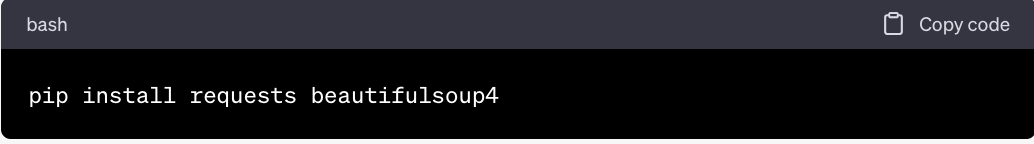
Schritt 2: Ermitteln Sie die zulässigen URLs
Hier finden Sie eine Auswahl der zulässigen Such-URLs aus der robots.txt-Datei von Redfin: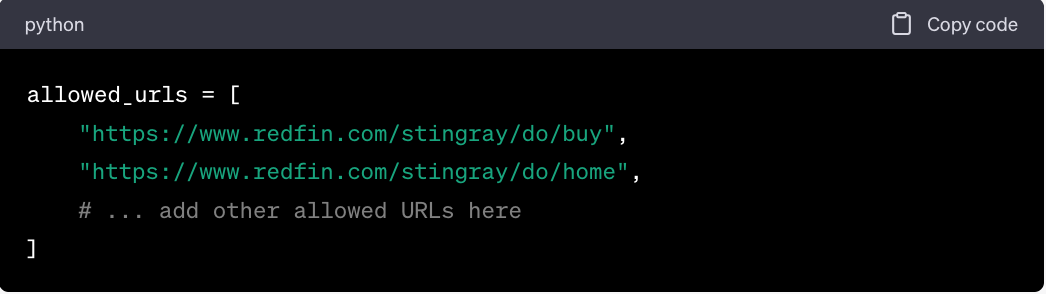
Schritt 3: Den Scraper schreiben
Notwendige Bibliotheken importieren 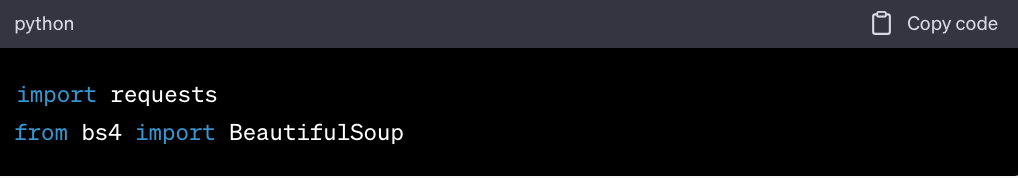
Die Scraper-Funktion definieren 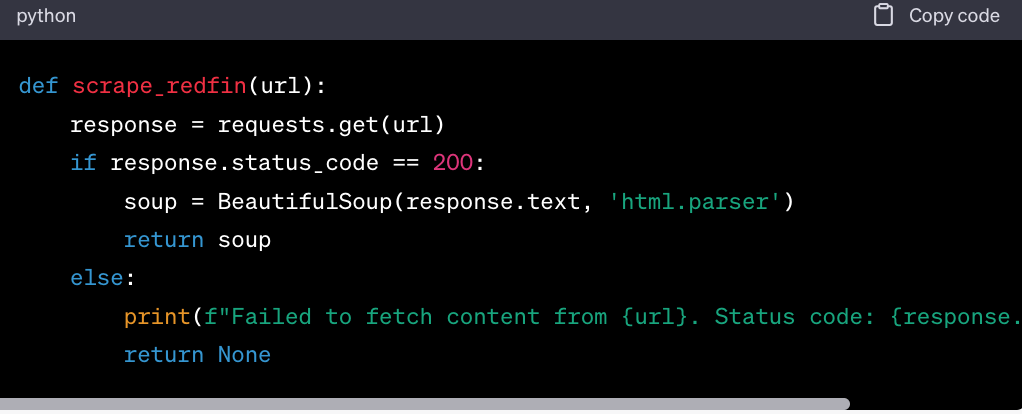
Die zulässigen URLs durchlaufen und Daten auslesen 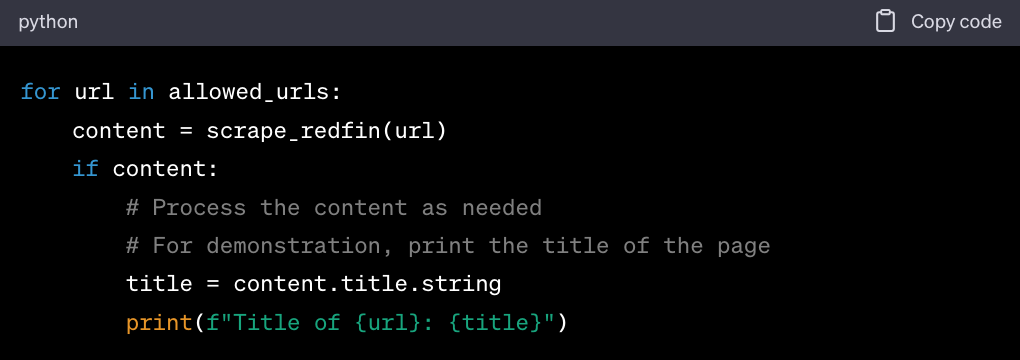
Schritt 4: Die Daten verarbeiten und speichern
Sobald Sie den Inhalt gescrapt haben, können Sie ihn nach Bedarf verarbeiten. Beispielsweise möchten Sie vielleicht bestimmte Datenpunkte extrahieren, die Daten bereinigen oder sie in einer Datenbank oder Datei speichern.
Daten extrahieren. Verwenden Sie Funktionen von BeautifulSoup wie find(), find_all() usw., um bestimmte Daten aus dem gescrapten Inhalt zu extrahieren.
Daten bereinigen. Stellen Sie sicher, dass die Daten im gewünschten Format vorliegen, entfernen Sie unerwünschte Zeichen oder Leerzeichen und bearbeiten Sie fehlende oder inkonsistente Datenpunkte.
Daten speichern. Je nach Bedarf können Sie die Daten in einer Datenbank speichern, in eine CSV-Datei schreiben oder in einem anderen gewünschten Format speichern.
So nutzen Sie Scrapy zum Sammeln von Daten aus Redfin
Schritt 1: Richten Sie Ihre Umgebung ein
Installieren Sie Python. Falls noch nicht geschehen, laden Sie Python von der offiziellen Python-Website herunter und installieren Sie es.
Installieren Sie Scrapy.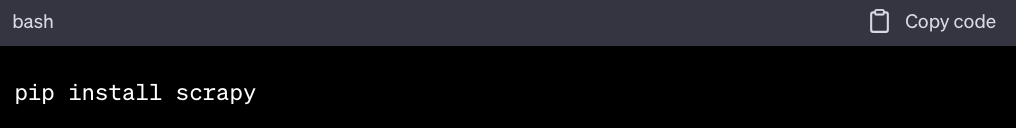
Schritt 2: Erstellen Sie ein Scrapy-Projekt
Öffnen Sie Ihr Terminal oder die Eingabeaufforderung.
Wechseln Sie in das Verzeichnis, in dem Sie Ihr Scrapy-Projekt erstellen möchten.
Führen Sie den folgenden Befehl aus: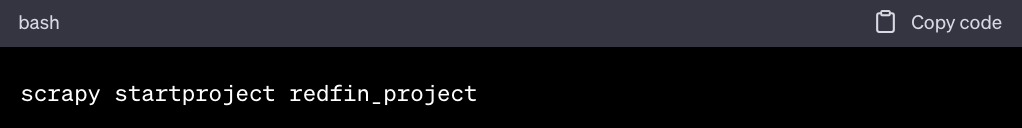
Schritt 3: Den Spider definieren
Wechseln Sie in das Verzeichnis „spiders“ innerhalb des Verzeichnisses „redfin_project“: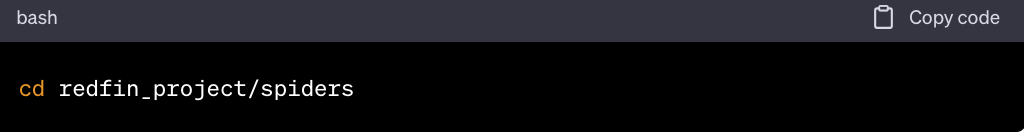
Erstellen Sie eine neue Datei mit dem Namen „redfin_spider.py“.
Öffnen Sie „redfin_spider.py“ in Ihrem bevorzugten Texteditor und fügen Sie den folgenden Code hinzu: 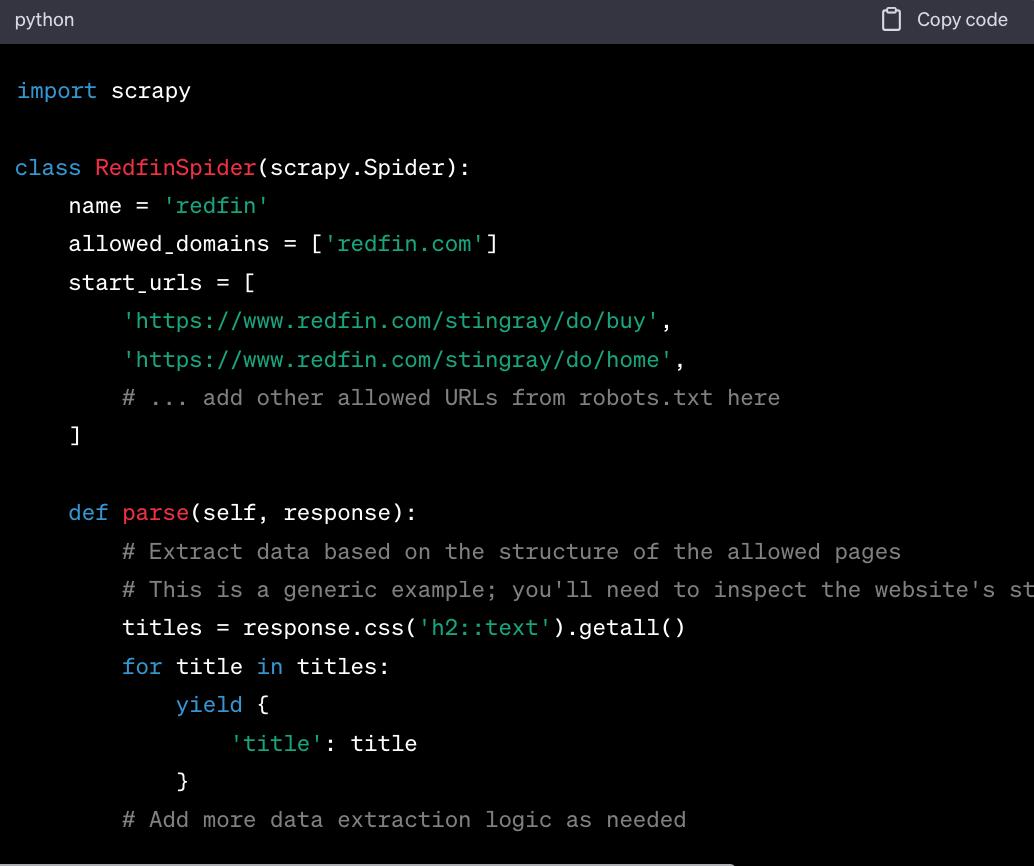
Schritt 4: Scrapy-Einstellungen konfigurieren
Navigieren Sie zurück zum Stammverzeichnis Ihres Scrapy-Projekts (redfin_project).
Öffnen Sie die Datei „settings.py“ in einem Texteditor.
Ändern Sie die folgenden Einstellungen oder fügen Sie sie hinzu, um die „robots.txt“ von Redfin einzuhalten und eine Sperrung zu vermeiden: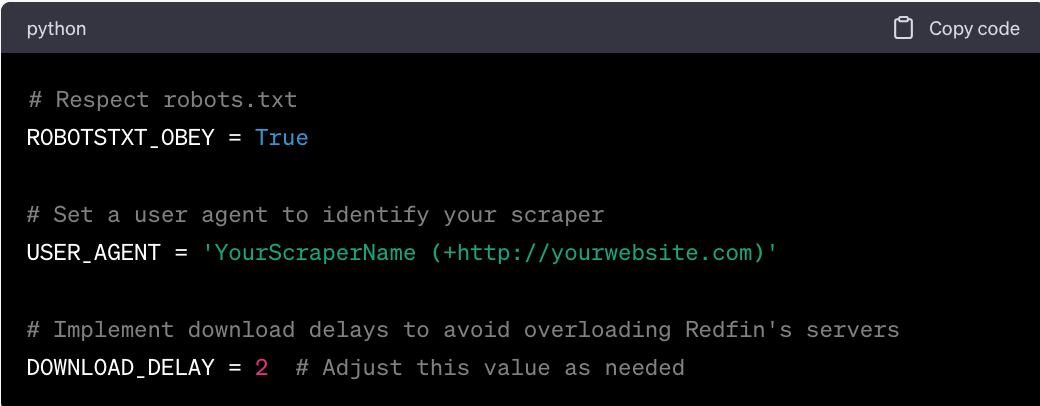
Schritt 5: Den Spider ausführen
Öffne dein Terminal oder die Eingabeaufforderung.
Wechsle in das Stammverzeichnis deines Scrapy-Projekts (redfin_project).
Führe den Spider mit dem folgenden Befehl aus: 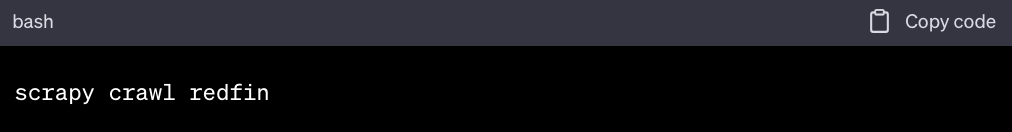
Schritt 6: Die gescrapten Daten speichern
Standardmäßig gibt Scrapy die gescrapten Daten auf der Konsole aus. Wenn Sie die Daten in einer Datei speichern möchten:
Ändern Sie den Befehl wie folgt: 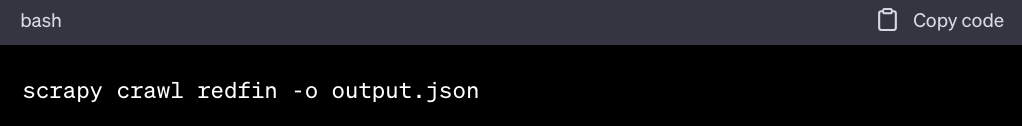
Dadurch werden die gescrapten Daten im JSON-Format in einer Datei namens „output.json“ gespeichert. Sie können auch andere Formate wie CSV verwenden, indem Sie die Dateiendung ändern.
Mit „Geonode“ (Scraper API) Redfin scrapen, ohne gesperrt zu werden
Schritt 1: Richten Sie Ihre Umgebung ein
Python installieren: Falls noch nicht geschehen, laden Sie Python von der offiziellen Python-Website herunter und installieren Sie es.
Erforderliche Bibliotheken installieren: Sie benötigen die Bibliothek „requests“, um API-Aufrufe an Geonodes Scraper API zu senden: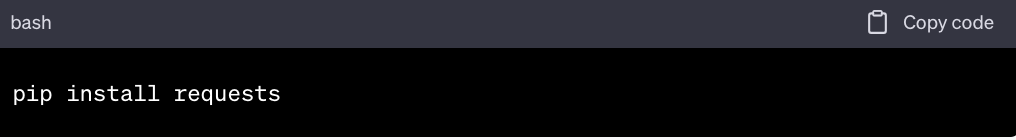
Schritt 2: API-Schlüssel für „Geonode“ abrufen
- Registrieren Sie sich oder melden Sie sich unter Geonode an.
- Rufen Sie Ihre Kontoeinstellungen oder Ihr Dashboard auf, um Ihren API-Schlüssel abzurufen. Dieser Schlüssel wird zur Authentifizierung benötigt, wenn Sie Anfragen an die Scraper API stellen.
Schritt 3: Ermitteln Sie die zulässigen URLs von Redfin
Hier finden Sie eine Auswahl der für das Scraping zulässigen URLs: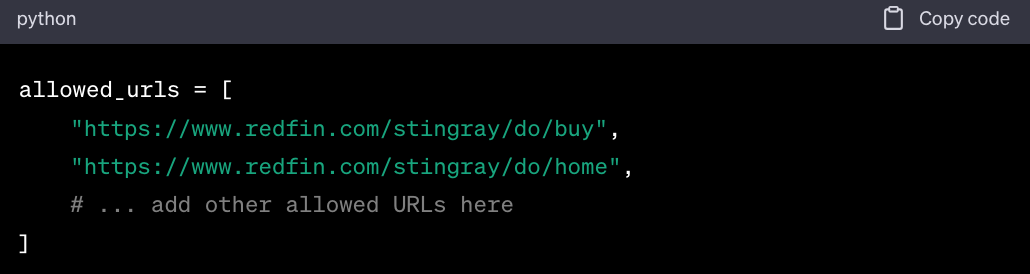
Schritt 4: Das Scraper-Skript schreiben
Erforderliche Bibliotheken importieren:
Die Scraper-Funktion definieren: 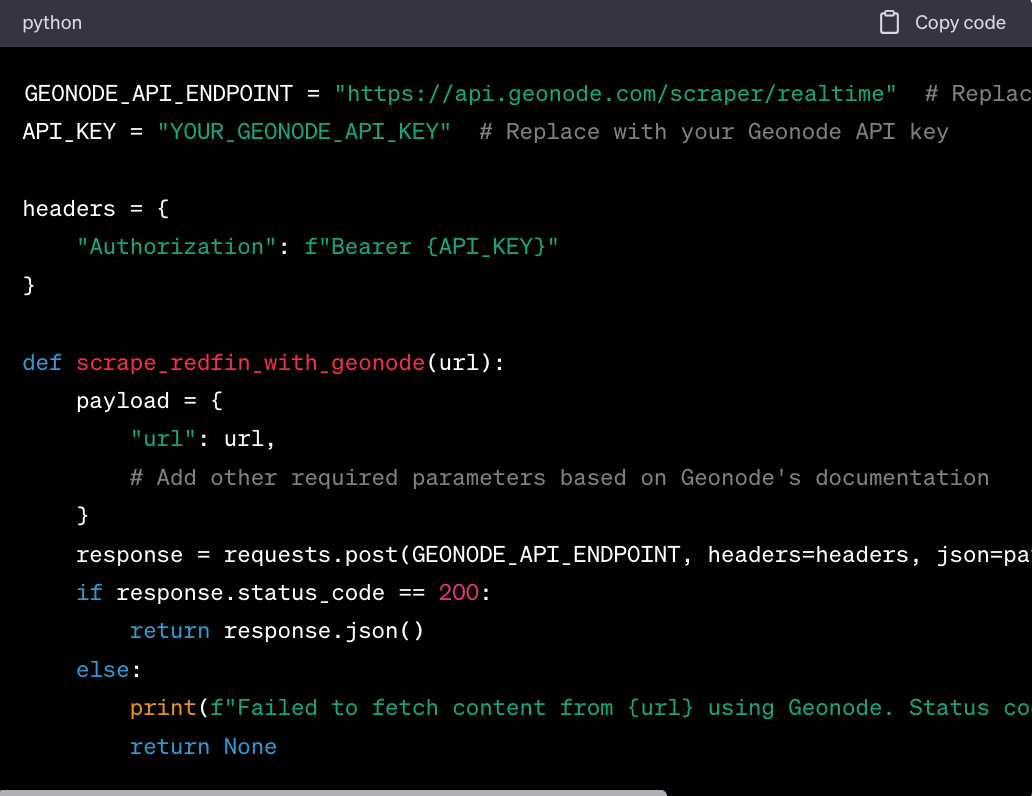
Die zulässigen URLs durchlaufen und Daten auslesen: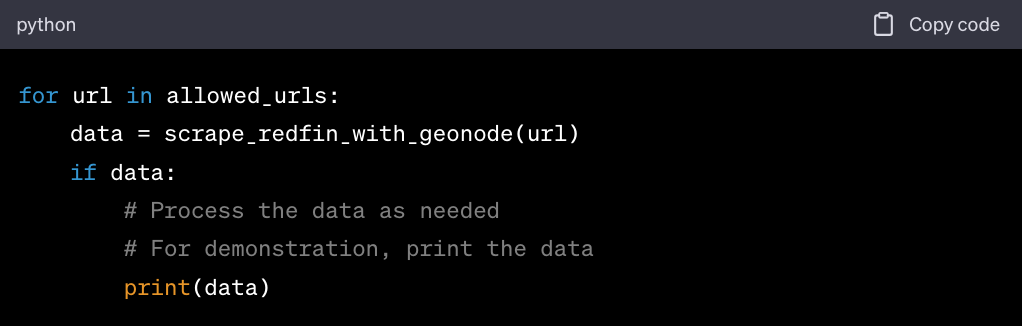
Schritt 5: Die Daten verarbeiten und speichern
Sobald Sie den Inhalt gescrapt haben, können Sie ihn nach Bedarf verarbeiten. Beispielsweise möchten Sie vielleicht bestimmte Datenpunkte extrahieren, die Daten bereinigen oder sie in einer Datenbank oder Datei speichern.
- Daten extrahieren. Je nach Struktur der von Geonode zurückgegebenen Daten müssen Sie diese möglicherweise parsen, um die gewünschten Informationen zu extrahieren.
- Daten bereinigen. Stellen Sie sicher, dass die Daten im gewünschten Format vorliegen, entfernen Sie unerwünschte Zeichen oder Leerzeichen und bearbeiten Sie fehlende oder inkonsistente Datenpunkte.
- Daten speichern. Je nach Bedarf können Sie die Daten in einer Datenbank speichern, in eine CSV-Datei schreiben oder in einem anderen gewünschten Format speichern.
Weitere Schritte nach dem Scraping
Unabhängig davon, welches Redfin-Scraper-Tool Sie verwenden, sollten Sie Folgendes beachten:
-
Überprüfen und verfeinern Sie die Daten. Überprüfen Sie nach dem ersten Scraping die gesammelten Daten. Stellen Sie sicher, dass sie korrekt und vollständig sind.
Verfeinern Sie bei Bedarf Ihre Scraping-Logik, um eventuell fehlende Daten zu erfassen oder die Datenqualität zu verbessern.
-
Führen Sie regelmäßige Überprüfungen durch. Wenn Sie vorhaben, Redfin regelmäßig zu scrapen, überwachen Sie die Leistung Ihres Scrapers und die von ihm gesammelten Daten.
Websites können ihre Struktur ändern, was dazu führen kann, dass Ihr Scraper nicht mehr funktioniert. Durch regelmäßige Überprüfungen können Sie Probleme frühzeitig erkennen und beheben.
Herausforderungen und Lösungen beim Einsatz von Daten-Scrapern für Immobilienportale
Web-Scraping ist ein leistungsstarkes Werkzeug, bringt jedoch eine Reihe von Herausforderungen mit sich, insbesondere bei komplexen Websites wie Redfin.
Umgang mit dynamischen Inhalten
Die Herausforderung: Moderne Websites wie Redfin laden Inhalte dynamisch mithilfe von JavaScript. Herkömmliche Scraping-Tools, die lediglich den HTML-Quellcode abrufen, könnten diese dynamisch geladenen Inhalte übersehen.
Lösungen:
-
Tools zur Browser-Automatisierung. Tools wie Selenium können das Verhalten eines echten Browsers simulieren, sodass Sie dynamisch geladene Inhalte scrapen können.
Mit Selenium können Sie auf das Laden bestimmter Elemente warten, mit Dropdown-Menüs interagieren und sogar durch Seiten scrollen, um das Laden von Inhalten auszulösen.
-
Netzwerkaufrufe überprüfen. Überprüfen Sie mithilfe der Entwicklertools des Browsers die von der Website getätigten Netzwerkaufrufe. Häufig werden dynamische Inhalte über AJAX-Aufrufe an interne APIs geladen.
Wenn Sie diese Aufrufe identifizieren können, können Sie Daten direkt von ihnen anfordern und erhalten diese möglicherweise in einem strukturierten Format wie JSON.
Umgehung von Anti-Scraping-Maßnahmen
Die Herausforderung: Redfin setzt möglicherweise Anti-Scraping-Maßnahmen ein, um zu verhindern, dass automatisierte Bots auf ihre Daten zugreifen. Dazu können CAPTCHAs, Ratenbeschränkungen oder sogar IP-Sperren gehören.
Lösungen:
-
Beachten Sie die Datei „robots.txt.“ Überprüfen Sie immer zuerst die Datei „robots.txt“ der Website. Darin finden Sie Richtlinien dazu, auf welche Teile der Website Webcrawler zugreifen dürfen.
-
User-Agent-Rotation. Wechseln Sie die User-Agents, um verschiedene Browser und Geräte nachzuahmen. Dies kann helfen, Einschränkungen zu umgehen, die auf bestimmte User-Agents abzielen.
-
IP-Rotation. Verwenden Sie Geonode Residential-Proxys, um IP-Adressen zu wechseln. Wenn eine IP gesperrt wird, kann der Scraper auf eine andere umschalten.
-
Ratenbegrenzung. Fügen Sie Verzögerungen zwischen den Anfragen ein, um zu vermeiden, dass zu viele Anfragen in kurzer Zeit gesendet werden. Dies kann dazu beitragen, IP-Sperren zu vermeiden und die Server der Website zu schonen.
-
CAPTCHA-Bearbeitung. Tools wie 2Captcha oder Anti-Captcha bieten Dienste zum Lösen von CAPTCHAs an. Alternativ können Sie Browser-Automatisierungstools einsetzen, um CAPTCHAs manuell zu lösen, sobald sie erscheinen.
Gewährleistung der Datengenauigkeit und -integrität
Die Herausforderung: Web-Scraping kann manchmal zu unvollständigen oder ungenauen Daten führen, insbesondere wenn sich die Struktur der Website ändert oder wenn es Unstimmigkeiten bei der Darstellung der Daten gibt.
Lösungen:
-
Regelmäßige Überwachung. Überwachen Sie kontinuierlich die Leistung Ihres Scrapers. Wenn Sie fehlende oder ungenaue Daten feststellen, kann dies an Änderungen in der Struktur der Website liegen.
-
Fehlerbehandlung. Implementieren Sie eine robuste Fehlerbehandlung in Ihren Scraper. Wenn der Scraper auf einen Fehler stößt, sollte er in der Lage sein, diesen zu protokollieren und fortzufahren oder die Anfrage erneut zu versuchen, um sicherzustellen, dass vorübergehende Probleme nicht zu Datenverlusten führen.
-
Datenvalidierung. Validieren Sie die Daten nach dem Scraping, um sicherzustellen, dass sie bestimmte Kriterien oder Formate erfüllen. Wenn Sie beispielsweise Immobilienpreise scrapen, stellen Sie sicher, dass die Daten numerisch sind und innerhalb eines angemessenen Bereichs liegen.
-
Sicherung. Erstellen Sie stets Sicherungskopien Ihrer gescrapten Daten. Sollten Sie ein Problem mit Ihrem Scraper oder den von ihm gesammelten Daten entdecken, können Sie dank der Sicherungskopien zu einem früheren Zustand zurückkehren.
Indem Sie diese Herausforderungen verstehen und angehen, können Sie sicherstellen, dass Ihre Web-Scraping-Bemühungen erfolgreicher, ethischer und widerstandsfähiger gegenüber der sich ständig weiterentwickelnden Web-Landschaft sind.
Die sich wandelnde Landschaft des Web-Scrapings
Web-Scraping begann als einfaches Mittel, um statische Inhalte aus Webseiten zu extrahieren.
Frühe Websites waren übersichtlich, und um sie zu scrapen, musste man kaum mehr tun, als den HTML-Code herunterzuladen und zu analysieren.
Heute sind Websites wie Redfin dynamisch, interaktiv und voller Funktionen. Sie laden Inhalte in Echtzeit, reagieren auf Nutzerinteraktionen und personalisieren Inhalte sogar basierend auf dem Nutzerverhalten.
Diese Entwicklung hat das Scraping anspruchsvoller, aber auch lohnender gemacht. Moderne Tools und Techniken, von Browser-Automatisierung bis hin zu maschinellem Lernen, sind entstanden, um diesen Herausforderungen gerecht zu werden.
Die Zukunft der Datenextraktion im Immobilienbereich
Der Immobilienmarkt ist dynamisch, und Angebote sowie Preistrends ändern sich rasch. Die Nachfrage nach Echtzeitdaten und verwertbaren Erkenntnissen wird Innovationen bei den Scraping-Technologien vorantreiben und zu einer schnelleren und häufigeren Datenextraktion führen.
Da Daten immer wertvoller werden, werden rechtliche und ethische Überlegungen rund um die Datenextraktion in den Vordergrund rücken.
Wir können mit klareren Richtlinien und Vorschriften rechnen, die regeln, was gescrapt werden darf und was nicht, um sicherzustellen, dass bei der Datenextraktion der Datenschutz und die Rechte an geistigem Eigentum gewahrt bleiben.
Ethisches Handeln
Web-Scraping ist ein leistungsstarkes Werkzeug, doch mit dieser Leistungsfähigkeit geht auch die Pflicht einher, es ethisch zu nutzen. Wenn Sie Websites wie Redfin für Ihre verschiedenen Zwecke scrapen, sollten Sie stets Respekt, Integrität und Fairness in den Vordergrund stellen.
Durch das Scraping stellen Sie sicher, dass das Streben nach Daten niemals die Werte gefährdet, die die digitale Gemeinschaft zusammenhalten.

