¿Estás cansado de buscar entradas para eventos manualmente en SeatGeek? ¿Te gustaría que hubiera una forma de agilizar el proceso y ahorrar tiempo?
Con una amplia selección de entradas disponibles, buscar manualmente las mejores ofertas puede resultar abrumador. Sin embargo, utilizando técnicas de web scraping, puedes automatizar el proceso y recopilar toda la información sobre las entradas que necesitas en cuestión de minutos.
El web scraping es una habilidad muy útil que te permite extraer datos de sitios web y utilizarlos para diversos fines. Al extraer datos de SeatGeek.com, podrás acceder a precios actualizados de las entradas, disponibilidad y otros detalles importantes.
Tanto si eres un asiduo a los conciertos como si te dedicas a la reventa de entradas, aprender a extraer datos de SeatGeek.com te dará una ventaja competitiva y te garantizará que nunca más te pierdas las mejores ofertas.
¿Qué es SeatGeek?
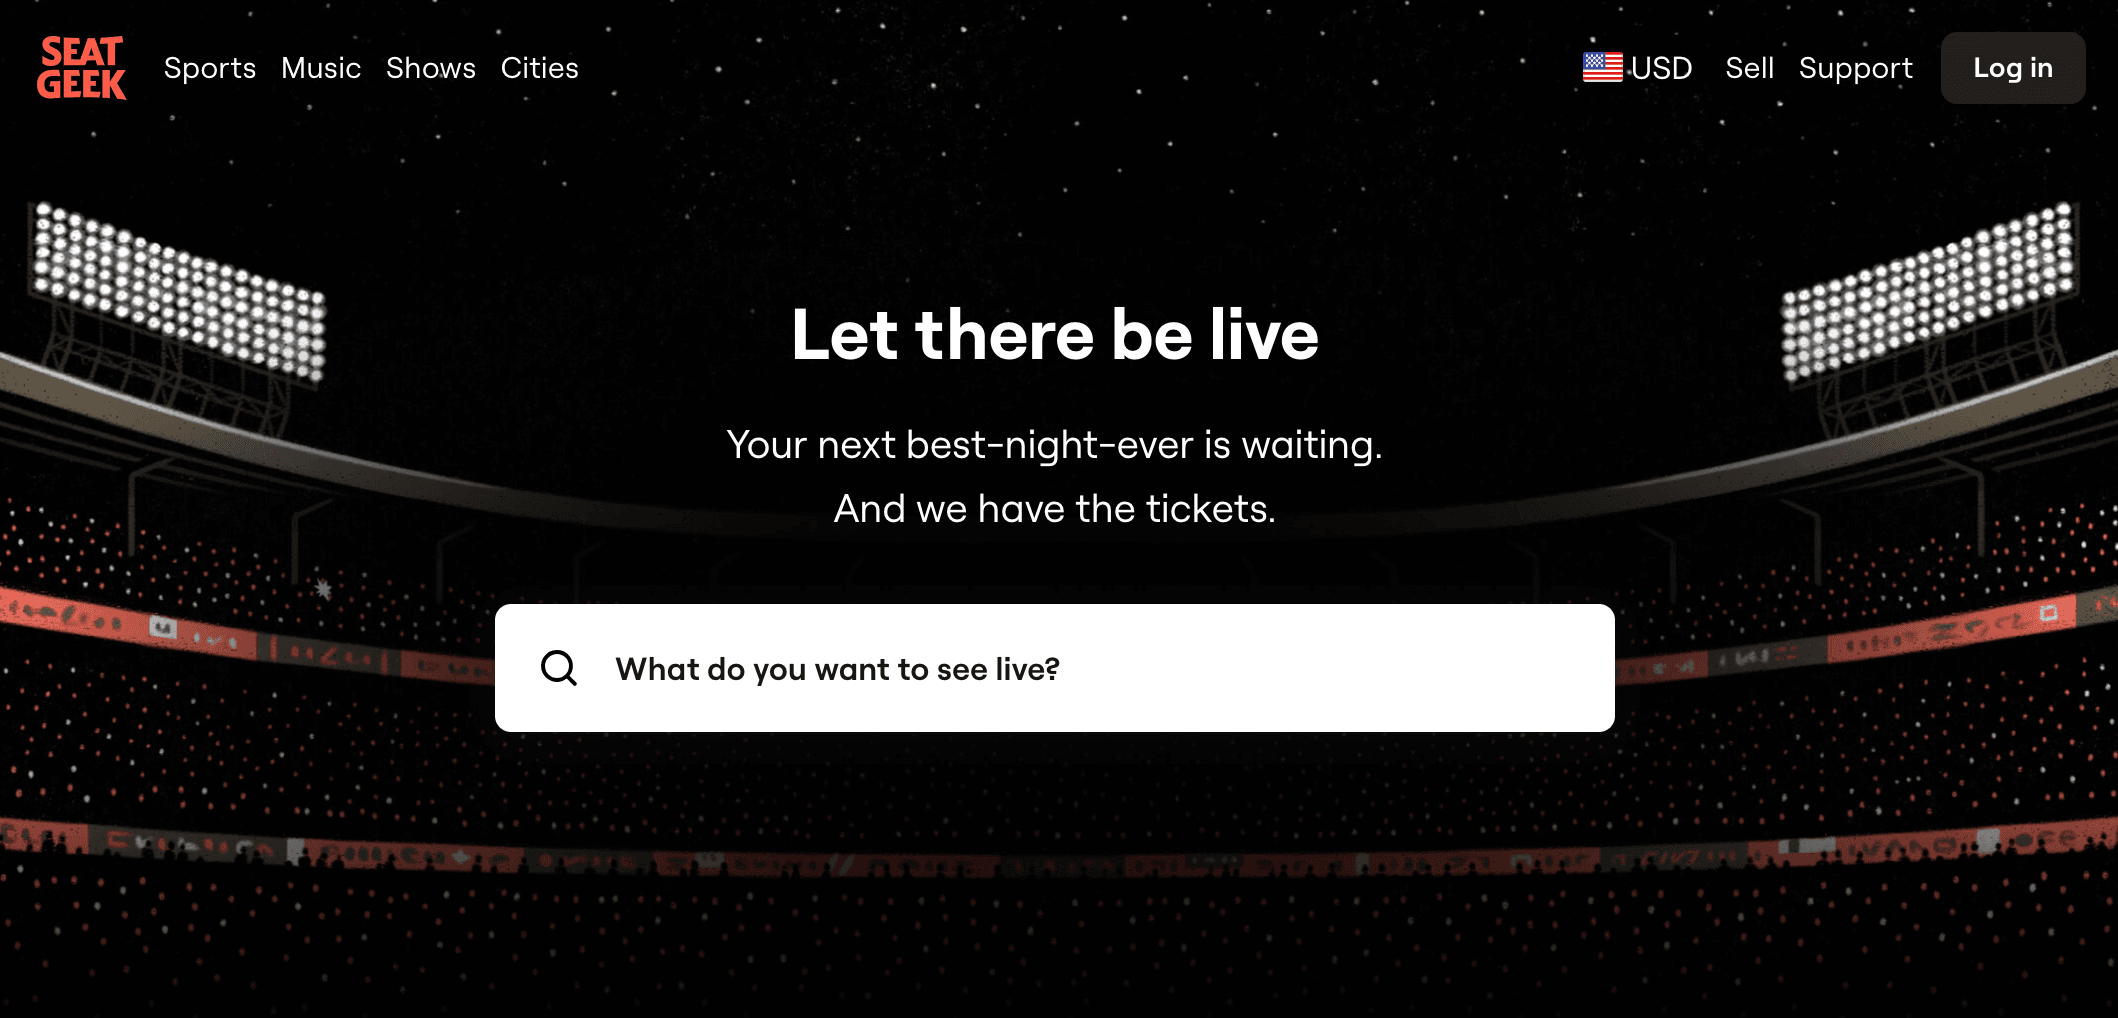
SeatGeek.com es una popular plataforma de venta de entradas en línea que permite a los usuarios comprar y vender entradas para diversos eventos, como conciertos, películas, partidos deportivos y obras de teatro.
Ofrece una plataforma para que los usuarios encuentren las mejores ofertas y comparen precios de diferentes vendedores.
SeatGeek también ofrece funciones como planos interactivos de los asientos, listados de entradas en tiempo real y una aplicación móvil para acceder fácilmente desde cualquier lugar.
La web ha ganado popularidad gracias a su interfaz intuitiva y a sus fiables servicios de venta de entradas, lo que la convierte en la plataforma de referencia para muchos asistentes a eventos.
¿Por qué es tan popular SeatGeek?
SeatGeek, una de las mayores plataformas de agregación de eventos, tanto presenciales como online, se diferencia de otras páginas web de venta de entradas por ofrecer una interfaz intuitiva, precios transparentes y un sistema de «puntuación de ofertas» que evalúa las ofertas de entradas en función del precio y la calidad de los asientos.
 Foto de Pexels
En comparación con otras plataformas de venta de entradas como Ticketmaster, StubHub y Vivid Seats, SeatGeek suele ofrecer un proceso de selección de asientos más visual, con mapas interactivos de los recintos, y agrupa los anuncios de diversas fuentes, lo que proporciona a los usuarios una visión más amplia de las entradas disponibles.
Sin embargo, mientras que Ticketmaster es principalmente un vendedor de entradas de primera mano (directamente del organizador del evento), SeatGeek, StubHub y Vivid Seats operan principalmente en el mercado secundario, donde las entradas se revenden, a menudo a precios determinados por la demanda.
¿Por qué extraer datos de SeatGeek?
SeatGeek es una destacada plataforma en línea que recopila y ofrece entradas para una gran variedad de eventos. Como tal, contiene una gran cantidad de información que puede resultar de interés para diversas partes interesadas por diferentes motivos, tales como:
• Investigación y análisis de mercado. Al extraer datos de SeatGeek, las empresas y los analistas pueden recopilar información sobre las tendencias en los precios de las entradas, la popularidad de los eventos, el aforo de los recintos y mucho más. Estos datos pueden ofrecer una visión de la dinámica del sector del entretenimiento, lo que ayuda a las empresas a tomar decisiones fundamentadas.
• Análisis de la competencia. Las plataformas competidoras o los organizadores de eventos pueden querer conocer los precios de las entradas de SeatGeek, su listado de eventos y otras ofertas para posicionar mejor sus servicios o identificar posibles oportunidades de colaboración.
 Foto de Pexels
• Búsqueda de eventos. Los agregadores de contenido o las plataformas de recomendación de eventos podrían extraer datos de SeatGeek y acceder a los detalles de los eventos para poder ofrecer a sus usuarios una lista completa de las próximas actividades en una región concreta.
• Seguimiento de precios. Al extraer datos de SeatGeek de forma regular, se puede consultar el precio original y fijar el precio de compra para eventos específicos. Esto puede resultar valioso para revendedores de entradas, organizadores de eventos o incluso para consumidores que buscan precios asequibles y las mejores ofertas.
• Integración de datos. Las empresas que operan en el sector de los eventos o el entretenimiento podrían querer integrar los datos de SeatGeek en sus plataformas para ofrecer servicios mejorados a sus usuarios, como recomendaciones de eventos o sugerencias de paquetes de viaje basados en dichos eventos.
• Investigación académica. Los investigadores que estudian la industria del entretenimiento, el comportamiento de los consumidores o la gestión de eventos podrían extraer datos de SeatGeek para recopilarlos en sus estudios.
• Servicios de notificación. Los desarrolladores pueden crear servicios que notifiquen a los usuarios cuando haya entradas disponibles para eventos específicos o dentro de un rango de precios concreto. Esto resulta especialmente útil para eventos muy demandados cuyas entradas se agotan rápidamente.
• Predicción de tendencias. Al analizar los datos históricos de SeatGeek, es posible predecir tendencias futuras en la industria del entretenimiento, como qué tipos de eventos están ganando o perdiendo popularidad.
Los motivos para extraer datos de SeatGeek son diversos y abarcan distintos sectores e intereses. Ya sea para inteligencia empresarial, investigación académica o uso personal, los datos disponibles en SeatGeek ofrecen información valiosa sobre el mundo de los eventos y el entretenimiento.
Comprender la estructura de la página web de SeatGeek
SeatGeek es una plataforma en línea que ofrece un mercado secundario para que los usuarios compren y vendan entradas para diversos eventos. Para extraer datos de SeatGeek de forma eficaz, es fundamental comprender la estructura de la página web y los elementos que se pueden extraer.
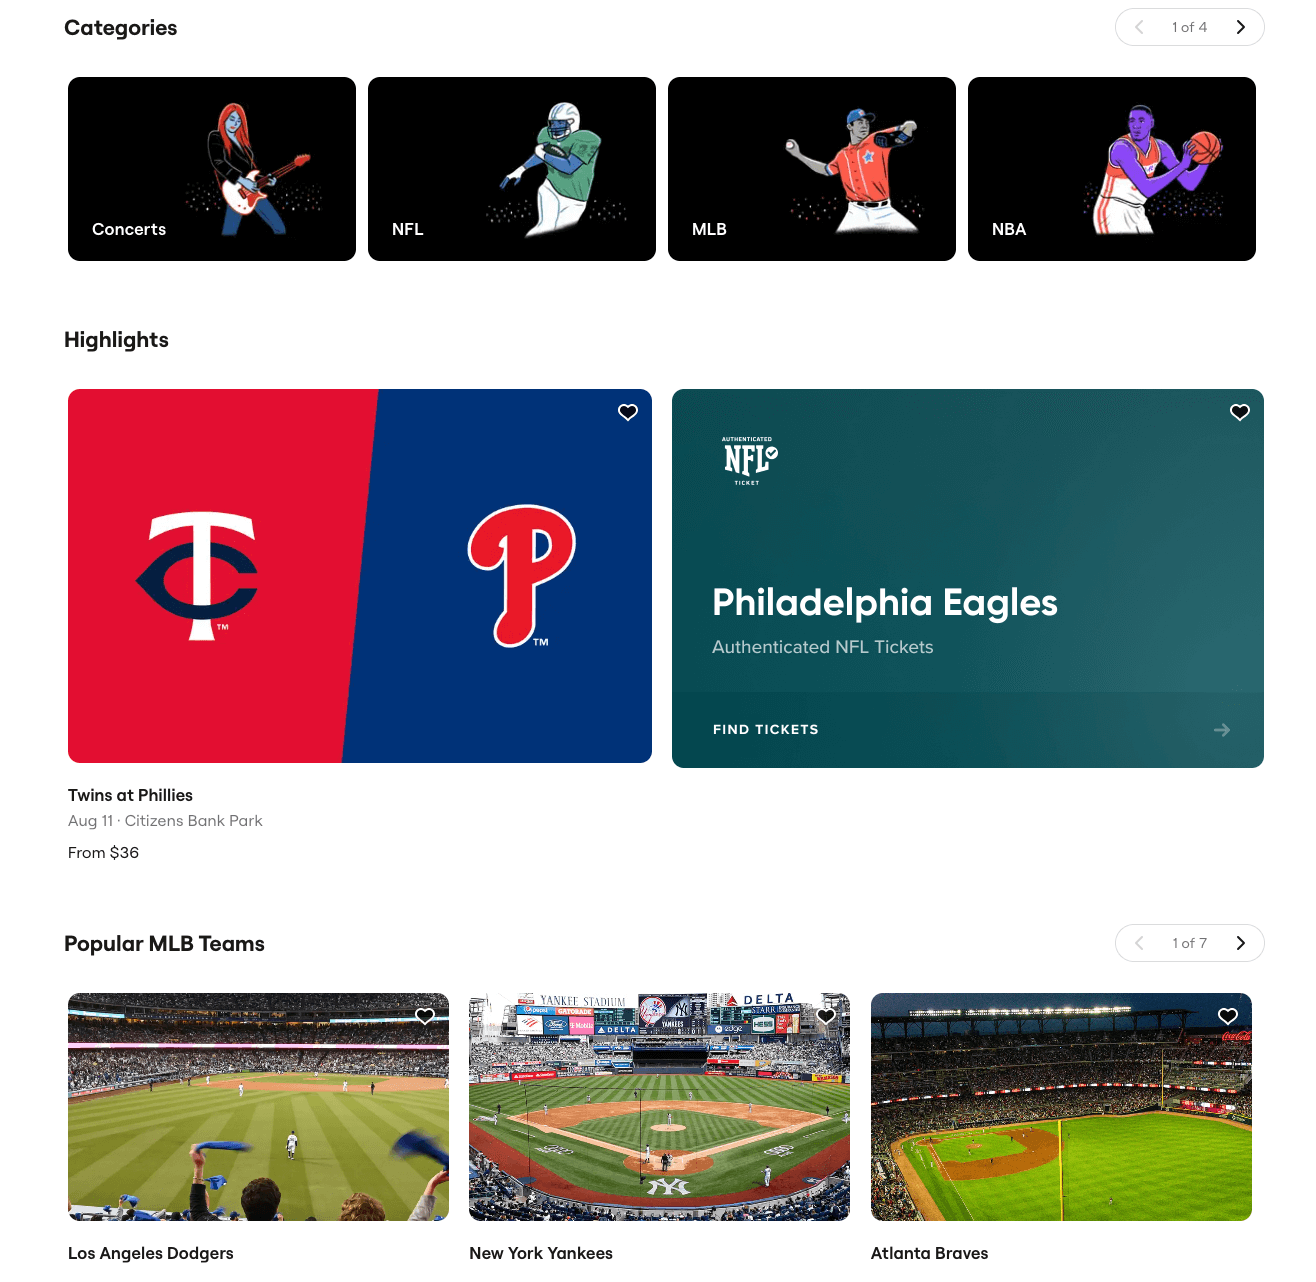
Detalles del evento
Nombre del evento. El nombre o título del evento.
Descripción del evento. Una breve descripción o resumen del evento; también puede incluir datos básicos sobre el mismo.
Categoría del evento. El tipo o categoría del evento (p. ej., concierto, obra de teatro, partido).
Horario del evento. Fechas y horas asociadas al evento.
Servicios de accesibilidad. Instalaciones o servicios disponibles en el recinto del evento.
Detalles de las entradas
Precio de las entradas. Incluye tanto el precio de venta inicial como el final.
Precio original de la entrada. El precio inicial de la entrada cuando salió a la venta por primera vez.
Disponibilidad de entradas. Información sobre el número de entradas disponibles o agotadas.
Detalles del recinto y la ubicación
Dirección. La dirección completa del recinto del evento.
Ciudad. La ciudad donde se celebra el evento.
Código postal. Código postal de la ubicación del evento.
Estado. El estado o región donde se celebra el evento.
Ubicaciones. Ubicaciones o zonas específicas dentro del recinto.

Otros detalles relevantes
Asistentes. Información sobre las personas que asistirán al evento, los organizadores de eventos en línea y más.
Ponentes. Detalles sobre los ponentes o artistas que participan en el evento.
Perfil del organizador. Información sobre los organizadores del evento.
Detalles de los stands. Información sobre los puestos o stands del evento.
Expositores. Detalles sobre los expositores presentes en el evento.
Datos de contacto. Información de contacto relacionada con el evento o sus organizadores.
Opiniones. Comentarios u opiniones relacionados con el evento o el recinto.
Información del vendedor. Nombre y datos de contacto, datos de pago, dirección física y de correo electrónico, así como comentarios y valoración del vendedor.
Restricciones sobre el scraping en SeatGeek
Aunque SeatGeek ofrece una gran cantidad de datos que pueden resultar valiosos para diversos fines, es fundamental abordar el scraping web con precaución, respetando las condiciones de uso de la plataforma y cualquier implicación legal.
Además, esta es la postura del Departamento Jurídico de SeatGeek respecto al scraping web, según sus Condiciones de uso:
• Se permite a los motores de búsqueda públicos utilizar rastreadores para crear índices de búsqueda de los materiales, pero no cachés ni archivos de dichos materiales.
• La información, los contenidos y los servicios disponibles en SeatGeek están protegidos por las leyes de derechos de autor. A los usuarios se les conceden derechos limitados para utilizar los contenidos de SeatGeek, sujetos a ciertas restricciones.
 Foto de Vecteezy
• Los usuarios no pueden utilizar ningún software, dispositivo u otros procesos, ya sean manuales o automatizados, para «extraer» o descargar datos de ninguna página web de SeatGeek. Esto incluye arañas web, robots, extractores de datos, rastreadores, avatares, herramientas de minería de datos, etc.
• Los usuarios no pueden conceder licencias, vender, alquilar ni explotar comercialmente de ningún otro modo las propiedades de SeatGeek. Tampoco pueden modificar, traducir, adaptar ni crear obras derivadas de ninguna parte de las propiedades de SeatGeek.
El «web scraping», aunque útil, conlleva consideraciones éticas y legales. Es fundamental respetar las condiciones de uso de SeatGeek para garantizar que el «scraping» no dañe ni sobrecargue el sitio web.
Además, los datos extraídos deben utilizarse de forma responsable, respetando los derechos de autor o los derechos de propiedad asociados al contenido.
Herramientas para extraer datos de SeatGeek
Existen varios métodos y herramientas que se pueden utilizar para extraer datos de la página web de SeatGeek. A continuación se detallan las diferentes formas de extraer datos de SeatGeek.com:
 Foto de Vecteezy
1. Servicios especializados de extracción de datos web
Existen servicios especializados en la extracción de datos web que ofrecen servicios de extracción de datos de SeatGeek. Estos servicios han desarrollado extractores específicos diseñados para extraer datos de SeatGeek y otras páginas web similares dedicadas a eventos.
2. Scripts personalizados
Disponible en GitHub, Scrapetix es un script diseñado para extraer ofertas de entradas deportivas de SeatGeek. Ofrece funciones como la extracción personalizada de entradas en función de tu equipo favorito, el rango de precios y mucho más. También admite la extracción periódica con notificaciones por correo electrónico cuando hay nuevas ofertas. El script utiliza PhantomJS para ejecutar el proceso de extracción.
3. Herramientas de extracción de datos web
• PhantomJS: Se trata de un navegador sin interfaz gráfica utilizado para la extracción de datos web. Puede renderizar páginas web y ejecutar JavaScript, lo que lo hace adecuado para extraer datos de sitios web dinámicos como SeatGeek, que dependen en gran medida de JavaScript para la visualización de contenidos.
• Node.js: Se trata de un entorno de ejecución de JavaScript que se puede utilizar para escribir scripts del lado del servidor. En combinación con bibliotecas como Axios para realizar peticiones HTTP y Cheerio para analizar HTML, Node.js puede ser una potente herramienta para el scraping web.
• Otras herramientas: Existen muchas otras herramientas y bibliotecas de extracción de datos web disponibles, como Beautiful Soup, Scrapy, Puppeteer y Selenium. Dependiendo de la estructura y la complejidad del sitio web, se puede optar por una herramienta específica en lugar de otra.
4. Navegadores sin interfaz gráfica
Sitios web como SeatGeek pueden cargar contenido de forma dinámica mediante JavaScript. Es posible que las herramientas tradicionales de scraping, que solo recogen el código HTML, no sean capaces de capturar este contenido dinámico. En tales casos, resulta esencial utilizar navegadores sin interfaz gráfica como PhantomJS, Puppeteer o Selenium, que pueden renderizar y ejecutar JavaScript.
Guía paso a paso para extraer datos de SeatGeek con Scrapetix
El script de Scrapetix ofrece un marco de trabajo para extraer datos de SeatGeek. Permite personalizar la extracción de entradas en función de las preferencias del usuario, como el equipo favorito y el rango de precios. El script también admite la extracción periódica con notificaciones por correo electrónico cuando hay nuevas ofertas. Con Scrapetix, puedes editar el archivo de configuración sobre la marcha sin necesidad de reiniciar el script.
1. Requisitos previos
Antes de empezar, asegúrate de que dispones de lo siguiente:
• Una instalación operativa de Node.js.
• Git instalado en tu sistema.
2. Clona el repositorio
Clona el repositorio de Scrapetix desde GitHub a tu equipo local.

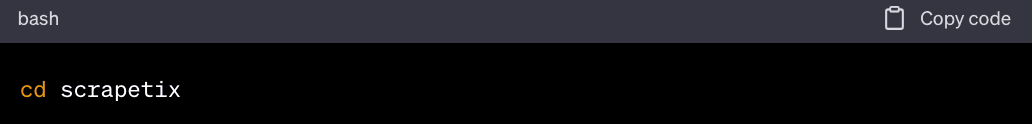
3. Accede al directorio
Cambia tu directorio actual al repositorio clonado.
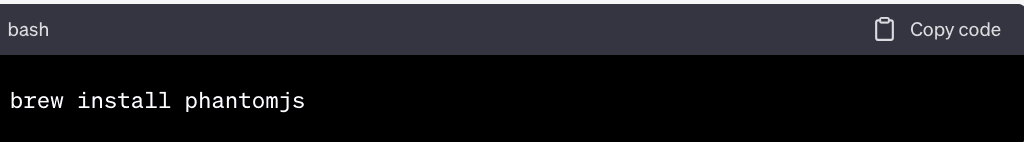
4. Instala PhantomJS
Instala PhantomJS utilizando el método adecuado para tu sistema operativo. Por ejemplo, en macOS, puedes utilizar Homebrew.
5. Instala los paquetes necesarios
Instala los paquetes de Node.js necesarios para el script.

6. Configuración
Configuración del correo electrónico. Para recibir alertas de ofertas por correo electrónico, crea un archivo private.yml en el directorio raíz del proyecto y añade tu información de correo electrónico.
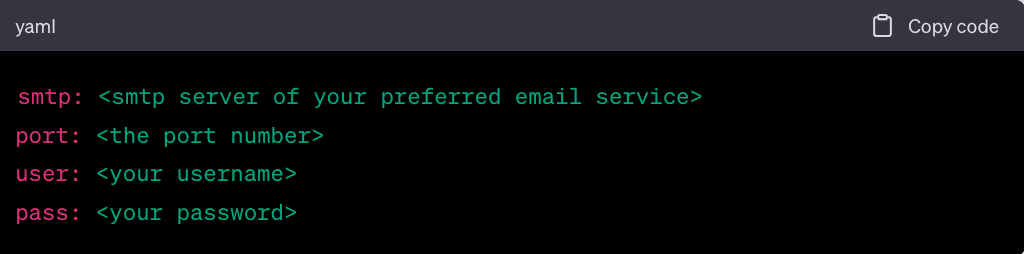
• Configuración personalizada. Modifica el archivo config.yml para establecer tus preferencias.
Configura tu correo electrónico.

Elige la URL de tu equipo favorito. Por ejemplo, la de los Pittsburgh Penguins.

Establece la ubicación en función del nombre del equipo.

Ajusta el intervalo entre dos extracciones consecutivas.

Establece tus criterios de filtrado para las entradas que deseas extraer.

7. Ejecuta el script
Utiliza PhantomJS para ejecutar el script de extracción de datos.

8. Supervisa las alertas
Si el script encuentra ofertas de entradas que se ajusten a tus criterios, enviará alertas por correo electrónico a la dirección especificada.
9. Detener el script
Para detener el script, basta con pulsar CTRL + C en la terminal.
10. Análisis de datos
El script generará datos según tus criterios. Puedes analizar estos datos para encontrar las mejores ofertas de entradas según tus preferencias.
11. Almacenamiento y análisis de los datos extraídos
Una vez extraídos los datos, se pueden almacenar en un archivo CSV, una base de datos u otros sistemas de almacenamiento para su posterior análisis. Los datos se pueden procesar para eliminar el ruido y garantizar que solo se conserve la información relevante y en tiempo real.
Consejos y trucos para realizar un scraping eficaz en SeatGeek
 Foto de Vecteezy
• Comprueba siempre el archivo robots.txt de SeatGeek para saber qué partes del sitio web se pueden rastrear.
• De vez en cuando, deja intervalos adecuados entre las solicitudes para evitar sobrecargar el sitio web o que te bloqueen.
• Actualiza periódicamente el script de scraping para adaptarlo a cualquier cambio en la estructura del sitio web.
• Utiliza filtros y criterios para asegurarte de que solo se extraen los datos relevantes.
• Evita las restricciones alternando los agentes de usuario y tu dirección IP. Geonode ofrece proxies residenciales ilimitados y pay-as-you-go que puedes utilizar para distribuir las solicitudes.
¿Listo para el web scraping en SeatGeek?
La enorme cantidad de datos disponibles en motores de búsqueda de entradas para eventos como SeatGeek ofrece un tesoro de información valiosa para diversos grupos de interés, desde los aficionados a los eventos hasta los analistas de mercado.
El web scraping, cuando se realiza de forma ética y responsable, puede desvelar esta información y proporcionar una ventaja competitiva en el mundo de los eventos y el entretenimiento, en constante evolución.
Con las herramientas y técnicas adecuadas, cualquiera puede aprovechar estos datos con fines valiosos. Sin embargo, recuerda siempre abordar el web scraping respetando los servicios, las directrices de la plataforma y las consideraciones legales. A medida que el panorama de los datos en línea sigue creciendo, también lo hace el potencial de innovación y descubrimiento.

