

Scrapy es un marco de trabajo de código abierto para el rastreo web que cualquiera puede utilizar de forma gratuita en Internet. Scrapy se utiliza principalmente para el rastreo web y el web scraping. Es una forma rápida y sencilla de extraer datos de cualquier página web, y actualmente Zyte se encarga de su mantenimiento.
Instalación de Scrapy
Para instalar Scrapy, necesitas una versión de Python 3.7 o superior. También se recomienda instalarlo en un entorno virtual dedicado (virtualenv), para evitar cualquier conflicto que pueda surgir con los paquetes de tu sistema.
Descarga Scrapy en tu plataforma preferida.
Para instalar Scrapy, debes instalar Anaconda o Miniconda, abrir Python y ejecutar el comando:
conda install -c conda-forge scrapy
Como alternativa, también puedes ejecutar:
pip install Scrapy
Si utilizas un sistema Ubuntu, primero debes instalar todas estas dependencias:
sudo apt-get install python3 python3-dev python3-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
Si utilizas un sistema macOS, tendrás que instalar las herramientas de línea de comandos de Xcode. Abre una ventana de terminal y ejecuta:
xcode-select --install
¡Enhorabuena! Ya has instalado Scrapy en tu dispositivo. Ahora podemos probar a rastrear una página web y extraer sus datos.
Iniciar un proyecto de Scrapy
Para iniciar un nuevo proyecto de Scrapy, debes indicar el directorio en el que deseas que se guarde tu código. Debes ejecutar:
scrapy startproject scrapetest
Al ejecutar este comando, se creará un directorio llamado «scrapetest» que contendrá lo siguiente:
_scrapetest/ scrapy.cfg # archivo de configuración de despliegue
scrapetest/             # módulo Python del proyecto; desde aquí importarás tu código
    __init__.py

    items.py

    middlewares.py

    pipelines.py

    settings.py

    spiders/          # un directorio donde más adelante colocarás tus arañas
        __init__.py
_
Una vez iniciado un proyecto de Scrapy, ahora tienes que crear una araña (spider). Una araña es necesaria porque es la que utiliza Scrapy para extraer información de una página web. A modo de ejemplo, vamos a rastrear la página web «quotes.toscrape.com».
En primer lugar, debes ejecutar el código:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" # Los nombres de las arañas deben ser únicos para cada araña que crees
def start_requests(self):
    urls = [
        'https://quotes.toscrape.com/page/1/',
        # Cambia estas URL por
las páginas web que quieras rastrear 'https://quotes.toscrape.com/page/2/', ] for url in urls: yield scrapy.Request(url=url, callback=self.parse)
def parse(self, response):
    page = response.url.split("/")[-2]
    filename = f'quotes-{page}.html'
    with open(filename, 'wb') as f:
        f.write(response.body)
    self.log(f'Archivo guardado {filename}')
_
Para que el rastreador comience a rastrear, debes ejecutar:
scrapy crawl test
A continuación, deberías obtener un resultado que indique que has rastreado el sitio web «quotes.toscrape.com».
Si quieres extraer determinados datos de una página web, puedes utilizar la palabra clave «yield» de Python y ejecutar el código:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', 'https://quotes.toscrape.com/page/2/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }
_
Este código extrae los textos, el autor y las etiquetas de la página web que has rastreado, que se mostrarán en el registro.
Si quieres rastrear todas las páginas de un sitio web, en lugar de solo páginas específicas, puedes ejecutar:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }

    next_page = response.css('li.next a::attr(href)').get()
    if next_page is not None:
        next_page = response.urljoin(next_page)
        yield scrapy.Request(next_page, callback=self.parse)
_
Ahora, tienes que almacenar los datos que ha extraído la araña. Para guardar los datos extraídos, simplemente ejecuta:
scrapy crawl test -O test.json
Si quieres añadir cualquier contenido nuevo a un archivo ya existente, puedes ejecutar este código en su lugar:
scrapy crawl quotes -o quotes.jsonl
¡Enhorabuena! Has terminado de extraer y almacenar los datos que has recopilado con Scrapy. Aún puedes añadir algo para garantizar que el scraping web con Scrapy se realice con éxito, y es utilizar los proxies de Scrapy.
Configuración de los proxies de Scrapy
Un proxy de Scrapy se encargará de gestionar todas tus solicitudes web, por lo que cualquier sitio web del que extraigas datos solo podrá ver la dirección IP del servidor proxy. Tu dirección IP quedará completamente oculta. Al rotar continuamente las direcciones IP y utilizar proxies residenciales, se engañará a los sitios web para que crean que tus solicitudes proceden de usuarios reales y no de alguien que utiliza un bot de rastreo web como Scrapy.
A modo de ejemplo, utilizaremos un proxy de Geonode. Puedes pasar directamente a «Obtener los datos del servidor proxy con Geonode» si aún no has obtenido los datos de tu proxy de Geonode.
Hay dos métodos para configurar un proxy en Scrapy.
El primer método consiste en utilizar el middleware de Scrapy, denominado HTTPProxyMiddleware, que configura automáticamente tu parámetro de proxy como proxy predeterminado.
Puedes ejecutar:
_def start_requests(self): for url in self.start_urls: return Request(url=url, callback=self.parse, headers={"User-Agent": "My UserAgent"}, meta={"proxy": "premium-residential.geonode.com:9001"}) _
El segundo método consistiría en crear tu propio middleware. Este método es más aislado y te ofrece un mayor grado de libertad.
Puedes ejecutar:
_from w3lib.http import basic_auth_header
DOWNLOADER_MIDDLEWARES = { 'myproject.middlewares.CustomProxyMiddleware': 350, 'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 400, }
class CustomProxyMiddleware(object): def process_request(self, request, spider): request.meta[“proxy”] = "premium-residential.geonode.com:9001" request.headers[“Proxy-Authorization”] = basic_auth_header(“geonode_xbYe9H2LYr”, “9806022c-cd4a-4776-a053-73fee44344dd”) _
¡Enhorabuena! Ya has añadido un servidor proxy para rastrear cualquier sitio web con Scrapy. Si quieres comprobar si tu proxy funciona, puedes visitar https://www.geonode.com/what-is-my-ip.
Cómo obtener los datos del servidor proxy con Geonode
Paso 1. Entra en **Geonode
** e inicia sesión con tu cuenta actual o regístrate para crear una nueva.
Paso 2. En la página de inicio, haz clic en «Servicios residenciales».

Paso 3. Desplázate hacia abajo hasta que veas «Puntos finales».
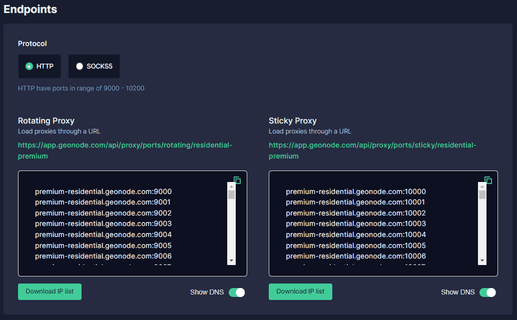
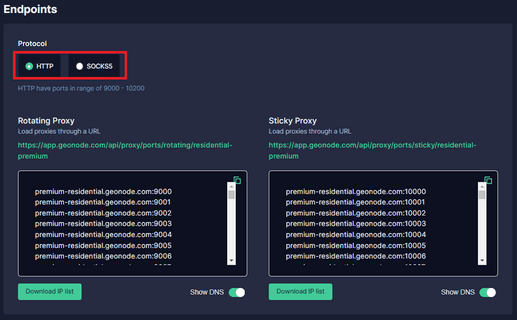
Paso 4. Elige qué «Protocolo de proxy» deseas utilizar: «Protocolo HTTP» o **«[Protocolo SOCKS5
](https://geonode.com/blog/beginners-guide-to-socks5-proxies)»**.
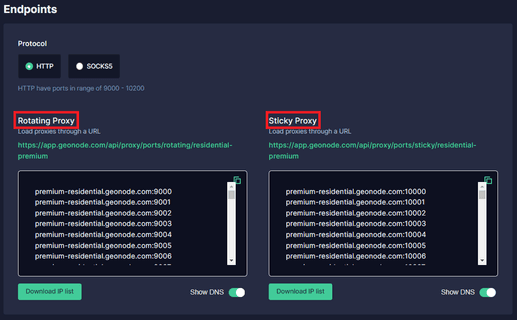
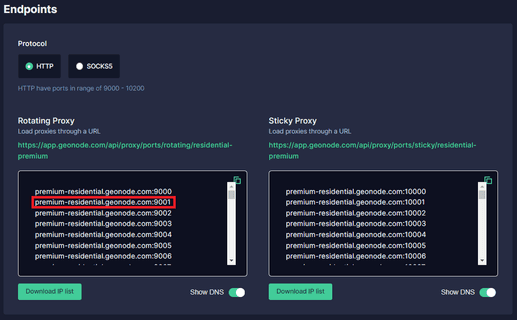
Paso 5. Selecciona qué «Tipo de sesión» deseas utilizar: «Proxy rotativo» o Proxy fijo.
Paso 6. Elige qué proxy quieres utilizar. A modo de ejemplo, utilizaremos el proxy resaltado **«premium-residential.geonode
.com:9001»**.
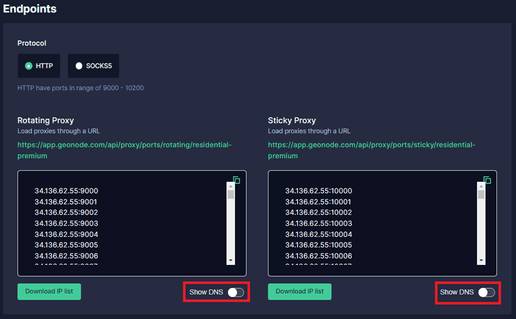
Si quieres utilizar una dirección IP en lugar de un DNS, simplemente desactiva el botón «Mostrar DNS» y aparecerán las direcciones IP.
Paso 7. Ahora necesitas los «Datos de autenticación» de tu cuenta de proxy. En el caso de Geonode
, se encuentran en la página de inicio de tu cuenta.
