Vous en avez assez de rechercher manuellement des billets pour des événements sur SeatGeek ? Vous aimeriez pouvoir simplifier ce processus et gagner du temps ?
Avec un vaste choix de billets disponibles, il peut être fastidieux de rechercher manuellement les meilleures offres. Cependant, en utilisant des techniques de web scraping, vous pouvez automatiser le processus et rassembler toutes les informations dont vous avez besoin en quelques minutes.
Le web scraping est une compétence précieuse qui vous permet d’extraire des données de sites web et de les utiliser à diverses fins. En effectuant du web scraping sur SeatGeek.com, vous pouvez accéder aux prix actualisés des billets, à leur disponibilité et à d’autres détails importants.
Que vous soyez un habitué des concerts ou un revendeur de billets, apprendre à effectuer du web scraping sur SeatGeek.com vous donnera un avantage concurrentiel et vous garantira de ne plus jamais passer à côté des meilleures offres.
Qu'est-ce que SeatGeek ?
SeatGeek.com est une plateforme de vente de billets en ligne très populaire qui permet aux utilisateurs d’acheter et de vendre des billets pour divers événements tels que des concerts, des films, des matchs et des pièces de théâtre.
Elle offre aux particuliers un espace où trouver les meilleures offres et comparer les prix proposés par différents vendeurs.
SeatGeek propose également des plans de salle interactifs, des listes de billets en temps réel et une application mobile pour un accès facile où que vous soyez.
Le site a gagné en popularité grâce à son interface conviviale et à ses services de billetterie fiables, ce qui en fait une plateforme incontournable pour de nombreux amateurs d'événements.
Pourquoi SeatGeek est-il si populaire ?
SeatGeek, l’un des plus grands sites agrégateurs d’événements, tant en présentiel qu’en ligne, se distingue des autres sites de billetterie en proposant une interface conviviale, une tarification transparente et un système de « Deal Score » qui évalue les offres de billets en fonction du prix et de la qualité des places.
 Photo de Pexels
Par rapport à d’autres plateformes de billetterie telles que Ticketmaster, StubHub et Vivid Seats, SeatGeek propose souvent un processus de sélection des places plus visuel grâce à des plans interactifs des salles et regroupe les annonces provenant de diverses sources, offrant ainsi aux utilisateurs une vue d’ensemble plus complète des billets disponibles.
Cependant, alors que Ticketmaster est avant tout un vendeur de billets sur le marché primaire (en direct de l’organisateur de l’événement), SeatGeek, StubHub et Vivid Seats opèrent principalement sur le marché secondaire, où les billets sont revendus, souvent à des prix déterminés par la demande.
Pourquoi exploiter SeatGeek ?
SeatGeek est une plateforme en ligne de premier plan qui regroupe et propose des billets pour une multitude d’événements. À ce titre, elle recèle une mine d’informations susceptibles d’intéresser diverses parties prenantes pour différentes raisons, telles que :
• Études de marché et analyses. En effectuant un scraping de SeatGeek, les entreprises et les analystes peuvent recueillir des données sur les tendances des prix des billets, la popularité des événements, la capacité d’accueil des salles, etc. Ces données peuvent fournir des informations sur la dynamique du secteur du divertissement, aidant ainsi les entreprises à prendre des décisions éclairées.
• Analyse concurrentielle. Les plateformes concurrentes ou les organisateurs d’événements peuvent souhaiter comprendre la tarification des billets, les listes d’événements et les autres offres de SeatGeek afin de mieux positionner leurs services ou d’identifier des opportunités de partenariat potentielles.
 Photo provenant de Pexels
• Découverte d’événements. Les agrégateurs de contenu ou les plateformes de recommandation d’événements pourraient extraire les données de SeatGeek et accéder aux détails des événements afin de proposer à leurs utilisateurs une liste complète des activités à venir dans une région donnée.
• Suivi des prix. En effectuant régulièrement des extractions de données sur SeatGeek, il est possible de connaître le prix d’origine et de fixer le prix d’achat pour des événements spécifiques. Cela peut s’avérer utile pour les revendeurs de billets, les organisateurs d’événements ou même les consommateurs à la recherche de prix abordables et des meilleures offres.
• Intégration de données. Les entreprises opérant dans le secteur de l’événementiel ou du divertissement peuvent souhaiter intégrer les données de SeatGeek à leurs plateformes afin d’offrir des services améliorés à leurs utilisateurs, tels que des recommandations d’événements ou des suggestions de forfaits voyage en fonction des événements.
• Recherche universitaire. Les chercheurs qui étudient l’industrie du divertissement, le comportement des consommateurs ou la gestion d’événements peuvent extraire des données de SeatGeek afin d’alimenter leurs études.
• Services de notification. Les développeurs peuvent créer des services qui informent les utilisateurs lorsque des billets pour des événements spécifiques ou dans une fourchette de prix donnée deviennent disponibles. Cela s’avère particulièrement utile pour les événements très prisés qui affichent rapidement complet.
• Prévision des tendances. En analysant les données historiques de SeatGeek, il est potentiellement possible de prévoir les tendances futures dans l’industrie du divertissement, par exemple quels types d’événements gagnent ou perdent en popularité.
Les raisons de « scraper » SeatGeek sont diverses et couvrent différents secteurs et centres d’intérêt. Que ce soit à des fins de veille économique, de recherche universitaire ou d’usage personnel, les données disponibles sur SeatGeek offrent des informations précieuses sur le monde des événements et du divertissement.
Comprendre la structure du site web de SeatGeek
SeatGeek est une plateforme en ligne qui propose un marché secondaire permettant aux utilisateurs d’acheter et de vendre des billets pour divers événements. Pour extraire efficacement des données de SeatGeek, il est essentiel de comprendre la structure du site web et les éléments pouvant être extraits.
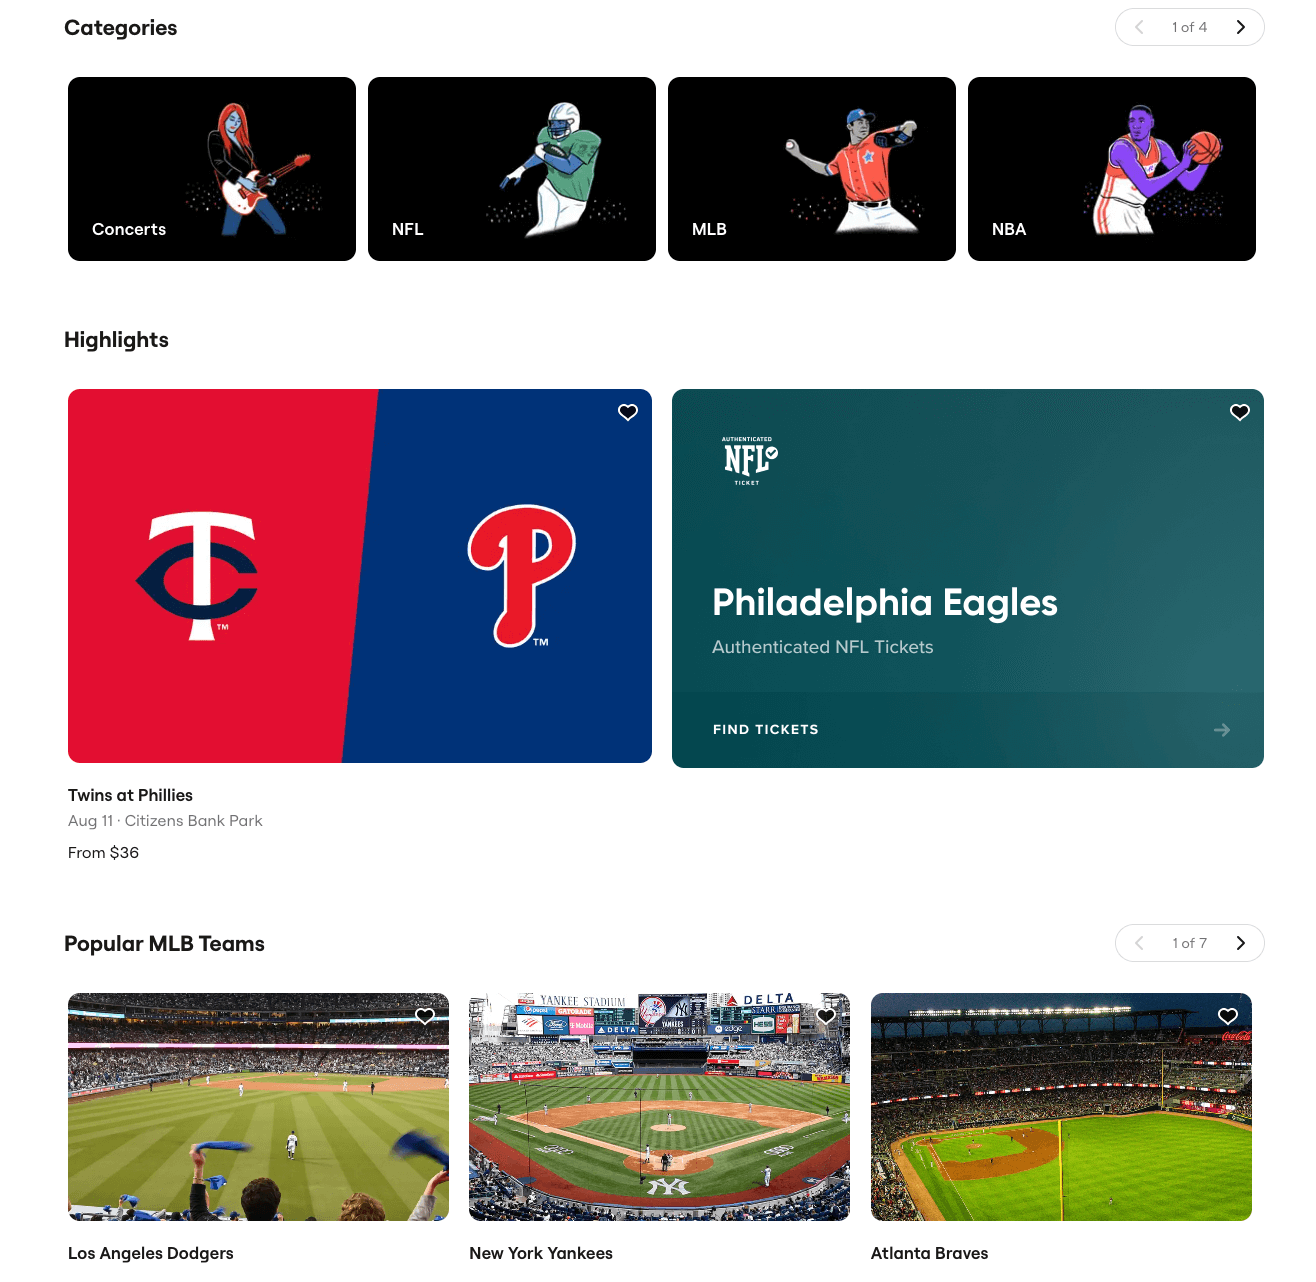
Détails de l'événement
Nom de l'événement. Le nom ou le titre de l'événement.
Description de l'événement. Une brève description ou un résumé de l'événement ; peut également inclure des informations succinctes sur l'événement.
Catégorie de l’événement. Le type ou la catégorie de l’événement (par exemple, concert, pièce de théâtre, match).
Calendrier de l’événement. Les dates et heures associées à l’événement.
Équipements accessibles. Les installations ou services disponibles sur le lieu de l’événement.
Détails des billets
Prix des billets. Cela inclut à la fois le prix de vente initial et le prix de vente final.
Prix initial du billet. Le prix initial du billet lors de sa mise en vente.
Disponibilité des billets. Informations sur le nombre de billets disponibles ou épuisés.
Détails du lieu et de l’emplacement
Adresse. L’adresse complète du lieu de l’événement.
Ville. La ville où se déroule l’événement.
Code postal. Le code postal du lieu de l’événement.
Région. La région où se trouve le lieu de l’événement.
Emplacements. Emplacements ou zones spécifiques au sein du lieu de l’événement.

Autres détails pertinents
Participants. Informations sur les personnes participant à l’événement, les organisateurs d’événements en ligne, etc.
Intervenants. Informations sur les intervenants ou les artistes participant à l'événement.
Profil de l'organisateur. Informations sur les organisateurs de l'événement.
Détails des stands. Informations sur les stands présents lors de l'événement.
Exposants. Informations sur les exposants présents à l'événement.
Coordonnées. Coordonnées relatives à l'événement ou à ses organisateurs.
Avis. Commentaires ou avis relatifs à l'événement ou au lieu.
Informations sur le vendeur. Nom et coordonnées, informations de paiement, adresse postale et e-mail, ainsi que les commentaires et la note attribués au vendeur.
Restrictions relatives au scraping sur SeatGeek
Bien que SeatGeek propose une multitude de données pouvant s'avérer précieuses à diverses fins, il est essentiel de pratiquer le scraping avec prudence, en respectant les conditions d'utilisation de la plateforme et en tenant compte de toutes les implications juridiques.
De plus, voici la position du service juridique de SeatGeek concernant le scraping, telle qu'elle figure dans ses Conditions d'utilisation :
• Les moteurs de recherche publics sont autorisés à utiliser des robots d'indexation pour créer des index consultables des contenus, mais ne peuvent pas créer de cache ni d'archives de ces contenus.
• Les informations, le contenu et les services disponibles sur SeatGeek sont protégés par les lois sur le droit d’auteur. Les utilisateurs se voient accorder des droits limités d’utilisation des propriétés de SeatGeek, sous réserve de certaines restrictions.
 Photo de Vecteezy
• Les utilisateurs ne peuvent utiliser aucun logiciel, dispositif ou autre processus, qu’il soit manuel ou automatisé, pour « extraire » ou télécharger des données à partir de pages web de SeatGeek. Cela inclut les robots d’indexation, les robots, les scrapers, les crawlers, les avatars, les outils d’exploration de données, etc.
• Les utilisateurs ne peuvent pas concéder de licence, vendre, louer ou exploiter commercialement de quelque manière que ce soit les propriétés de SeatGeek. Ils ne peuvent pas non plus modifier, traduire, adapter ou créer des œuvres dérivées de toute partie des propriétés de SeatGeek.
Bien que l'extraction de données (web scraping) soit utile, elle soulève des questions d'ordre éthique et juridique. Il est essentiel de respecter les conditions d'utilisation de SeatGeek afin de s'assurer que cette extraction ne nuise pas au site web et ne le surcharge pas.
De plus, les données extraites doivent être utilisées de manière responsable, dans le respect des droits d'auteur et des droits de propriété associés au contenu.
Outils pour extraire des données de SeatGeek
Il existe plusieurs méthodes et outils permettant d’extraire des données du site web de SeatGeek. Voici un aperçu des différentes façons d’extraire des données de SeatGeek.com :
 Photo de Vecteezy
1. Services spécialisés dans l’extraction de données Web
Il existe des services spécialisés dans l’extraction de données Web qui proposent des solutions pour extraire les données de SeatGeek. Ces services ont développé des scrapers spécifiques conçus pour extraire des données de SeatGeek et d’autres sites d’événements similaires.
2. Scripts personnalisés
Disponible sur GitHub, Scrapetix est un script conçu pour extraire les offres de billets de sport sur SeatGeek. Il propose des fonctionnalités telles que l’extraction personnalisée de billets en fonction de votre équipe préférée, de votre fourchette de prix, et plus encore. Il prend également en charge l’extraction récurrente avec des notifications par e-mail pour les nouvelles offres. Le script utilise PhantomJS pour exécuter le script d’extraction.
3. Outils de scraping Web
• PhantomJS : il s’agit d’un navigateur sans interface utilisateur (headless) utilisé pour le scraping Web. Il peut afficher des pages Web et exécuter du JavaScript, ce qui le rend adapté au scraping de sites Web dynamiques comme SeatGeek, qui s’appuient fortement sur JavaScript pour l’affichage de leur contenu.
• Node.js : il s’agit d’un environnement d’exécution JavaScript permettant d’écrire des scripts côté serveur. Associé à des bibliothèques telles qu’Axios pour effectuer des requêtes HTTP et Cheerio pour analyser le code HTML, Node.js peut constituer un outil puissant pour le scraping web.
• Autres outils : Il existe de nombreux autres outils et bibliothèques de web scraping, tels que Beautiful Soup, Scrapy, Puppeteer et Selenium. En fonction de la structure et de la complexité du site web, on peut privilégier un outil plutôt qu’un autre.
4. Navigateurs sans interface graphique
Des sites web comme SeatGeek peuvent charger du contenu de manière dynamique à l’aide de JavaScript. Les outils de scraping traditionnels, qui se contentent de récupérer le code HTML, peuvent ne pas être en mesure de capturer ce contenu dynamique. Dans de tels cas, il devient indispensable d’utiliser des navigateurs sans interface graphique tels que PhantomJS, Puppeteer ou Selenium, capables d’afficher et d’exécuter du code JavaScript.
Guide étape par étape pour extraire des données de SeatGeek avec Scrapetix
Le script Scrapetix fournit un cadre permettant d’extraire des données de SeatGeek. Il permet de personnaliser l’extraction de billets en fonction des préférences de l’utilisateur, telles que son équipe préférée et sa fourchette de prix. Le script prend également en charge l’extraction récurrente avec des notifications par e-mail pour les nouvelles offres. Avec Scrapetix, vous pouvez modifier le fichier de configuration à la volée sans avoir à redémarrer le script.
1. Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
• Une installation fonctionnelle de Node.js.
• Git installé sur votre système.
2. Cloner le dépôt
Clonez le dépôt Scrapetix depuis GitHub sur votre machine locale.

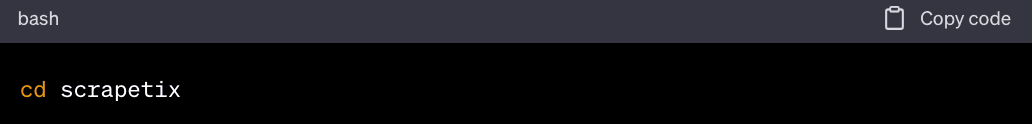
3. Accéder au répertoire
Accédez au répertoire du dépôt cloné.
4. Installez PhantomJS
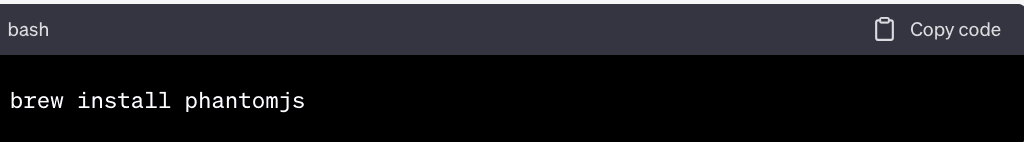
Installez PhantomJS en utilisant la méthode adaptée à votre système d’exploitation. Par exemple, sous macOS, vous pouvez utiliser Homebrew.
5. Installez les paquets requis
Installez les paquets Node.js nécessaires au fonctionnement du script.

6. Configuration
Configuration de la messagerie. Pour recevoir des alertes d’offres par e-mail, créez un fichier private.yml dans le répertoire racine du projet et ajoutez vos coordonnées e-mail.
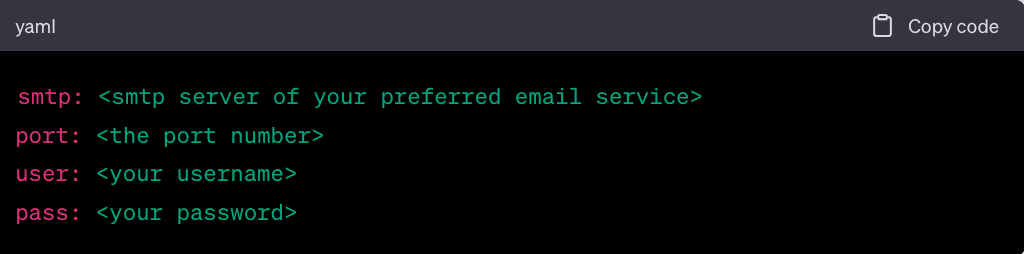
• Configuration personnalisée. Modifiez le fichier config.yml pour définir vos préférences.
Configurez votre adresse e-mail.

Choisissez l’URL de votre équipe préférée. Par exemple, pour les Pittsburgh Penguins.

Définissez la localisation en fonction du nom de l’équipe.

Ajustez l’intervalle entre deux collectes consécutives.

Définissez vos critères de filtrage pour les billets que vous souhaitez collecter.

7. Exécuter le script
Utilisez PhantomJS pour exécuter le script de scraping.

8. Surveiller les alertes
Si le script trouve des offres de billets correspondant à vos critères, il enverra des alertes par e-mail à l'adresse e-mail indiquée.
9. Arrêt du script
Pour arrêter le script, il suffit d’appuyer sur CTRL + C dans le terminal.
10. Analyse des données
Le script générera des données en fonction de vos critères. Vous pouvez analyser ces données pour trouver les meilleures offres de billets correspondant à vos préférences.
11. Stockage et analyse des données extraites
Une fois les données extraites, elles peuvent être stockées dans un fichier CSV, une base de données ou d’autres systèmes de stockage en vue d’une analyse plus approfondie. Les données peuvent être traitées pour éliminer le bruit et garantir que seules les informations pertinentes et en temps réel soient conservées.
Conseils et astuces pour réussir le scraping sur SeatGeek
 Photo de Vecteezy
• Vérifiez toujours le fichier robots.txt de SeatGeek pour savoir quelles parties du site peuvent être scrapées.
• De temps à autre, respectez des intervalles appropriés entre les requêtes pour éviter de surcharger le site web ou d’être bloqué.
• Mettez régulièrement à jour le script de scraping afin de l’adapter à toute modification de la structure du site web.
• Utilisez des filtres et des critères pour vous assurer que seules les données pertinentes sont extraites.
• Contournez les restrictions en alternant les user agents et votre adresse IP. Geonode propose des proxys résidentiels illimités et pay-as-you-go que vous pouvez utiliser pour répartir vos requêtes.
Prêt à faire du web scraping sur SeatGeek ?
La quantité considérable de données disponibles sur les moteurs de recherche de billets d’événements tels que SeatGeek constitue une véritable mine d’informations pour divers acteurs, des passionnés d’événements aux analystes de marché.
Le web scraping, lorsqu’il est pratiqué de manière éthique et responsable, permet d’exploiter ces informations et d’offrir un avantage concurrentiel dans le monde en constante évolution des événements et du divertissement.
Avec les bons outils et les bonnes techniques, tout le monde peut exploiter ces données à des fins utiles. Cependant, n’oubliez jamais d’aborder le web scraping dans le respect des services concernés, ainsi que des directives de la plateforme et des considérations juridiques. À mesure que l’univers des données en ligne continue de s’étendre, le potentiel d’innovation et de découverte s’accroît également.

