

Scrapy est un framework open source de crawling Web accessible gratuitement à tous les internautes. Scrapy est principalement utilisé pour le crawling Web et le web scraping. Il s'agit d'un moyen rapide et simple d'extraire des données de n'importe quelle page Web ; Zyte en assure actuellement la maintenance.
Installation de Scrapy
Pour installer Scrapy, vous devez disposer d’une version de Python 3.7 ou supérieure. Il est également recommandé de l’installer dans un environnement virtuel dédié (virtualenv), afin d’éviter tout conflit éventuel avec les paquets de votre système.
Téléchargez Scrapy sur votre plateforme préférée.
Pour installer Scrapy, vous devez installer Anaconda ou Miniconda, ouvrir Python, puis exécuter la commande suivante :
conda install -c conda-forge scrapy
Vous pouvez également exécuter :
pip install Scrapy
Si vous utilisez un système Ubuntu, vous devez d’abord installer toutes ces dépendances :
sudo apt-get install python3 python3-dev python3-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
Si vous utilisez un système macOS, vous devez installer les outils de ligne de commande Xcode. Ouvrez une fenêtre de terminal et exécutez :
xcode-select --install
Félicitations ! Vous avez installé Scrapy sur votre appareil. Nous pouvons désormais essayer d'explorer un site web et d'en extraire les données.
Lancer un projet Scrapy
Pour lancer un nouveau projet Scrapy, vous devez indiquer le répertoire dans lequel vous souhaitez enregistrer votre code. Vous devez exécuter la commande suivante :
scrapy startproject scrapetest
L'exécution de cette commande créera un répertoire nommé « scrapetest » contenant les éléments suivants :
_scrapetest/ scrapy.cfg # fichier de configuration de déploiement
scrapetest/             # module Python du projet, c'est à partir de là que vous importerez votre code
    __init__.py

    items.py

    middlewares.py

    pipelines.py

    settings.py

    spiders/          # répertoire dans lequel vous placerez ultérieurement vos spiders
        __init__.py
_
Après avoir lancé un projet Scrapy, vous devez maintenant créer un spider. Un spider est indispensable, car c’est lui que Scrapy utilise pour extraire des informations d’une page web. À titre d’exemple, nous allons extraire des données du site web « quotes.toscrape.com ».
Tout d’abord, vous devez exécuter le code suivant :
_import scrapy
class QuotesSpider(scrapy.Spider) : name = "test" # Les noms de spider doivent être uniques pour chaque spider que vous créez
def start_requests(self):
    urls = [
        'https://quotes.toscrape.com/page/1/',
        # Remplacez ces URL par
les pages web que vous souhaitez extraire 'https://quotes.toscrape.com/page/2/', ] for url in urls: yield scrapy.Request(url=url, callback=self.parse)
def parse(self, response):
    page = response.url.split("/")[-2]
    filename = f'quotes-{page}.html'
    with open(filename, 'wb') as f:
        f.write(response.body)
    self.log(f'Fichier {filename} enregistré')
_
Pour que le spider commence à explorer le site, vous devez exécuter :
scrapy crawl test
Vous devriez alors obtenir un résultat indiquant que vous avez exploré le site web « quotes.toscrape.com ».
Si vous souhaitez extraire certaines données d’une page web, vous pouvez utiliser le mot-clé Python « yield » et exécuter le code suivant :
_import scrapy
class QuotesSpider(scrapy.Spider) : name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', 'https://quotes.toscrape.com/page/2/', ]
def parse(self, response) :
    for quote in response.css('div.quote') :
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }
_
Ce code extrait les textes, l'auteur et les balises de la page web que vous avez explorée, qui s'afficheront dans le journal.
Si vous souhaitez explorer toutes les pages d'un site web, plutôt que seulement des pages spécifiques, vous pouvez exécuter :
_import scrapy
class QuotesSpider(scrapy.Spider) : name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', ]
def parse(self, response) :
    for quote in response.css('div.quote') :
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }

    next_page = response.css('li.next a::attr(href)').get()
    if next_page is not None:
        next_page = response.urljoin(next_page)
        yield scrapy.Request(next_page, callback=self.parse)
_
Vous devez maintenant stocker les données extraites par le robot. Pour stocker les données récupérées, il suffit d’exécuter :
scrapy crawl test -O test.json
Si vous souhaitez ajouter du nouveau contenu à un fichier déjà existant, vous pouvez plutôt exécuter ce code :
scrapy crawl quotes -o quotes.jsonl
Félicitations ! Vous venez de terminer l’extraction et le stockage des données que vous avez récupérées avec Scrapy. Vous pouvez encore ajouter un élément pour garantir le succès du web scraping avec Scrapy : l’utilisation des proxys Scrapy.
Configuration des proxys Scrapy
Un proxy Scrapy gérera toutes vos requêtes Web à votre place ; ainsi, tout site Web que vous explorez ne verra que l'adresse IP du serveur proxy. Votre adresse IP sera ainsi totalement masquée. Grâce à la rotation continue des adresses IP et à l’utilisation de proxys résidentiels, les sites web seront amenés à croire que vos requêtes proviennent d’utilisateurs réels et non d’un simple bot de scraping tel que Scrapy.
À titre d’exemple, nous utiliserons un proxy Geonode. Vous pouvez passer directement à la section « Obtenir les informations du serveur proxy avec Geonode » si vous n’avez pas encore obtenu les informations relatives à votre proxy Geonode.
Il existe deux méthodes pour configurer un proxy dans Scrapy.
La première consiste à utiliser le middleware de Scrapy, appelé HTTPProxyMiddleware, qui configure automatiquement votre paramètre de proxy comme proxy par défaut.
Vous pouvez exécuter :
_def start_requests(self): for url in self.start_urls: return Request(url=url, callback=self.parse, headers={"User-Agent": "My UserAgent"}, meta={"proxy": "premium-residential.geonode.com:9001"}) _
La deuxième méthode consiste à créer votre propre middleware. Cette méthode est plus isolée et vous offre une plus grande liberté.
Vous pouvez exécuter :
_from w3lib.http import basic_auth_header
DOWNLOADER_MIDDLEWARES = { 'myproject.middlewares.CustomProxyMiddleware' : 350, 'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware' : 400, }
class CustomProxyMiddleware(object): def process_request(self, request, spider): request.meta[“proxy”] = "premium-residential.geonode.com:9001" request.headers[“Proxy-Authorization”] = basic_auth_header(« geonode_xbYe9H2LYr », « 9806022c-cd4a-4776-a053-73fee44344dd ») _
Félicitations ! Vous avez ajouté un serveur proxy pour le scraping de n’importe quel site web avec Scrapy. Si vous souhaitez vérifier que votre proxy fonctionne, vous pouvez vous rendre sur https://www.geonode.com/what-is-my-ip.
Obtenir les informations relatives au serveur proxy avec Geonode
Étape 1. Rendez-vous sur **Geonode
** et connectez-vous avec votre compte existant ou inscrivez-vous pour en créer un nouveau.
Étape 2. Sur la page d’accueil, cliquez sur « Services résidentiels ».

Étape 3. Faites défiler la page vers le bas jusqu’à ce que vous voyiez « Points de terminaison ».
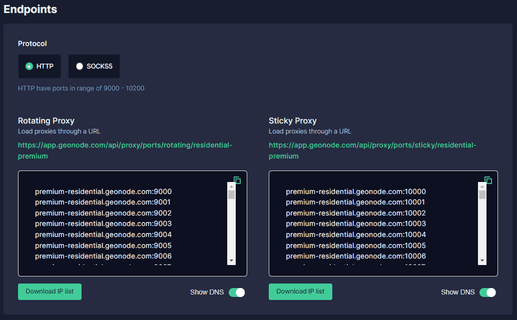
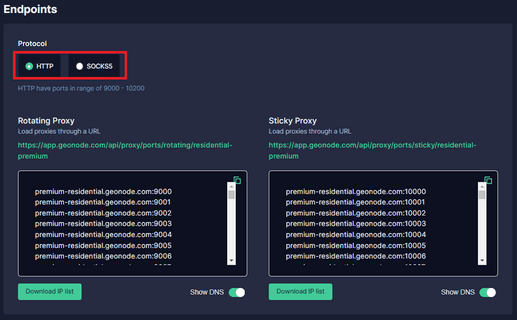
Étape 4. Choisissez le « Protocole proxy » que vous souhaitez utiliser : « Protocole HTTP » ou **« [Protocole SOCKS5
](https://geonode.com/blog/beginners-guide-to-socks5-proxies) »**.
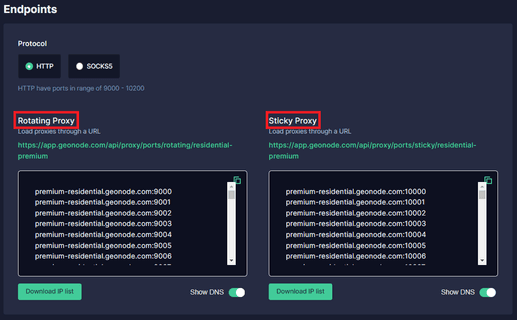
Étape 5. Sélectionnez le « Type de session » que vous souhaitez utiliser : « Proxy rotatif » ou Proxy statique.
Étape 6. Choisissez le proxy que vous souhaitez utiliser. À titre d’exemple, nous allons utiliser le proxy surligné **« premium-residential.geonode
.com:9001 »**.
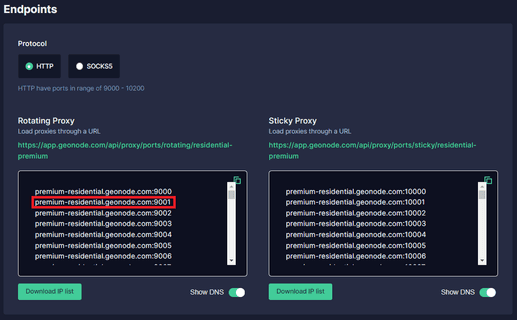
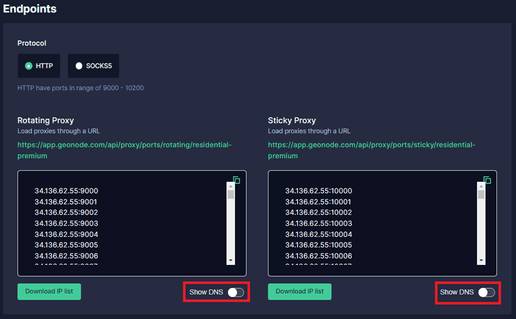
Si vous souhaitez utiliser une adresse IP plutôt qu’un DNS, il vous suffit de désactiver le bouton « Afficher le DNS » pour que les adresses IP s’affichent.
Étape 7. Vous avez maintenant besoin des « informations d’authentification » de votre compte proxy. Pour Geonode
, celles-ci se trouvent sur la page d’accueil de votre compte.
