Imaginez un peu : en quelques lignes de code, vous accédez à une mine de données provenant de Subito.it, la plateforme de vente en ligne incontournable en Italie.
Il ne s'agit pas seulement d'une astuce technique ingénieuse, mais d'une avancée révolutionnaire pour tous ceux qui souhaitent prendre des décisions fondées sur les données.
Que vous souhaitiez comprendre le comportement des consommateurs, garder une longueur d’avance grâce à une tarification dynamique ou devancer la concurrence, le web scraping de Subito.it est votre sésame.
Plongez-vous dans ce guide pour découvrir comment vous pouvez améliorer votre stratégie commerciale en exploitant l’univers riche en données de Subito.it.
Qu'est-ce que Subito.it ?
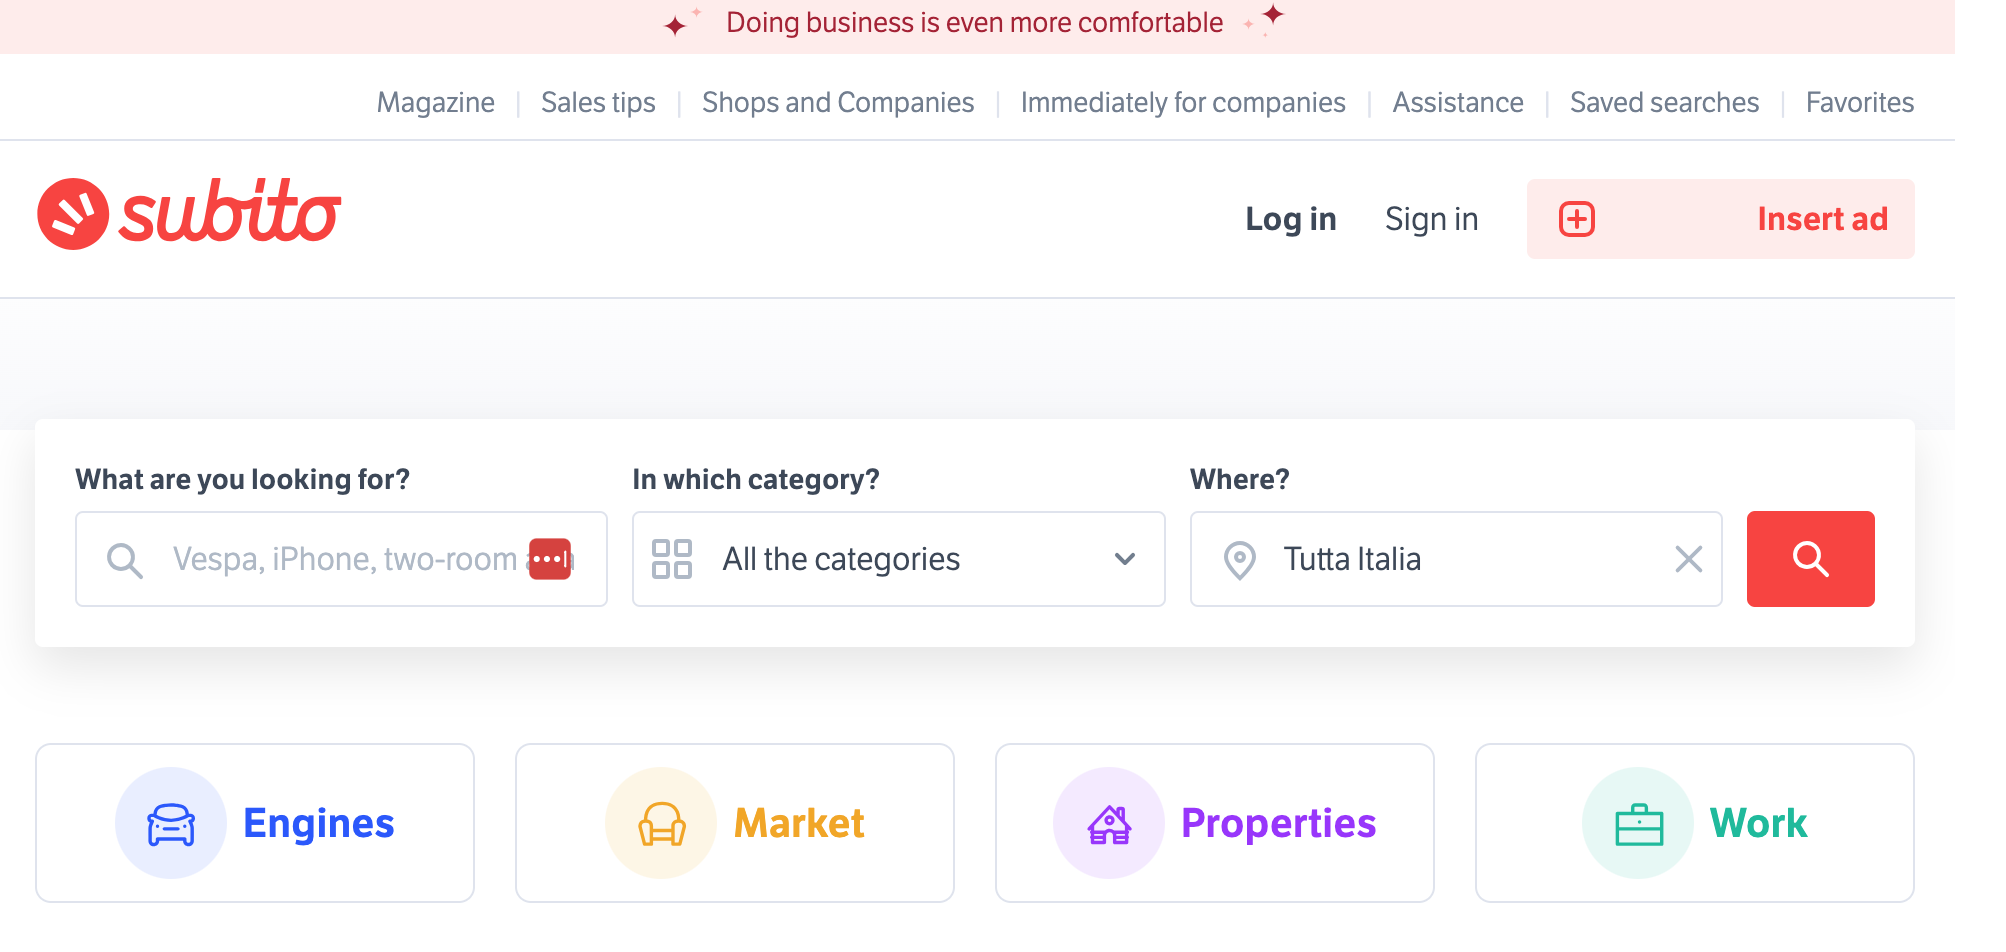
Subito.it est une plateforme en ligne italienne où les utilisateurs peuvent acheter et vendre des articles neufs et d'occasion.
Le site propose un large éventail de catégories, notamment l'automobile, le marché, l'immobilier et l'emploi.
Les utilisateurs peuvent publier des annonces locales pour des voitures, des maisons, des appareils électroniques, des meubles, des animaux de compagnie et bien plus encore.
La plateforme offre également diverses fonctionnalités visant à rendre les transactions plus sûres et plus pratiques, telles que le suivi des envois et des options de paiement sécurisées.
Pourquoi extraire les données de Subito.it ?
L'extraction de données Web est devenue un outil indispensable dans le monde des affaires moderne, et Subito.it, l'une des plus grandes places de marché en ligne d'Italie, offre une mine de données qui peuvent s'avérer inestimables pour diverses applications.
L'importance des données de Subito.it dans le commerce électronique
Subito.it n’est pas simplement une place de marché en ligne parmi tant d’autres ; c’est une véritable mine d’or de données pour tout acteur du commerce électronique.
Avec des millions d’annonces dans des catégories telles que l’automobile, l’immobilier, l’emploi et les biens de consommation, la plateforme offre une vue d’ensemble complète des tendances du marché, des préférences des consommateurs et des stratégies de tarification.
En effectuant du scraping sur Subito.it, les entreprises peuvent accéder à ces données en temps réel, ce qui leur permet de prendre des décisions plus agiles et mieux informées.
Par exemple, si vous êtes un e-commerçant, vous pouvez effectuer du scraping sur Subito.it pour connaître le prix moyen de produits similaires aux vôtres et ajuster votre stratégie tarifaire en conséquence.
De même, les agences immobilières peuvent extraire les annonces pour évaluer la valeur marchande des biens immobiliers dans différentes régions.
Les données de Subito.it peuvent également être utilisées pour l’analyse des sentiments, aidant ainsi les entreprises à comprendre ce que recherchent les clients et ce qu’ils pensent de certains produits ou services.
Cas d’utilisation de l’extraction de données sur Subito.it
- Étude de marché. Comprendre les tendances du marché est essentiel pour toute entreprise.
En effectuant un scraping de Subito.it, vous pouvez collecter des données sur les produits les plus populaires, les tendances saisonnières et les demandes des consommateurs, ce qui vous aide à adapter votre offre en conséquence.
- Analyse concurrentielle. Surveiller vos concurrents n’a jamais été aussi simple grâce au web scraping. Extrayez des données sur les fiches produits, les avis clients et les stratégies de tarification pour évaluer votre position par rapport à la concurrence.
- Tarification dynamique. Sur un marché en constante évolution, une tarification statique peut constituer un désavantage. Le scraping de Subito.it vous permet de suivre en temps réel les tendances des prix, ce qui vous donne la possibilité d’ajuster vos tarifs à la volée pour maximiser vos bénéfices ou votre part de marché.
- Génération de prospects. Pour les secteurs de services ou les entreprises B2B, Subito.it peut constituer une source de prospects potentiels. Extrayez les coordonnées et les demandes de services pour créer un entonnoir de vente ciblé.
- Analyse des sentiments. Les avis et commentaires des clients sur Subito.it peuvent être extraits à des fins d’analyse des sentiments, fournissant ainsi des informations sur l’opinion publique et les axes d’amélioration.
Études de cas et exemples concrets
-
Concessionnaire automobile. Un concessionnaire automobile local peut utiliser les données de Subito.it pour comprendre la demande en voitures électriques dans sa région. En récupérant les annonces et les demandes des clients, il peut s’approvisionner en modèles les plus recherchés, ce qui se traduit par une augmentation de 20 % des ventes.
-
Enseigne de mode. Une enseigne de mode peut extraire des données de Subito.it pour analyser la popularité des différentes marques et styles de vêtements. Cette approche fondée sur les données lui permet d’adapter son stock, ce qui se traduit par un système de gestion des stocks plus efficace et une augmentation des ventes.
-
Agence immobilière. Une agence immobilière peut exploiter les données de Subito.it pour recueillir des informations sur les prix de l’immobilier dans différents quartiers. Ces informations peuvent servir à développer un modèle de tarification dynamique qui ajuste les prix des biens en fonction des conditions du marché en temps réel, optimisant ainsi considérablement son chiffre d’affaires.
En comprenant l’importance, les cas d’utilisation et les applications concrètes du scraping de Subito.it, il apparaît clairement que cette pratique n’est pas seulement un exercice technique, mais une nécessité stratégique pour les entreprises modernes.
Méthodes pour extraire des données de Subito.it
L'extraction de données de Subito.it peut s'effectuer de plusieurs façons, chacune présentant ses propres avantages et limites.
Que vous soyez novice en programmation ou développeur chevronné, il existe une méthode adaptée à vos besoins.
Extraction manuelle
En quoi cela consiste-t-il ? : L’extraction manuelle est la méthode la plus simple, ne nécessitant aucune compétence en programmation.
Elle consiste à se rendre manuellement sur le site Subito.it et à copier les données dont vous avez besoin.
Comment procéder ? :
-
- Ouvrez votre navigateur. Accédez à Subito.it depuis votre navigateur web.
- Recherchez des annonces. Utilisez la barre de recherche ou les filtres par catégorie pour trouver les annonces qui vous intéressent.
- Copiez les données. Copiez-collez manuellement les données dans un tableur ou un document.
Avantages et inconvénients :
-
- Avantages : facile à réaliser, aucune compétence technique requise.
- Inconvénients : extrêmement chronophage, peu pratique pour les grands ensembles de données, sujet aux erreurs humaines.
Idéal pour : les projets à petite échelle ou les tâches rapides et ponctuelles de récupération de données.
Écrire du code
En quoi cela consiste-t-il ? : Il s'agit d'écrire des scripts pour automatiser le processus de scraping. Les langages les plus couramment utilisés à cette fin sont Python et JavaScript.
Comment procéder :
-
- Choisissez une bibliothèque. Les bibliothèques telles que BeautifulSoup pour Python ou Puppeteer pour JavaScript sont des choix courants.
- Inspectez les éléments. Utilisez les outils de développement de votre navigateur pour inspecter les éléments HTML contenant les données souhaitées.
- Écrivez le code. Écrivez un script pour accéder à Subito.it, localiser les données et les extraire.
- Exécutez le script. Exécutez le script pour collecter les données.
Avantages et inconvénients :
-
- Avantages : hautement personnalisable, capable de traiter de grands ensembles de données, minimise les erreurs humaines.
- Inconvénients : nécessite des compétences en programmation, peut nécessiter une mise à jour à mesure que la structure du site web évolue.
Idéal pour : les projets de moyenne à grande envergure nécessitant personnalisation et évolutivité.
Utilisation de scrapers tiers
De quoi s’agit-il ? : il s’agit de logiciels ou de plateformes prêts à l’emploi conçus pour extraire des données de sites web.
Comment procéder :
-
- Choisissez un outil de scraping. Recherchez et sélectionnez un outil tiers adapté à vos besoins.
- Configurez-le. La plupart de ces outils proposent une interface graphique (GUI) dans laquelle vous pouvez pointer et cliquer sur les données que vous souhaitez extraire.
- Lancez le scraper. Démarrez le processus d’extraction. Certains outils proposent des solutions basées sur le cloud, ce qui vous évite d’avoir à exécuter le scraper sur votre machine.
Avantages et inconvénients :
-
- Avantages : Facile à utiliser, ne nécessite pas de codage, intègre souvent des fonctionnalités telles que la rotation d’adresses IP.
- Inconvénients : Peut être coûteux, moins personnalisable que de développer votre propre solution.
Idéal pour : Ceux qui ont besoin d'une méthode plus simple et moins technique pour extraire des données à grande échelle.
En comprenant ces méthodes, vous pouvez choisir celle qui correspond le mieux à la portée de votre projet et à vos compétences techniques. Chacune présente ses avantages et ses inconvénients, mais toutes constituent des moyens viables d'exploiter les riches ressources de données proposées par Subito.it.
Outils nécessaires
L'écriture de code est l'une des méthodes les plus courantes pour extraire des données de Subito.it, car elle offre un haut degré de personnalisation.
Cependant, le codage n’est qu’une partie du processus. Pour extraire efficacement les données d’un site web, vous aurez besoin d’un ensemble d’outils capables de gérer les différents aspects du processus d’extraction.
Cette section fournit un guide général sur les outils indispensables dont vous aurez besoin pour extraire les données de Subito.it.
Bibliothèques de scraping Web
Les bibliothèques de scraping Web sont des ensembles de code pré-écrits qui simplifient le processus d’extraction de données à partir de sites Web.
Elles gèrent les détails techniques de la navigation dans le HTML et le HTTP, vous permettant ainsi de vous concentrer sur les données qui vous intéressent.
Bibliothèques Python pour le scraping de Subito.it :
- Beautiful Soup. Idéale pour les débutants, Beautiful Soup facilite l’extraction d’informations à partir de pages web en fournissant des idiomes Python pour itérer, rechercher et modifier l’arbre d’analyse.
- Scrapy. Plus adapté au scraping Web à grande échelle, Scrapy est un framework open source qui fournit tous les outils nécessaires pour explorer des sites Web et en extraire des données.
- Selenium. Bien qu’il ne s’agisse pas à proprement parler d’une bibliothèque de scraping Web, Selenium est utile pour les sites Web qui chargent des données de manière dynamique via JavaScript.
Proxys Premium
Les proxys servent d’intermédiaires entre votre ordinateur et le site web que vous explorez, masquant ainsi votre adresse IP. Les proxys Geonode sont réputés pour leur efficacité et leur sécurité.
Comment les proxys Geonode peuvent rendre votre exploration plus efficace et plus sécurisée :
- Rotation des adresses IP. Les proxys de Geonode effectuent automatiquement une rotation des adresses IP, ce qui réduit le risque d’être bloqué par Subito.it.
- Vitesse. Geonode propose des proxys haut débit qui garantissent une exécution rapide de vos tâches de scraping.
- Sécurité. Avec Geonode, vos données sont chiffrées, ce qui offre une couche de sécurité supplémentaire.
Geonode dispose d’un tableau de bord où vous pouvez configurer vos paramètres de proxy. Une fois configurés, vous pouvez les intégrer à votre code de scraping.
Extensions de navigateur indispensables
Les extensions de navigateur peuvent faciliter le processus de scraping en vous aidant à comprendre la structure d’un site web ou en automatisant certaines tâches manuelles.
- Web Scraper : cette extension Chrome vous permet de configurer un plan et d’extraire des données directement depuis votre navigateur.
- Data Miner : Utile pour extraire des tableaux ou des listes, Data Miner peut vous faire gagner du temps lors de vos recherches préliminaires.
- Selector Gadget : cette extension vous aide à trouver rapidement des sélecteurs CSS, ce qui peut s'avérer utile lors de l'écriture de votre code de scraping.
Ces extensions sont disponibles dans le Chrome Web Store. Il suffit de rechercher l'extension et de cliquer sur « Ajouter à Chrome ».
En vous équipant de ces outils indispensables, vous êtes sur la bonne voie pour extraire efficacement des données de Subito.it. Que vous soyez débutant ou développeur expérimenté, ces outils vous fournissent les bases nécessaires pour extraire des données précieuses de Subito.it.
Configuration de votre environnement
Avant de vous lancer dans le processus de scraping proprement dit, il est essentiel de mettre en place un environnement propice à un scraping web efficace et performant. Cette section constitue un guide général destiné à vous aider à préparer votre système pour le scraping de Subito.it.
Installation des logiciels requis
Pour extraire des données de Subito.it, vous aurez besoin d’un éditeur de code, d’un environnement Python et de bibliothèques spécifiques facilitant l’extraction de données Web.
Configuration logicielle pour l’extraction de données de Subito.it :
-
Éditeur de code. Choisissez un éditeur de code dans lequel vous écrirez votre script de scraping. Parmi les options les plus courantes, on trouve Visual Studio Code, PyCharm ou Jupyter Notebook pour les projets davantage axés sur les données.
-
Environnement Python. Si Python n’est pas encore installé sur votre ordinateur, téléchargez-le et installez-le depuis le site officiel. Veillez à installer également pip (le gestionnaire de paquets de Python).
-
Bibliothèques de scraping Web : Installez les bibliothèques Python que vous utiliserez pour le scraping. Ouvrez votre terminal et exécutez les commandes suivantes :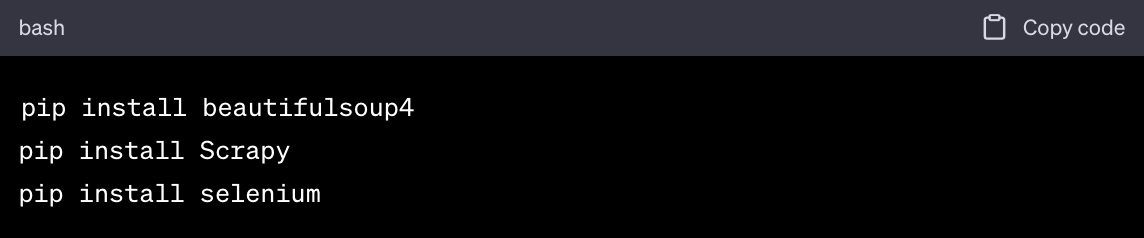
-
Navigateur et pilote : si vous utilisez Selenium, vous aurez également besoin d’un pilote web correspondant à votre navigateur (par exemple, ChromeDriver pour Google Chrome).
Étapes d’installation :
- Téléchargez l’éditeur de code de votre choix et suivez les instructions d’installation.
- Installez Python et veillez à cocher la case qui ajoute Python à votre PATH.
- Ouvrez votre terminal et exécutez les commandes pip pour installer les bibliothèques de web scraping.
- Téléchargez le pilote Web pour Selenium et placez-le dans un répertoire figurant dans le PATH de votre système.
Configuration des proxys d’Geonode
-
Inscrivez-vous sur Geonode. Rendez-vous sur le site Web de Geonode et créez un compte. Choisissez une formule adaptée à vos besoins.
-
Accédez au tableau de bord. Connectez-vous à votre compte Geonode et accédez au tableau de bord.
-
Créez un pool de proxys. Dans le tableau de bord, recherchez l’option permettant de créer un nouveau pool de proxys. Suivez les instructions pour configurer votre pool, en précisant les pays ou les villes d’où vous souhaitez que proviennent vos adresses IP.
-
Récupérez les informations relatives aux proxys. Une fois le pool configuré, vous obtiendrez une liste d’adresses IP et de ports proxy. Copiez ces informations.
-
Intégrez-les dans votre code. Dans votre code de scraping, vous devrez configurer votre bibliothèque de scraping Web pour acheminer les requêtes via le proxy Geonode. Par exemple, si vous utilisez la bibliothèque requests de Python, vous procéderez comme suit :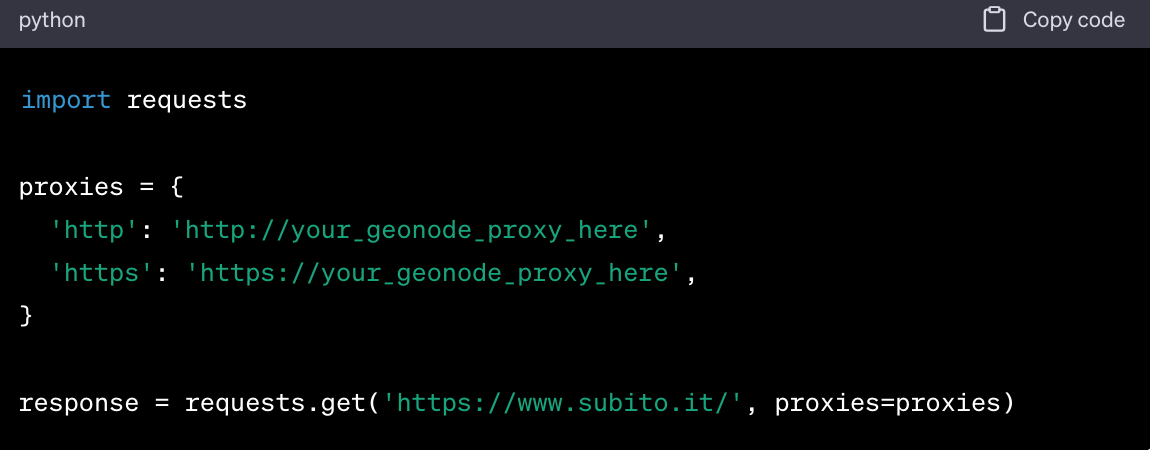
En suivant ces étapes, vous disposerez d’un environnement solide pour le scraping de Subito.it. Avec les logiciels et les proxys appropriés en place, vous êtes bien équipé pour commencer à collecter les données dont vous avez besoin.
Le processus de scraping
Une fois votre environnement configuré, vous êtes prêt à vous lancer dans le processus de scraping proprement dit.
Identification des données à extraire
La première étape de tout projet de scraping consiste à identifier précisément les données que vous souhaitez collecter. Celles-ci peuvent aller des prix et descriptions de produits aux avis des utilisateurs, et bien plus encore.
Quelles données extraire de Subito.it :
- Fiches produits. Informations telles que le nom du produit, son prix et sa description.
- Informations sur le vendeur. Détails tels que le nom du vendeur, ses coordonnées et ses notes.
- Avis des utilisateurs. Notes et avis textuels des utilisateurs.
- Résultats de recherche. Données issues des pages de résultats de recherche, y compris les indicateurs de classement et de pertinence.
Comment identifier ces données :
- Inspectez le site web. Naviguez sur Subito.it et identifiez les pages qui contiennent les données qui vous intéressent.
- Utilisez les outils de développement. Ouvrez les outils de développement de votre navigateur pour inspecter la structure HTML et identifier les balises qui contiennent les données souhaitées.
Écriture du code de scraping
Cela implique d’écrire un script en Python (ou dans un autre langage) qui se rendra sur la page web et extraira les données que vous avez identifiées.
Voici un extrait de code Python simplifié utilisant BeautifulSoup pour extraire les noms et les prix des produits d’une page Subito.it hypothétique : 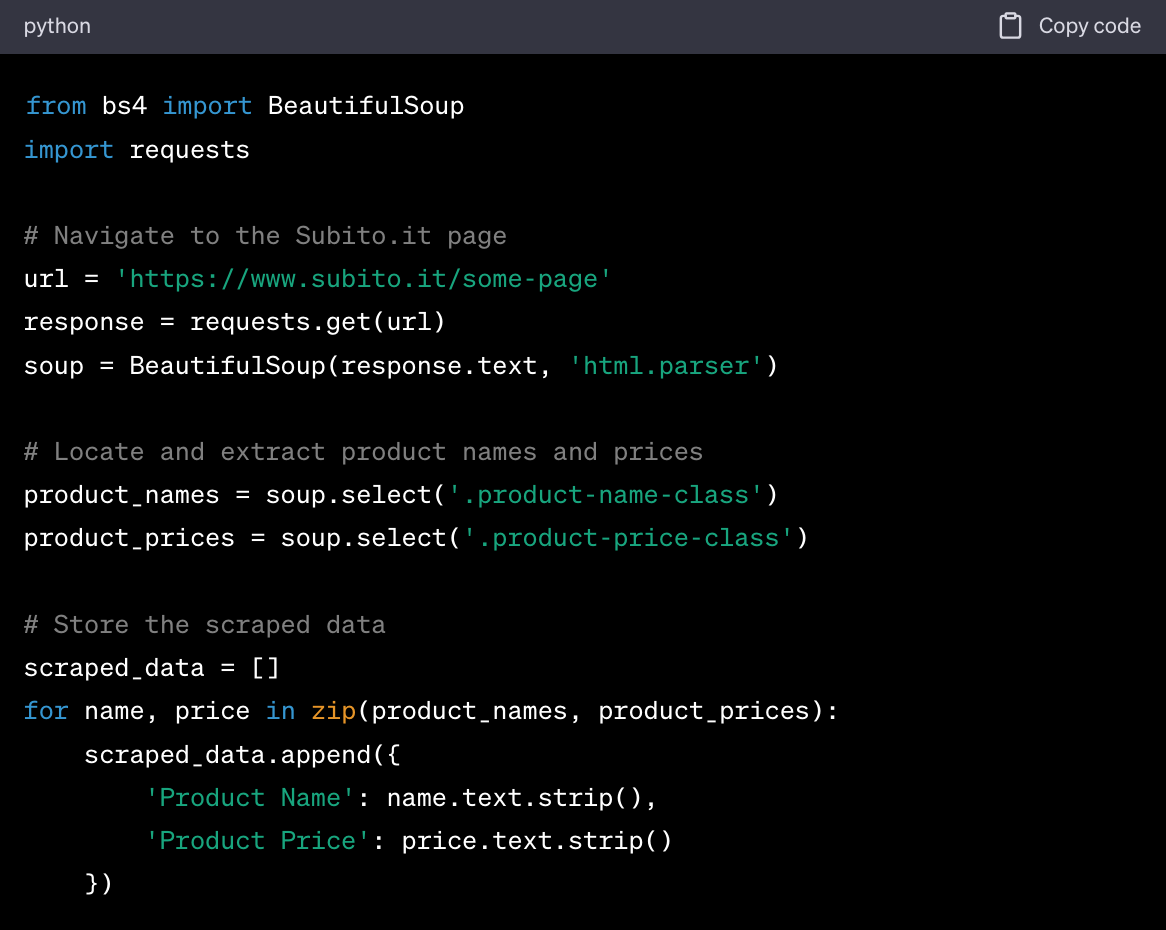
Exécution du scraper
C’est à cette étape que vous exécutez votre code de scraping pour collecter les données que vous avez ciblées.
Comment exécuter votre code de scraping et collecter des données
- Testez à petite échelle. Avant de lancer votre scraper sur des centaines de pages, testez-le sur quelques-unes pour vous assurer qu’il fonctionne comme prévu.
- Exécutez le code. Exécutez votre script Python. Cela peut généralement se faire directement depuis votre éditeur de code ou depuis la ligne de commande en tapant «
python your_script_name.py ».
- Surveillez le processus. Gardez un œil sur le script pendant son exécution pour vous assurer qu’il n’y a pas d’erreurs ou de problèmes.
- Stockez les données. Assurez-vous que votre script est configuré pour stocker les données extraites dans un format utile, tel qu’un fichier CSV ou une base de données.
En suivant ces étapes, vous serez sur la bonne voie pour extraire avec succès des données précieuses de Subito.it. Avec une préparation et une exécution adéquates, le web scraping peut vous fournir les informations dont vous avez besoin pour prendre des décisions éclairées.
Bonnes pratiques et considérations juridiques
Lors du scraping de Subito.it ou de tout autre site web, il est essentiel de tenir compte à la fois des bonnes pratiques et des considérations juridiques.
Cela garantit que vos activités de scraping sont à la fois éthiques et conformes aux lois et réglementations en vigueur. Cette section abordera ces aspects en détail.
Respecter le fichier robots.txt
Le fichier robots.txt est une norme utilisée par les sites web pour communiquer avec les robots d'indexation et autres agents automatisés, en indiquant quelles parties du site ne doivent pas être traitées ou explorées.
Ignorer les directives énoncées dans le fichier robots.txt peut entraîner le blocage de votre adresse IP et pourrait potentiellement avoir des conséquences juridiques.
Limitation de débit et rotation d’adresses IP
La limitation de débit consiste à restreindre le nombre de requêtes que vous pouvez envoyer à un site web au cours d’un laps de temps donné. La rotation d’adresses IP consiste à changer périodiquement d’adresse IP afin d’éviter d’être détecté et banni.
Comment les proxys d’Geonode peuvent vous aider en matière de limitation de débit et de rotation d’adresses IP :
- Rotation d’adresses IP. Les proxys d’Geonode font tourner automatiquement votre adresse IP, ce qui rend difficile pour les sites web de vous identifier et de vous bloquer.
- Limitation de débit. L’utilisation de plusieurs adresses IP via Geonode vous permet de répartir vos requêtes, contournant ainsi efficacement les limites de débit fixées par le site web.
- Configuration. Les proxys de Geonode disposent de paramètres qui vous permettent de contrôler la fréquence et le schéma de vos requêtes, vous aidant ainsi à effectuer votre scraping de manière responsable.
Le non-respect des limites de débit ou l’absence de rotation des adresses IP peut entraîner le blocage de votre outil de scraping, rendant ainsi vos efforts inefficaces.
Stockage et utilisation des données
Une fois les données extraites, leur stockage et leur utilisation sont soumis à des considérations à la fois éthiques et juridiques.
- Stockage. Stockez les données dans un environnement sécurisé afin d’empêcher tout accès non autorisé. Le chiffrement est souvent recommandé.
- Utilisation. Les données que vous avez extraites doivent être utilisées de manière responsable. L’utilisation abusive des données à des fins de spam, de fraude ou de toute forme de harcèlement est non seulement contraire à l’éthique, mais également illégale.
- Partage. Si vous avez l’intention de partager les données extraites, assurez-vous d’en avoir le droit légal. Certains sites web ont des conditions d’utilisation qui interdisent le partage des données extraites.
- Mention de la source. Si vous utilisez ces données à des fins de recherche ou de reporting, il est recommandé de citer la source.
Un stockage inapproprié ou une utilisation contraire à l’éthique des données extraites peut entraîner des conséquences juridiques et nuire à votre réputation.
En respectant ces bonnes pratiques et ces considérations juridiques, vous pouvez vous assurer que vos activités de web scraping sont menées de manière responsable et éthique. Cela permet non seulement de minimiser le risque de problèmes juridiques, mais contribue également à l’intégrité et à la fiabilité de vos projets de web scraping.
Dépannage et FAQ
Même avec la meilleure préparation qui soit, vous pourriez rencontrer des problèmes lors de l'extraction de données sur Subito.it. Cette section a pour but de traiter les erreurs courantes et les questions fréquemment posées afin de vous aider à résoudre efficacement les problèmes liés à vos activités d'extraction de données.
Erreurs courantes et solutions
Dépannage des problèmes de scraping sur Subito.it :
-
IP bloquée. Si vos requêtes sont rejetées, il est probable que votre adresse IP ait été bloquée.
- Solution : utilisez un service de proxy tel que Geonode pour faire tourner vos adresses IP.
-
Limite de débit dépassée. Si vous effectuez trop de requêtes en peu de temps, vous risquez d'atteindre la limite de débit.
- Solution : Intégrez un délai entre vos requêtes ou répartissez-les en utilisant plusieurs adresses IP.
-
Données incomplètes ou inexactes. Il arrive parfois que le scraper ne collecte pas toutes les données requises ou qu’il collecte des données incorrectes.
- Solution : Vérifiez attentivement votre code pour vous assurer que vous ciblez les bons éléments HTML.
-
Erreurs de délai d'expiration. Votre scraper peut expirer si une page met trop de temps à se charger.
- Solution : Augmentez le délai d'expiration dans votre code ou essayez d'optimiser votre scraper pour qu'il s'exécute plus rapidement.
Les internautes se posent aussi ces questions
Foire aux questions et réponses :
-
Comment extraire les données de Subito.it sans se faire bloquer ?
- Utilisez des proxys pour faire tourner vos adresses IP et mettez en place une limitation de débit afin d'éviter d'envoyer trop de requêtes en peu de temps. Respectez également les consignes figurant dans le fichier «
robots.txt » de Subito.it.
-
Le scraping de Subito.it est-il légal ?
- Bien que le scraping de données publiques soit généralement légal, il est essentiel de respecter les conditions d'utilisation du site web et les directives d'
robots.txt. Une utilisation abusive des données extraites peut entraîner des conséquences juridiques.
-
Comment scraper Subito.it plus rapidement ?
- Pour accélérer le processus de scraping, vous pouvez utiliser une bibliothèque ou un framework de scraping plus performant. De plus, l’utilisation d’un service de proxy tel que Geonode peut vous aider à répartir vos requêtes sur plusieurs adresses IP, ce qui permet de contourner efficacement les limites de débit.
En prenant connaissance de ces problèmes courants et de cette FAQ, vous serez mieux préparé à relever les défis liés au scraping web. Un dépannage adéquat peut vous faire gagner du temps et économiser des ressources, rendant ainsi votre projet de scraping plus efficace et performant.
Conclusion
Le scraping de Subito.it offre une multitude d’opportunités aux entreprises, aux chercheurs et aux analystes de données.
En automatisant le processus de collecte de données, vous pouvez obtenir des informations précieuses sur les tendances du marché, le comportement des consommateurs et le paysage concurrentiel.
Que vous cherchiez à optimiser votre stratégie tarifaire, à mieux comprendre votre public cible ou à prendre des décisions fondées sur des données, le scraping de Subito.it vous fournit les données brutes dont vous avez besoin.
Ce guide a abordé tous les aspects, de la configuration de votre environnement et du choix des outils adaptés aux bonnes pratiques et au dépannage.
L’objectif était de vous doter des connaissances et des compétences nécessaires pour extraire efficacement et de manière responsable les données de Subito.it.
Que faire des données que vous avez extraites et comment les exploiter pour assurer la réussite de votre entreprise :
-
Nettoyage des données : la première étape après l’extraction consiste à nettoyer et à organiser les données. Cela implique de supprimer les doublons, de traiter les valeurs manquantes et de convertir les types de données si nécessaire.
-
Analyse des données. Utilisez des méthodes statistiques ou des algorithmes d’apprentissage automatique pour analyser les données. Cela pourrait vous aider à identifier des schémas, des corrélations ou des tendances susceptibles d’être bénéfiques pour votre entreprise.
-
Mise en œuvre stratégique. Appliquez les enseignements tirés de l’analyse à vos stratégies commerciales. Par exemple, si vous avez extrait des données sur les prix, vous pourriez les utiliser pour optimiser votre propre stratégie tarifaire.
-
Suivi et mise à jour. Le Web est dynamique et les données peuvent rapidement devenir obsolètes. Prenez l’habitude d’exécuter votre outil de scraping régulièrement afin de maintenir vos données à jour.
-
Conformité et éthique. Assurez-vous toujours que votre utilisation des données extraites respecte les réglementations légales et les normes éthiques. Cela inclut le respect des lois sur la protection de la vie privée et des droits de propriété intellectuelle.
-
Partagez vos conclusions. Si cela s’avère pertinent, envisagez de partager vos conclusions avec votre équipe, vos parties prenantes, voire la communauté au sens large. Cela apporte non seulement une valeur ajoutée, mais renforce également votre expertise dans ce domaine.
En suivant ces étapes, vous pouvez transformer les données brutes que vous avez extraites en informations exploitables, et ainsi les mettre à profit pour la réussite de votre entreprise.
Avec une approche adéquate et des pratiques responsables, le web scraping peut constituer un outil puissant dans votre arsenal de prise de décision fondée sur les données.

