

Scrapy 是一个开源的网络爬虫框架,互联网上的任何人都可以免费使用。Scrapy 主要用于网络爬取和 网页抓取。它是一种从任何网页中快速、轻松地提取数据的方式,目前由 Zyte 负责维护。
安装 Scrapy
要安装 Scrapy,您需要 Python 3.7 或更高版本。此外,建议将其安装在专用的虚拟环境中,以避免与系统包发生冲突。
在您偏好的平台上 下载 Scrapy。
要安装 Scrapy,您需要先安装 Anaconda 或 Miniconda,打开 Python 终端,并运行以下命令:
conda install -c conda-forge scrapy
或者,您也可以运行:
pip install Scrapy
如果您使用的是 Ubuntu 系统,则需要先安装以下所有依赖项:
sudo apt-get install python3 python3-dev python3-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
如果您使用的是 macOS 系统,则需要安装 Xcode 命令行工具。请打开终端窗口并运行:
xcode-select --install
恭喜!您已在设备上成功安装了 Scrapy。现在,我们可以尝试对某个网站进行网络爬取并提取其数据了。
启动一个 Scrapy 项目
要启动一个新的 Scrapy 项目,您需要指定一个用于存储代码的目录。请运行以下命令:
scrapy startproject scrapetest
运行此命令将创建一个名为“scrapetest”的目录,其中包含以下内容:
_scrapetest/ scrapy.cfg # 部署配置文件
scrapetest/             # 项目的 Python 模块,你将从这里导入代码
    __init__.py

    items.py

    middlewares.py

    pipelines.py

    settings.py

    spiders/          # 后续放置蜘蛛程序的目录
        __init__.py
_
启动 Scrapy 项目后,您需要创建一个 Spider。Spider 是必不可少的,因为 Scrapy 正是通过它从网页中提取信息的。为了便于示例说明,我们将抓取网站“quotes.toscrape.com”。
首先,你需要运行以下代码:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" # 蜘蛛名称应保持唯一 对于你创建的每个蜘蛛
def start_requests(self):
    urls = [
        'https://quotes.toscrape.com/page/1/',
        # 将这些 URL 替换为
你想要抓取的网页 'https://quotes.toscrape.com/page/2/', ] for url in urls: yield scrapy.Request(url=url, callback=self.parse)
def parse(self, response):
    page = response.url.split("/")[-2]
    filename = f'quotes-{page}.html'
    with open(filename, 'wb') as f:
        f.write(response.body)
    self.log(f'已保存文件 {filename}')
_
要让爬虫开始爬取,你需要运行:
scrapy crawl test
随后您应会看到输出结果,表明已成功爬取了“quotes.toscrape.com”网站。
若要从网页中提取特定数据,可以使用 Python 的“yield”关键字,并运行以下代码:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', 'https://quotes.toscrape.com/page/2/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }
_
这段代码会从你抓取的网页中提取文本、作者和标签,这些内容将显示在日志中。
如果你想抓取整个网站的所有页面,而不是仅限特定页面,可以运行:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }

    next_page = response.css('li.next a::attr(href)').get()
    if next_page is not None:
        next_page = response.urljoin(next_page)
        yield scrapy.Request(next_page, callback=self.parse)
_
现在,你需要存储蜘蛛提取的数据。要存储抓取的数据,只需运行:
scrapy crawl test -O test.json
如果你想将新内容追加到已存在的文件中,可以改运行以下代码:
scrapy crawl quotes -o quotes.jsonl
恭喜!您已经完成了使用 Scrapy 抓取并存储数据的操作。您还可以添加一些内容来确保使用 Scrapy 进行网页抓取能够成功,那就是利用 Scrapy 代理。
配置 Scrapy 代理
Scrapy 代理将为您处理所有 Web 请求,因此您抓取的任何网站都只能看到代理服务器的 IP 地址。 您的 IP 地址将被完全隐藏。通过持续轮换 IP 地址并使用 住宅代理,网站会被误导,以为您的请求来自真实用户,而非使用 Scrapy 等网络爬虫的用户。
为便于说明,我们将使用 Geonode 代理。如果您尚未获取 Geonode 代理的详细信息,可以跳转至“使用 Geonode 获取代理服务器详细信息”部分。
在 Scrapy 中配置代理有两种方法。
第一种方法是利用 Scrapy 的中间件,即 HTTPProxyMiddleware,它会自动将您的代理参数设置为默认代理。
您可以运行:
_def start_requests(self): for url in self.start_urls: return Request(url=url, callback=self.parse, headers={"User-Agent": "My UserAgent"}, meta={"proxy": "premium-residential.geonode.com:9001"}) _
第二种方法是创建自己的中间件。这种方法隔离性更强,能给你更大的自由度。
你可以运行:
_from w3lib.http import basic_auth_header
DOWNLOADER_MIDDLEWARES = { 'myproject.middlewares.CustomProxyMiddleware': 350, 'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 400, }
class CustomProxyMiddleware(object): def process_request(self, request, spider): request.meta[“proxy”] = "premium-residential.geonode.com:9001" request.headers[“Proxy-Authorization”] = basic_auth_header("geonode_xbYe9H2LYr", "9806022c-cd4a-4776-a053-73fee44344dd") _
恭喜!现在,当您使用 Scrapy 抓取任何网站时,系统已为您添加了代理服务器。若要验证代理是否正常工作,请访问 https://www.geonode.com/what-is-my-ip。
使用 Geonode
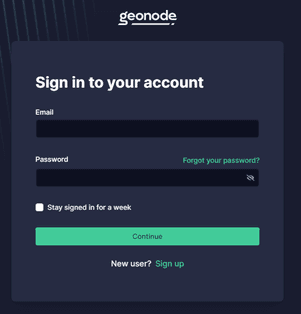
获取代理服务器详细信息### 步骤 1. 访问 **Geonode
**,并 使用现有账户登录或注册创建新账户。
步骤 2. 在首页上,点击 “住宅服务”。

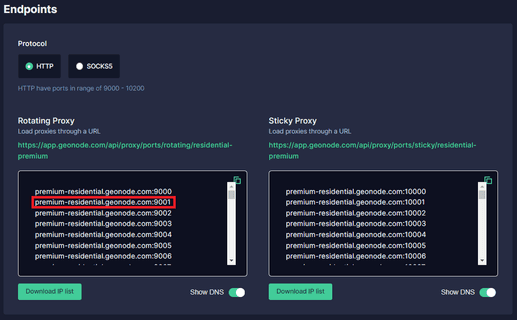
步骤 3. 向下滚动直至看到 “端点”。
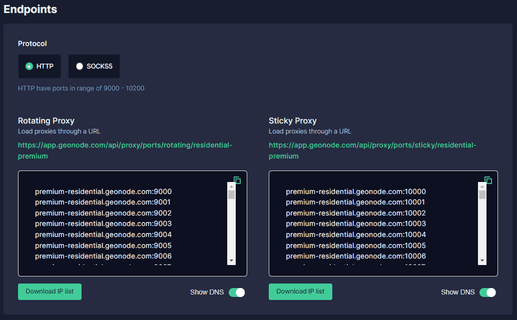
第 4 步。选择要使用的 “代理协议”:“HTTP 协议” 或 **“[SOCKS5
协议](https://geonode.com/blog/beginners-guide-to-socks5-proxies)”**。
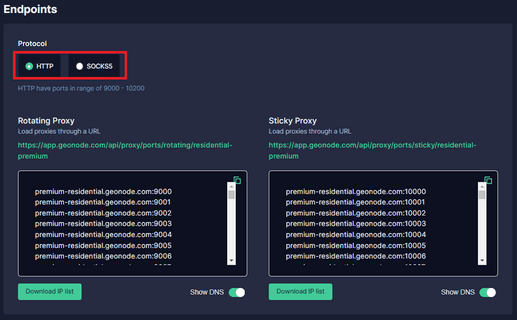
第 5 步。选择要使用的 “会话类型”:“轮转代理” 或 粘性代理。
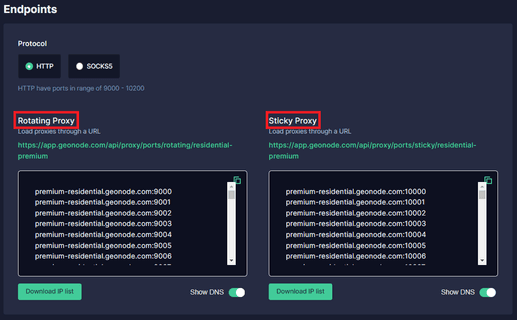
第 6 步。选择要使用的代理。为便于说明,我们将使用高亮显示的代理 **“premium-residential.geonode
.com:9001”**。
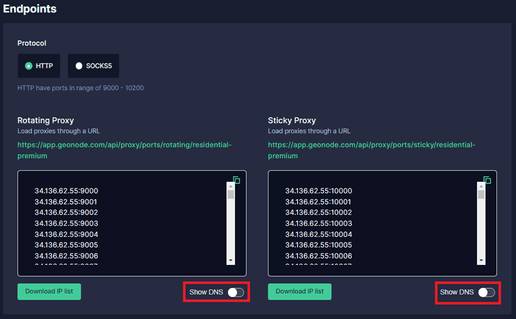
如果您想使用 IP 地址而非 DNS,只需关闭“显示 DNS”按钮,IP 地址就会显示出来。
第 7 步。现在您需要代理账户的 “身份验证详细信息”。对于 Geonode
,该信息位于您的账户主页上。
