
什么是网络爬虫?
网络爬虫,也称为网络数据提取或网络采集,是指利用自动化软件从网站中提取数据的过程。该过程既可以手动完成(例如手动复制粘贴数据),也可以自动完成(例如通过网络爬虫提取信息)。
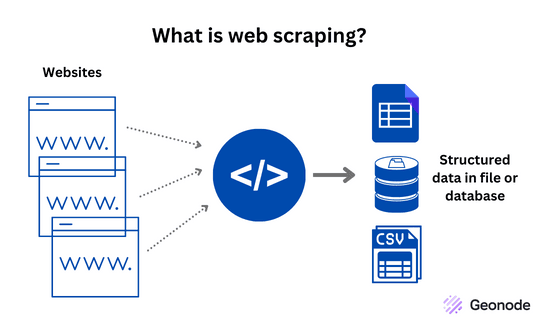
手动操作既费时又费力,尤其是当需要抓取海量数据时。因此,大多数用户更倾向于使用网页抓取工具来完成这项工作。这项技术使个人和组织能够快速、高效地从多个来源收集信息。

Carl Gamutan
更新于:2026年10月7日
发布于:2022年8月8日
无论您是个人用户还是大型企业,数据都能成为一种强大的工具。它能为您提供宝贵的洞察,助您在竞争中保持领先地位。因此,以最快的速度收集海量数据对您或您的企业而言至关重要。此时,网页抓取和网页抓取工具便派上了用场。
网络爬虫,也称为网络数据提取或网络采集,是指利用自动化软件从网站中提取数据的过程。该过程既可以手动完成(例如手动复制粘贴数据),也可以自动完成(例如通过网络爬虫提取信息)。
手动操作既费时又费力,尤其是当需要抓取海量数据时。因此,大多数用户更倾向于使用网页抓取工具来完成这项工作。这项技术使个人和组织能够快速、高效地从多个来源收集信息。
您可以从网络上抓取多种不同类型的数据,包括:
文本数据。这包括标题、文章、产品描述,以及评论、评价等各类内容。
图片和视频。 您可以从网站上抓取照片和视频,包括产品图片、信息图等。
结构化数据。此类数据以特定格式组织,例如表格、电子表格和数据库。结构化数据的示例包括产品列表、房产列表和财务数据。
非结构化数据。此类数据没有特定的组织格式,可能包括社交媒体帖子、评论等内容。
元数据。此类数据提供关于其他类型数据的信息,例如网页的最后更新日期、帖子的作者等。
通过了解网络爬虫可获取的各种数据类型,您可以确定哪些数据最符合您的具体需求,并制定有效的数据爬取策略。
网络爬虫是合法的,尽管网站运营商并不太乐意看到用户爬取其网站。如果他们发现你在其网站上使用网络爬虫或其他自动化工具,他们会立即封禁你的账号并将你的IP地址列入黑名单。
如果您想了解网络爬取的合法性,可以阅读这篇关于该主题的详尽文章:网络爬取的合法性与误区。
从本质上讲,网页抓取是一个包含向网站服务器发送请求、下载 HTML 代码,然后提取所需信息的过程。该请求通常通过网页抓取工具或编程方式(例如使用 Python 等编程语言)来实现。
收到 HTML 代码后,网页抓取工具或程序会解析该代码,以查找您想要提取的具体数据。这通常通过一种称为“数据提取”的技术来实现,该技术利用规则或模式从 HTML 代码中提取信息。
随后,提取的数据将以结构化格式(如电子表格或数据库)存储起来,以便进行进一步分析或使用。
网络爬虫有多种不同类型,每种都有其独特的功能和特性。在本指南中,我们将探讨各种类型的网络爬虫,以便您选择最适合自己需求的工具。
简单屏幕抓取工具是最基础的网页抓取工具类型。它们通过将网站上的信息复制并粘贴到本地文件中来提取数据。这类工具通常用于小规模项目,且对技术知识的要求不高。
复杂屏幕抓取工具比简单屏幕抓取工具更先进,适用于大规模项目。它们通过脚本自动化抓取过程来从网站中提取数据,从而提高速度和效率。复杂屏幕抓取工具通常使用 API 访问数据,从而能够提取更多信息。
无头浏览器是一种不使用图形用户界面的网页抓取工具。它们在后台运行,无需在浏览器窗口中显示网页即可从网站中提取数据。
无头浏览器在网页抓取中非常有用,因为它们比传统网页浏览器更快、更高效,并且允许您从网站中提取数据而无需加载整个页面。
网络爬虫 是一种专门设计用于遍历大型网站、从多个页面提取信息的网络爬虫。其工作原理是从特定页面开始,然后沿着链接跳转到其他页面,并在过程中提取信息。
网络爬虫的应用范围广泛,从为搜索引擎收集信息到监控网站变更均可胜任。
自建网页抓取工具是指个人或组织使用 Python、Ruby 或 JavaScript 等编程语言自行开发的网页抓取工具。这种方法允许用户根据具体需求(例如抓取特定网站、特定数据类型或设定抓取频率)对抓取工具进行定制。
与使用现成的解决方案相比,自建网页抓取工具通常需要更多的技术专长和时间。不过,这种方法的优势在于生成的抓取工具可以高度定制,从而对抓取过程和最终数据拥有更大的控制权。
浏览器扩展网页爬虫是一种直接集成到网页浏览器中的软件工具,可自动从网站抓取数据。此类爬虫旨在与浏览器无缝协作,让您无需在不同程序或应用程序之间切换,即可轻松获取所需数据。
使用浏览器扩展程序类网络爬虫,您可以轻松选择需要爬取的数据,并设置爬取参数。随后,爬虫将自动完成后续工作:提取您所需的数据,并以清晰有序的格式呈现,与手动爬取相比,这能为您节省大量时间和精力。
用户界面式网络爬虫通过向用户提供一个界面,让用户在其中选择需要抓取的数据。 用户可通过该界面进行交互,选择需要提取的数据,剩下的工作将由爬虫完成。它能自动爬取网站内容,提取数据,并以 CSV、Excel 或数据库等结构化格式保存。
使用 UI 网页爬虫的关键优势之一在于它无需编程知识。您只需通过点击和拖拽即可选择要提取的数据。这使其成为那些希望执行简单爬取任务但又无需专业技术知识的用户的绝佳选择。
UI网页爬虫的另一个优势在于其易用性。它们设计得非常用户友好,您无需学习新软件即可快速上手。只需按照步骤操作,转眼间就能获取所需数据。
云端网页抓取工具是一种允许您在云端基础设施上运行网页抓取任务的工具。您无需使用自己的计算机进行抓取,而是可以利用云端远程服务器的处理能力。这意味着您可以大规模抓取网站并处理海量数据,而无需担心本地硬件的限制。
使用云端网页抓取工具的主要优势之一,是能够访问几乎无限的资源,包括存储空间、处理能力和带宽。这意味着即使面对最大、最复杂的网站,您也能进行抓取,而无需担心性能问题。
另一个优势在于,即使您的计算机处于关机状态,也能全天候不间断地运行网页抓取任务。这是因为云端网页抓取工具可以配置为在始终处于开机状态的远程服务器上运行。
本地网页爬虫是一种在您的计算机上运行的网页爬取工具,而非在云端的远程服务器上运行。对于仅需提取有限数据的小规模网页爬取项目而言,这是不错的选择。 如果您担心数据隐私问题,或者需要抓取无法通过公共互联网访问的网站,本地网页抓取工具也是不错的选择。
使用本地网页抓取工具的主要优势之一在于其设置和使用都非常简单。 您无需具备任何专业知识或技术技能即可上手,并能立即开始抓取数据。
另一个优势在于,您可以完全掌控抓取过程。您可以配置抓取工具,按所需格式提取数据,还可以设置抓取任务的频率和计划。
许多编程语言都可用于网页爬取,每种语言各有其优缺点。我们将探讨一些最常用的网页爬取编程语言。
Python:Python 是网络爬虫领域最流行的编程语言之一。它拥有庞大且活跃的开发者社区,该社区专门为网络爬虫开发了许多库和工具。BeautifulSoup 和 Scrapy 是 Python 领域中应用最广泛的两个网络爬虫库。
Ruby: Ruby 是另一种常用的网络爬虫编程语言。它拥有庞大且活跃的社区,并提供了许多用于网络爬虫的库和工具。Nokogiri 是 Ruby 领域中广受欢迎的网络爬虫库之一。
JavaScript:JavaScript 之所以成为网络爬虫的热门语言,是因为许多网站都依赖它来实现功能。 随着 Node.js 的兴起,JavaScript 已成为服务器端网络爬取的热门选择。Puppeteer 是常用的 JavaScript 网络爬取库之一。
PHP:PHP 作为一种常用的网络爬取编程语言,因其被广泛用于网站建设而广受欢迎。 PHP 提供了许多用于网络爬虫的库和工具。Simple HTML DOM 是一个广受欢迎的 PHP 网络爬虫库。
Java:Java 因其高效性和可扩展性而成为网络爬虫领域中广受欢迎的编程语言。Java 提供了许多用于网络爬虫的库和工具,包括 JSoup 和 HtmlUnit。
网络爬虫可用于多种用途,包括:
数据采集:可用于从网站收集大量数据,并将其转化为可用于分析和研究的结构化信息。 这些数据可用于制定明智的商业决策、追踪行业趋势等。
品牌监测:可通过收集公开的客户评论来监测客户意见。这些信息有助于维护甚至提升您的在线声誉。
房产信息: 可用于收集各类房地产数据,包括房价、房产类型、房产位置等。
价格监测:可用于监测电商网站上的价格并追踪竞争对手的定价。这些信息可用于调整您的定价策略,保持竞争力。
潜在客户开发:可用于收集潜在客户信息,并为销售和营销目的建立目标客户名单。
社交媒体监测:可用于监测社交媒体上关于您品牌、竞争对手或行业的提及内容,并收集有关受众的宝贵见解和数据。
价格情报:可用于收集和比较全球产品定价信息,并将所有信息汇总到一个地方。
新闻和内容监测:可用于从包括新闻网站在内的多个来源收集信息,并将其汇总到一个地方,以便于访问和分析。
招聘信息:可用于从各类网站收集招聘信息并整合到一个平台,便于查找就业机会。
旅游信息聚合:可用于从众多酒店和航空公司网站收集信息,并将其整合到一个平台。
网页抓取工具是专门用于从网站自动提取数据的软件程序。它们可用于收集信息以满足各种需求,包括数据分析、研究、价格监控等。我们将带您了解网页抓取工具的世界,并解释它们如何帮助您实现目标。
网页抓取工具的工作原理是向网站发送请求,然后从网站返回的 HTML 代码中提取数据。这些数据随后可以被存储和分析以获取洞察,或用于其他目的。
使用网络爬虫工具的主要优势包括节省时间、减少人工操作,以及从多个来源收集海量数据。借助网络爬虫工具,您可以快速、轻松地收集所需数据,从而腾出时间处理其他重要任务。
网络爬虫工具主要有几种类型,包括基于云的爬虫、本地爬虫和浏览器扩展程序。每种工具都有其独特的功能和优势,适合您的工具将取决于您的具体需求和目标。
在选择网络爬虫工具时,请考虑易用性、速度和成本等因素。同时,您还需要考虑需要爬取的数据类型,因为某些工具可能无法处理复杂或动态的网站。
以下是一些最受欢迎的网页抓取工具:
Beautiful Soup:Beautiful Soup 是一个 Python 库,可轻松从 HTML 和 XML 文件中抓取数据。它是最常用的网页抓取工具之一,非常适合处理复杂且格式混乱的网站。
Scrapy:Scrapy 是另一款用于网页抓取的 Python 库。它比 Beautiful Soup 功能更强大,但使用起来也更复杂。如果您有 Python 编程经验,Scrapy 是进行大规模网页抓取项目的绝佳选择。
Octoparse:Octoparse 爬虫 是一款基于 Windows 的网页爬取工具,无需编写代码。它易于使用,并提供可视化界面来构建网页爬取工作流。
Parsehub: Parsehub 是一款基于网页的网络爬虫工具,无需编写代码。它与 Octoparse 类似,但只要有网页浏览器,即可在任何操作系统上运行。
WebHarvy:WebHarvy 是另一款无需编写代码的可视化网络爬虫工具。 它易于使用,同时支持 Windows 和 Mac 系统。
Scraper API:Geonode 提供的灵活网页抓取工具旨在让开发者(无论初学者还是资深人士)都能轻松高效地进行网页抓取。
以上仅是众多网页抓取工具中的一小部分。 在选择工具时,需要综合考虑您的技术水平、项目规模以及具体需求。无论您选择哪种工具,您都会发现网络爬虫是一种从网络上收集数据的宝贵且高效的方式。
网页抓取过程可分为以下几个步骤:
通过遵循这些步骤,您可以有效地从网站抓取数据,并利用这些数据获取洞察或为您的商业决策提供支持。
网页抓取工具是十分实用的工具,能帮助您快速高效地获取所需数据。网页抓取工具种类繁多,您可以利用它们获取各种类型的数据。
借助合适的工具,您可以优化数据采集流程,从而节省大量时间和精力。在选择工具时,务必综合考虑您的技术水平、项目规模以及具体需求。
如果您想尝试一款出色的网页抓取工具,不妨看看 Geonode 的 Scraper API。您可以免费试用,看看它是否适合您并能满足您的需求。