从 redfin.com 等平台获取房地产数据,已成为许多企业的必要之举。
无论您是房地产分析师、数据科学家,还是单纯的技术爱好者,了解如何抓取Redfin数据都能为您带来极具价值的洞见。
本综合指南将带您了解高效且符合道德规范地抓取Redfin数据的最佳实践、工具和方法。

Maricor Bunal
更新于:2026年10月7日
发布于:2023年8月29日
探索 Redfin.com 数据抓取的终极指南。深入了解专家见解、工具和技巧,轻松提取有价值的房地产数据。
从 redfin.com 等平台获取房地产数据,已成为许多企业的必要之举。
无论您是房地产分析师、数据科学家,还是单纯的技术爱好者,了解如何抓取Redfin数据都能为您带来极具价值的洞见。
本综合指南将带您了解高效且符合道德规范地抓取Redfin数据的最佳实践、工具和方法。
Redfin是一家知名的房地产网站,提供待售房源信息、房地产市场数据及其他相关服务。
Redfin 成立于 2004 年,现已发展成为房地产行业的领先平台之一,为用户提供了一个操作简便的界面,支持用户根据房产类型、位置、价格范围、卧室数量等多种条件搜索房源。
Redfin的一大特色在于其详尽的房源详情页,这些页面提供了关于房产的全面信息,包括高分辨率照片、房产历史以及社区概况。
此外,Redfin还提供诸如“Redfin估价”等工具,可为房屋提供市场价值估算,以及交互式地图搜索功能,让用户能够探索特定社区或地区的房产。
对于希望收集房源信息、市场趋势或其他房产详情的经纪人、代理或个人而言,Redfin是一个极具价值的资源。
房地产数据不仅仅是数字和房源信息;它是市场脉搏的体现。
每一处挂牌房产、每一次价格变动以及每笔成交,都讲述着关于社区、经济和消费者行为的故事。
通过抓取 Redfin(领先的房地产平台之一)的数据,房地产经纪人和企业可以获取宝贵的数据资源。
这些数据能为房产价值、市场趋势和社区偏好提供深刻见解。
在这个由数据驱动的世界里,拥有及时且准确的房地产信息,对于从投资者到城市规划师的众多利益相关者而言,都可能成为改变游戏规则的关键。
市场分析对于任何希望做出明智决策的企业或投资者都至关重要。借助 Redfin 房地产数据,分析师可以:
虽然数据抓取能提供海量数据,但必须以负责任的态度对待。以下是一些需要考虑的伦理准则:
尊重 robots.txt 文件。 Redfin 网站上的此文件指明了网站的哪些部分可以访问和抓取。无视该文件不仅有违道德,还可能导致法律后果。
避免给服务器造成过载。 在短时间内发送过多请求可能会导致 Redfin 网站运行缓慢或崩溃。 必须合理间隔请求,以免干扰网站的正常运行。
数据隐私。 无论何时使用数据(尤其是从 Redfin 抓取的数据)时都要保持谨慎,特别是当数据包含个人信息时。滥用此类数据可能会导致严重的法律和道德后果。
网络爬虫已成为从 Redfin 等在线来源提取有价值信息不可或缺的方法。以下介绍几种可用的工具和技术,它们各有其独特的优势和局限性:
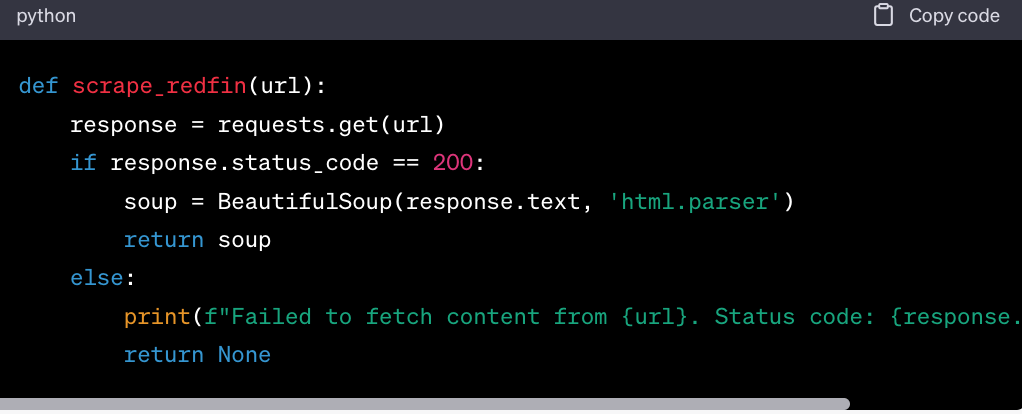
Requests 用于获取网页,BeautifulSoup 用于解析 HTML 内容。手动抓取是指从网站上人工复制数据,并将其粘贴到所需格式或工具中的过程。
这种方法也被称为屏幕抓取,虽然劳动强度大且耗时,但可用于小型任务,或在无法进行自动化抓取的情况下使用。
安装 Python。 请确保您的系统已安装 Python。若未安装,请从 Python 官方网站下载并安装。
安装所需库。 您需要几个 Python 库来辅助数据抓取。请使用 pip 安装它们。
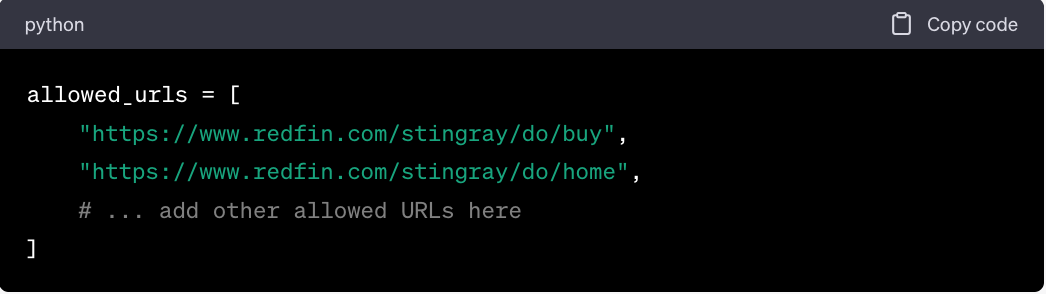
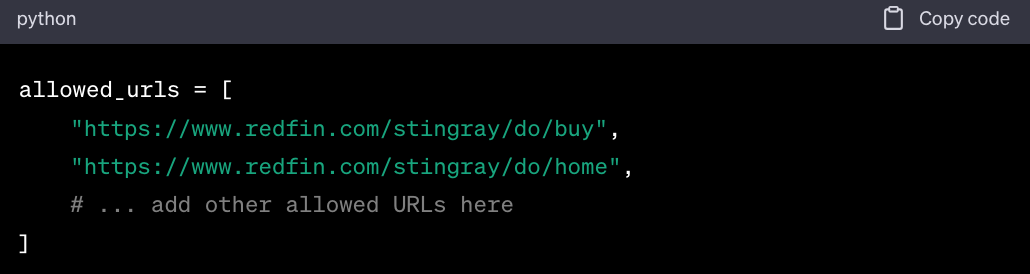
以下是 Redfin 的 robots.txt 文件 中允许访问的部分搜索 URL:
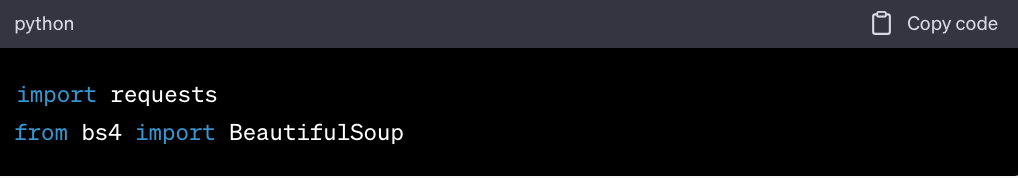
导入必要库
定义爬虫函数
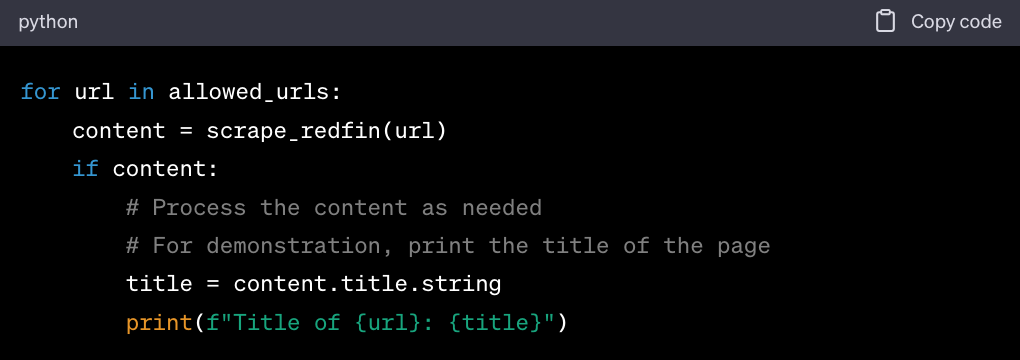
遍历允许的 URL 并进行爬取
完成内容抓取后,您可以根据需要对数据进行处理。例如,您可能需要提取特定数据点、清理数据,或者将其存储到数据库或文件中。
提取数据。 使用 BeautifulSoup 的函数(如 find()、find_all() 等),从抓取的内容中提取特定数据。
**清理数据。**确保数据符合预期格式,删除任何不需要的字符或空格,并处理任何缺失或不一致的数据点。
**存储数据。**根据您的需求,您可以将数据存储在数据库中、写入 CSV 文件,或以任何其他所需格式保存。
安装 Python。 如果您尚未安装,请从 Python 官方网站 下载并安装 Python。
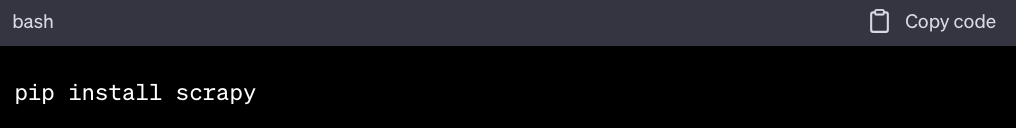
安装 Scrapy。
打开终端或命令提示符。
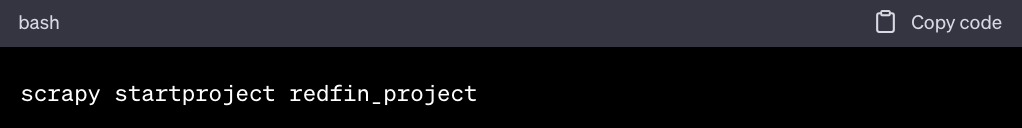
导航至您想要创建 Scrapy 项目的目录。
运行以下命令:
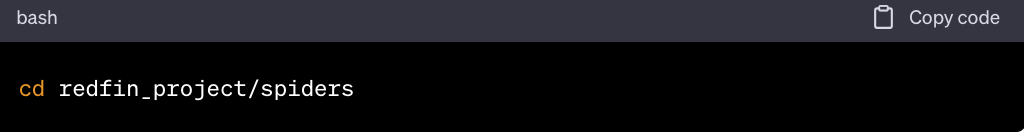
进入 redfin_project 目录下的 spiders 目录:
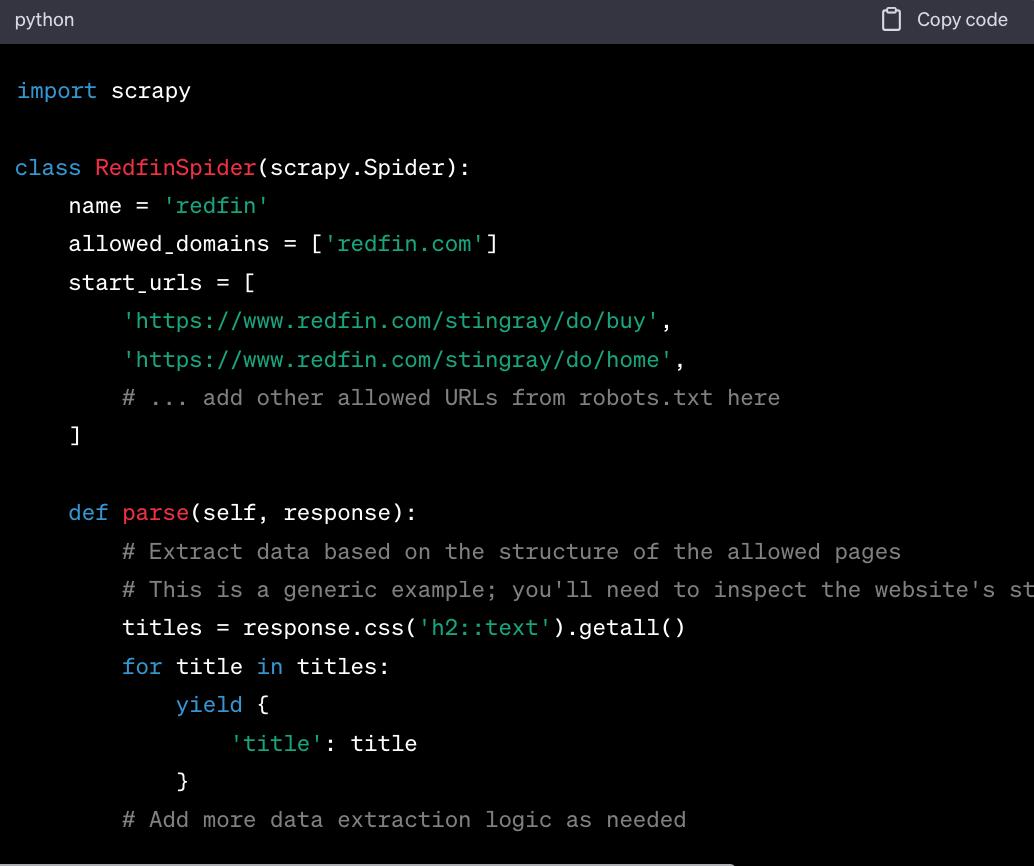
创建一个名为 redfin_spider.py 的新文件。
使用您喜欢的文本编辑器打开 redfin_spider.py,并添加以下代码:
返回 Scrapy 项目的根目录(redfin_project)。
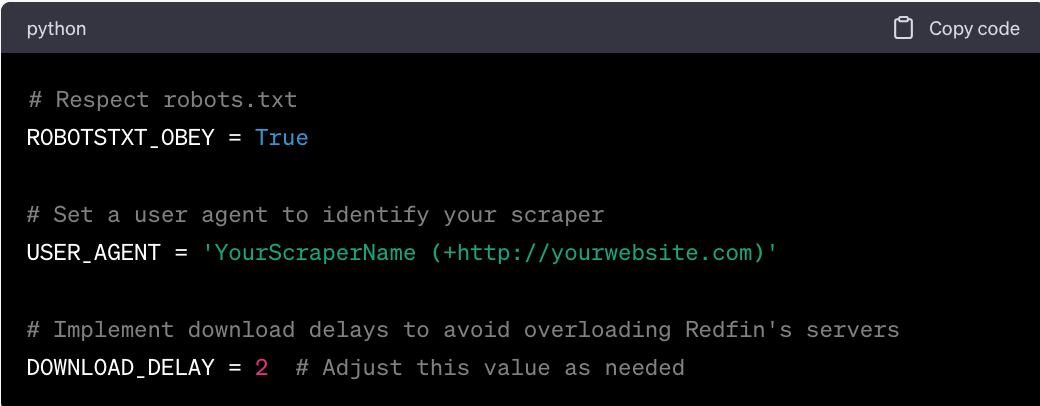
在文本编辑器中打开 settings.py。
修改或添加以下设置,以遵守 Redfin 的 robots.txt 规定并避免被封禁:
打开终端或命令提示符。
导航至 Scrapy 项目的根目录(redfin_project)。
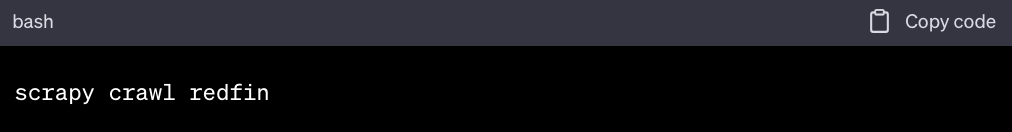
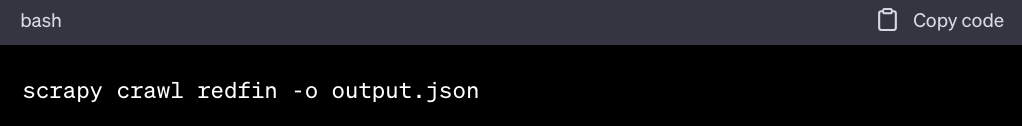
使用以下命令运行爬虫:
默认情况下,Scrapy 会将抓取的数据输出到控制台。若要将数据保存到文件中:
请将命令修改为:
这将把抓取的数据以 JSON 格式保存到名为 output.json 的文件中。您也可以通过更改文件扩展名来使用 CSV 等其他格式。
安装 Python:若尚未安装,请从 Python 官方网站 下载并安装 Python。
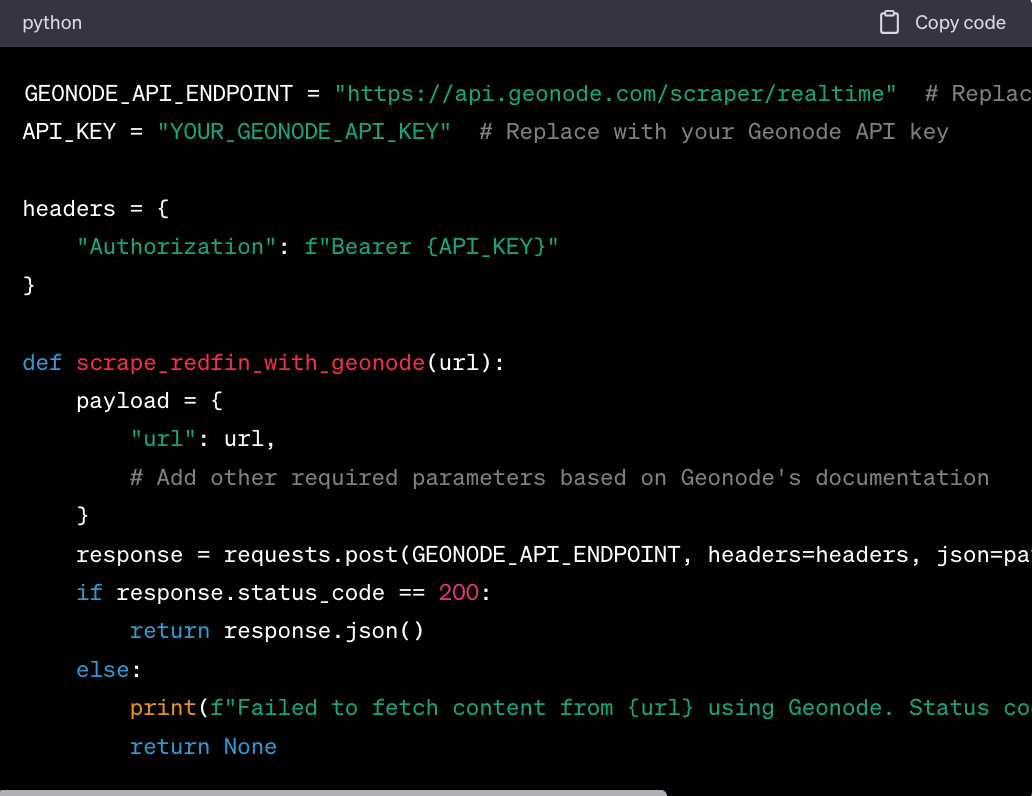
安装所需库:您需要安装 requests 库,以便向 Geonode 的 Scraper API 发起 API 调用:
以下是一部分允许抓取的 URL:
导入必要库:
定义抓取函数:
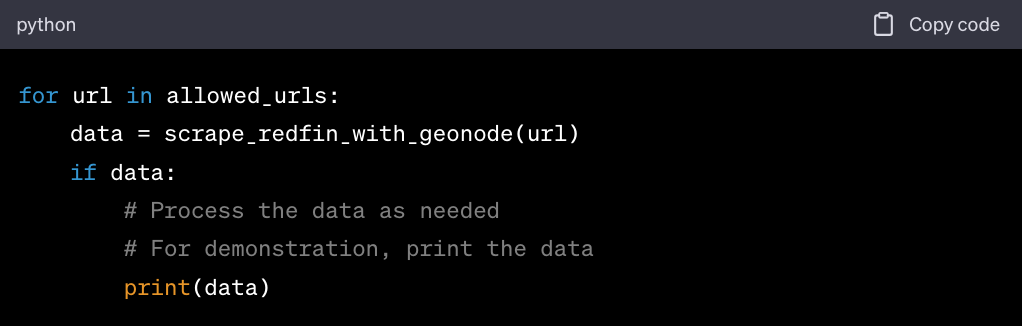
遍历允许的 URL 并进行抓取:
完成内容抓取后,您可以根据需要对数据进行处理。例如,您可能需要提取特定的数据点、清理数据,或者将其存储在数据库或文件中。
无论您使用哪种 Redfin 抓取工具,请务必:
检查并优化数据。 首次抓取完成后,请审查已收集的数据,确保其准确且完整。
如有必要,请优化抓取逻辑,以捕获任何遗漏的数据或提高数据质量。
定期监控。 如果您计划定期抓取 Redfin 数据,请监控抓取工具的性能及其收集的数据。
网站可能会更改其结构,这可能会导致您的抓取工具失效。定期监控有助于您及早发现并解决问题。
网页抓取是一项强大的工具,但同时也伴随着一系列挑战,尤其是在处理像Redfin这样复杂的网站时。
挑战:像Redfin这样的现代网站会使用JavaScript动态加载内容。 仅获取 HTML 源代码的传统抓取工具可能会遗漏这些动态加载的内容。
解决方案:
浏览器自动化工具。 像 Selenium 这样的工具可以模拟真实浏览器的行为,从而让你抓取动态加载的内容。
借助 Selenium,您可以等待特定元素加载完毕,与下拉菜单进行交互,甚至通过滚动页面来触发内容加载。
检查网络请求。 使用浏览器开发者工具,检查网站发出的网络请求。 通常,动态内容是通过 AJAX 调用内部 API 加载的。
如果您能识别出这些调用,就可以直接向其请求数据,从而可能以 JSON 等结构化格式获取数据。
挑战:Redfin 可能会采取反爬虫措施,以防止自动化机器人访问其数据。这些措施可能包括验证码、速率限制,甚至 IP 封禁。
解决方案:
遵守 robots.txt. 始终首先检查网站的 robots.txt 文件。 该文件提供了关于网站哪些部分可供网络爬虫访问的指导原则。
用户代理轮换。 轮换用户代理以模拟不同的浏览器和设备。这有助于绕过针对特定用户代理的限制。
IP 轮换。 使用 Geonode 住宅代理 来轮换 IP 地址。如果某个 IP 被封禁,爬虫可以切换到另一个。
速率限制。 在请求之间设置延迟,以避免在短时间内发送过多请求。 这有助于防止 IP 被封禁,并体现对网站服务器的尊重。
验证码处理。 2Captcha 或 Anti-Captcha 等工具提供验证码识别服务。此外,也可考虑使用浏览器自动化工具,在验证码出现时手动进行识别。
挑战:网络爬取有时会导致数据不完整或不准确,特别是当网站结构发生变化或数据呈现方式不一致时。
解决方案:
定期监控。 持续监控爬虫的运行状况。若发现数据缺失或不准确,可能是由于网站结构发生变化所致。
错误处理。 在爬虫中实现强大的错误处理机制。如果爬虫遇到错误,应能够记录该错误并继续执行,或重试请求,以确保临时问题不会导致数据丢失。
数据验证。 抓取完成后,对数据进行验证,以确保其符合特定标准或格式。例如,抓取房产价格时,需确保数据为数值且在合理范围内。
备份。 务必始终保留抓取数据的备份。 若发现爬虫或其收集的数据存在问题,备份可让您恢复到之前的状态。
通过理解并应对这些挑战,您可以确保您的网络爬取工作更加成功、符合道德规范,并能够适应不断变化的网络环境。
网络爬虫最初只是从网页中提取静态内容的一种简单手段。
早期的网站结构简单,抓取它们只需下载 HTML 并进行解析即可。
如今,像 Redfin 这样的网站已变得动态、交互性强且功能丰富。它们能够即时加载内容、响应用户交互,甚至能根据用户行为提供个性化内容。
这种演变使得数据抓取变得更加具有挑战性,但也带来了更大的回报。从浏览器自动化到机器学习,现代工具和技术应运而生,以应对这些挑战。
房地产市场充满活力,房源信息和价格趋势瞬息万变。对实时数据和可操作洞察的需求将推动数据抓取技术的创新,促使数据提取速度更快、频率更高。
随着数据价值的不断提升,围绕数据抓取的法律和伦理考量将日益凸显。
我们可以预期,将出台更多明确的指导方针和法规,规范哪些数据可以抓取、哪些不能抓取,从而确保数据抓取过程尊重隐私和知识产权。
网络爬虫是一种强大的工具,但拥有这种力量的同时,也意味着必须以符合道德的方式使用它。当您出于各种需求爬取 Redfin 等网站时,请始终将尊重、诚信和公平放在首位。
通过数据抓取,您可以确保在获取数据的过程中,绝不损害维系数字社区的共同价值观。