¿Qué es el web scraping?
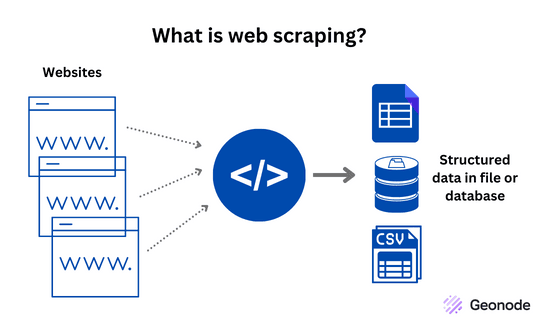
El web scraping, también conocido como extracción de datos web o recolección de datos web, es el proceso de extraer datos de sitios web mediante software automatizado. Se puede realizar de forma manual, como al copiar y pegar datos a mano, o de forma automática, como al extraer información mediante un programa de web scraping.
Hacerlo a mano requiere tiempo y esfuerzo, sobre todo si se quiere extraer grandes volúmenes de datos. Por eso, la mayoría de los usuarios prefieren utilizar rastreadores web para que hagan el trabajo por ellos. Esta tecnología permite a particulares y organizaciones recopilar información de múltiples fuentes de forma rápida y eficaz.
¿Qué tipo de datos se pueden extraer de la web?
Hay muchos tipos diferentes de datos que se pueden extraer de la web, entre ellos:
Datos de texto. Esto incluye desde titulares, artículos y descripciones de productos hasta comentarios, reseñas y mucho más.
Imágenes y vídeos. Se pueden extraer fotos y vídeos de sitios web, incluyendo imágenes de productos, infografías y mucho más.
Datos estructurados. Este tipo de datos está organizado en un formato específico, como tablas, hojas de cálculo y bases de datos. Algunos ejemplos de datos estructurados son los listados de productos, los anuncios inmobiliarios y los datos financieros.
Datos no estructurados. Este tipo de datos no está organizado en un formato específico y puede incluir elementos como publicaciones en redes sociales, comentarios y mucho más.
Metadatos. Este tipo de datos proporciona información sobre otros tipos de datos, como la fecha de la última actualización de una página web, el autor de una publicación y mucho más.
Al comprender los diferentes tipos de datos disponibles para el web scraping, podrás determinar qué datos son más útiles para tus necesidades específicas y desarrollar una estrategia para extraerlos de forma eficaz.
¿Es legal el web scraping?
El web scraping es legal, aunque a los sitios web no les hace mucha gracia que los usuarios extraigan datos de sus páginas. Si detectan que estás utilizando un programa de web scraping o cualquier otra herramienta de automatización en su sitio web, bloquearán inmediatamente tu cuenta y añadirán tu dirección IP a la lista negra.
Si quieres saber más sobre la legalidad del web scraping, puedes leer un artículo detallado al respecto aquí: Legalidad y mitos del web scraping.
¿Cómo funcionan los rastreadores web?
En esencia, el rastreo web es un proceso que consiste en enviar una solicitud al servidor de un sitio web, descargar el código HTML y, a continuación, extraer la información deseada. La solicitud suele realizarse mediante una herramienta de rastreo web o un enfoque programático, como el uso de un lenguaje de programación como Python.
Una vez recibido el código HTML, la herramienta o el programa de scraping analiza el código para encontrar los datos específicos que se desean extraer. Esto suele hacerse mediante una técnica denominada «extracción de datos», que utiliza reglas o patrones para extraer información del código HTML.
A continuación, los datos extraídos se almacenan en un formato estructurado, como una hoja de cálculo o una base de datos, para su posterior análisis o uso.
¿Cuáles son los diferentes tipos de extractores web?
Existen varios tipos diferentes de extractores web, cada uno con su propio conjunto de características y capacidades. En esta guía, analizaremos los diferentes tipos de extractores web para que puedas elegir el que mejor se adapte a tus necesidades.
Scrapers de pantalla simples
Los scrapers de pantalla simples son el tipo más básico de scrapers web. Extraen datos de sitios web copiando y pegando la información del sitio web en un archivo local. Suelen utilizarse para proyectos a pequeña escala y no requieren muchos conocimientos técnicos.
Scrapers de pantalla complejos
Los scrapers de pantalla complejos son más avanzados que los simples y se utilizan para proyectos a mayor escala. Extraen datos de sitios web utilizando scripts para automatizar el proceso de extracción, lo que lo hace más rápido y eficiente. Los scrapers de pantalla complejos suelen utilizar API para acceder a los datos, lo que les permite extraer mayores cantidades de información.
Navegadores sin interfaz gráfica
Los navegadores sin interfaz gráfica son extractores web que no utilizan una interfaz gráfica de usuario. Funcionan en segundo plano y extraen datos de sitios web sin mostrar la página en una ventana del navegador.
Los navegadores sin interfaz son útiles para el scraping web porque son más rápidos y eficientes que los navegadores web tradicionales, y permiten extraer datos de sitios web sin tener que cargar la página completa.
Rastreadores web
Los rastreadores web son un tipo de rastreador web diseñado para recorrer sitios web de gran tamaño, extrayendo información de múltiples páginas. Funcionan comenzando en una página específica y siguiendo luego los enlaces a otras páginas, extrayendo información a medida que avanzan.
Los rastreadores web se utilizan para una amplia gama de tareas, desde recopilar información para motores de búsqueda hasta supervisar los cambios en los sitios web.
Scrapers web de desarrollo propio
Los scrapers web de desarrollo propio son herramientas de scraping que crean personas u organizaciones por sí mismas utilizando lenguajes de programación como Python, Ruby o JavaScript. Este enfoque les permite adaptar su scraper web específicamente a sus necesidades, como extraer datos de un sitio web concreto, un tipo de datos específico o con una frecuencia determinada.
Los rastreadores web de desarrollo propio suelen requerir más conocimientos técnicos y tiempo en comparación con el uso de una solución lista para usar. Sin embargo, la ventaja de este enfoque es que el rastreador web resultante puede personalizarse en gran medida, lo que proporciona un mayor control sobre el proceso de extracción y los datos obtenidos.
Scrapers web en forma de extensión de navegador
Un scraper web en forma de extensión de navegador es una herramienta de software que se integra directamente en tu navegador web y automatiza el proceso de extracción de datos de sitios web. Este tipo de scraper está diseñado para funcionar a la perfección dentro de tu navegador, lo que te permite acceder fácilmente a los datos que necesitas sin tener que cambiar entre diferentes programas o aplicaciones.
Con un extractor web en forma de extensión de navegador, puedes seleccionar fácilmente los datos que deseas extraer y configurar los parámetros de la extracción. El extractor se encargará del resto. Extraerá los datos que necesitas y los presentará en un formato claro y organizado, lo que te ahorrará tiempo y esfuerzo en comparación con la extracción manual.
Extractores web con interfaz de usuario
Un extractor web con interfaz de usuario funciona mostrando al usuario una interfaz en la que puede seleccionar los datos que desea extraer. El usuario puede interactuar con la interfaz, seleccionar los datos que desea extraer y el extractor se encargará del resto. Puede rastrear automáticamente el sitio web, extraer los datos y guardarlos en un formato estructurado, como CSV, Excel o una base de datos.
Una de las principales ventajas de utilizar un extractor web con interfaz de usuario es que elimina la necesidad de tener conocimientos de programación. Basta con señalar y hacer clic para seleccionar los datos que se desean extraer. Esto lo convierte en una opción excelente para quienes desean realizar tareas sencillas de extracción de datos sin necesidad de conocimientos técnicos.
Otra ventaja de los rastreadores web con interfaz de usuario es su facilidad de uso. Están diseñados para ser intuitivos, y puedes empezar a utilizarlos rápidamente sin tener que aprender a manejar un nuevo software. Solo tienes que seguir los pasos y obtendrás tus datos en un abrir y cerrar de ojos.
Rastreadores web en la nube
Un extractor web en la nube es una herramienta que te permite ejecutar tareas de extracción de datos web en una infraestructura basada en la nube. En lugar de utilizar tu ordenador para realizar la extracción, puedes aprovechar la potencia de procesamiento de servidores remotos en la nube. Esto significa que puedes extraer datos de sitios web a gran escala y gestionar mayores volúmenes de datos sin preocuparte por las limitaciones de tu hardware local.
Una de las principales ventajas de utilizar rastreadores web en la nube es la capacidad de acceder a una cantidad prácticamente ilimitada de recursos, incluyendo almacenamiento, potencia de procesamiento y ancho de banda. Esto significa que puedes rastrear incluso los sitios web más grandes y complejos sin preocuparte por problemas de rendimiento.
Otra ventaja es la posibilidad de ejecutar tareas de scraping web las 24 horas del día, los 7 días de la semana, sin interrupciones, incluso si tu ordenador está apagado. Esto se debe a que los scrapers web en la nube pueden configurarse para ejecutarse en servidores remotos que están siempre encendidos.
Scrapers web locales
Los scrapers web locales son un tipo de herramienta de scraping web que se ejecuta en tu ordenador, en lugar de en un servidor remoto en la nube. Son una buena opción para proyectos de scraping web a pequeña escala, en los que solo necesitas extraer una cantidad limitada de datos. También son una buena opción si te preocupa la privacidad de los datos o si necesitas extraer información de sitios web a los que no se puede acceder desde la red pública de Internet.
Una de las principales ventajas de utilizar un extractor web local es que es fácil de configurar y utilizar. No es necesario tener conocimientos especializados ni habilidades técnicas para empezar, y puedes comenzar a extraer datos de inmediato.
Otra ventaja es que tienes control total sobre el proceso de extracción. Puedes configurar el extractor para que extraiga los datos en el formato que necesites, y también puedes establecer la frecuencia y la programación de las tareas de extracción.
¿Cuáles son los lenguajes de programación más populares para el web scraping?
Se pueden utilizar muchos lenguajes de programación para el web scraping, cada uno con sus puntos fuertes y débiles. A continuación, analizaremos algunos de los lenguajes de programación más populares para el web scraping.
Python: Python es uno de los lenguajes de programación más populares para el web scraping. Cuenta con una comunidad amplia y activa, que ha desarrollado numerosas bibliotecas y herramientas específicas para esta tarea. BeautifulSoup y Scrapy son dos de las bibliotecas de Python más utilizadas para el web scraping.
Ruby: Ruby es otro lenguaje de programación popular para el web scraping. Cuenta con una comunidad numerosa y activa, y hay muchas bibliotecas y herramientas disponibles para esta tarea. Nokogiri es una biblioteca de Ruby muy utilizada para el web scraping.
JavaScript: JavaScript es un lenguaje muy utilizado para el web scraping, ya que se emplea para hacer funcionar muchos sitios web. Con el auge de Node.js, JavaScript se ha convertido en una opción muy utilizada para el scraping web del lado del servidor. Puppeteer es una biblioteca de JavaScript muy utilizada para el scraping web.
PHP: PHP es un lenguaje de programación muy utilizado para el scraping web, ya que se emplea ampliamente para crear sitios web. Existen numerosas bibliotecas y herramientas disponibles para el web scraping con PHP. Simple HTML DOM es una biblioteca de PHP muy utilizada para el web scraping.
Java: Java es un lenguaje de programación muy utilizado para el web scraping debido a su eficiencia y escalabilidad. Existen numerosas bibliotecas y herramientas disponibles para el web scraping con Java, entre las que se incluyen JSoup y HtmlUnit.
¿Para qué se utilizan los rastreadores web?
El rastreo web se utiliza con diversos fines, entre los que se incluyen:
Recopilación de datos: Se puede utilizar para recopilar grandes cantidades de datos de sitios web y convertirlos en información estructurada que pueda utilizarse para el análisis y la investigación. Estos datos pueden utilizarse para tomar decisiones empresariales fundamentadas, realizar un seguimiento de las tendencias del sector y mucho más.
Monitorización de marcas: Se puede utilizar para monitorizar la opinión de los clientes mediante la recopilación de reseñas públicas. Esta información puede ayudarte a mantener e incluso mejorar tu reputación online.
Anuncios inmobiliarios: Se pueden utilizar para recopilar información sobre diversos datos inmobiliarios, como el precio de los inmuebles, el tipo de propiedad, la ubicación y muchos otros aspectos.
Monitorización de precios: Se puede utilizar para supervisar los precios en sitios web de comercio electrónico y realizar un seguimiento de los precios de la competencia. Esta información puede servir para ajustar su estrategia de precios y mantener su competitividad.
Generación de clientes potenciales: Se puede utilizar para recopilar información sobre clientes potenciales y crear listas específicas con fines de ventas y marketing.
Monitorización de redes sociales: Se puede utilizar para monitorizar las redes sociales en busca de menciones a su marca, a la competencia o al sector, y recopilar información y datos valiosos sobre su público.
Inteligencia de precios: Se puede utilizar para recopilar y comparar información sobre los precios de productos a nivel mundial y reunirla toda en un solo lugar.
Monitorización de noticias y contenidos: Se puede utilizar para recopilar información de múltiples fuentes, incluidos sitios web de noticias, y compilarla en un solo lugar, lo que facilita su acceso y análisis.
Ofertas de empleo: Se puede utilizar para recopilar ofertas de empleo de diversos sitios web y reunirlas en un único lugar, lo que facilita la búsqueda de oportunidades laborales.
Agregación de viajes: Se puede utilizar para recopilar información de numerosos sitios web de hoteles y compañías aéreas y reunirla en un único lugar.
¿Qué es una herramienta de web scraping?
Las herramientas de web scraping son programas de software diseñados para extraer datos automáticamente de sitios web. Se utilizan para recopilar información con diversos fines, como el análisis de datos, la investigación, el seguimiento de precios y mucho más. Te presentaremos el mundo de las herramientas de web scraping y te explicaremos cómo pueden ayudarte a alcanzar tus objetivos.
¿Cómo funcionan las herramientas de web scraping?
Las herramientas de web scraping funcionan enviando una solicitud a un sitio web y, a continuación, extrayendo los datos del código HTML que devuelve dicho sitio web. Estos datos pueden almacenarse y analizarse para obtener información útil o utilizarse para otros fines.
¿Cuáles son las ventajas de utilizar una herramienta de web scraping?
Las principales ventajas de utilizar una herramienta de web scraping incluyen el ahorro de tiempo, la reducción del trabajo manual y la recopilación de grandes cantidades de datos procedentes de múltiples fuentes. Con una herramienta de web scraping, puedes recopilar rápida y fácilmente los datos que necesitas, lo que te permite disponer de más tiempo para otras tareas importantes.
¿Qué tipos de herramientas de web scraping existen?
Existen varios tipos diferentes de herramientas de web scraping, entre las que se incluyen los scrapers basados en la nube, los scrapers locales y las extensiones de navegador. Cada tipo de herramienta tiene sus propias características y ventajas, y la herramienta más adecuada para ti dependerá de tus necesidades y objetivos específicos.
¿Cómo elegir una herramienta de web scraping?
A la hora de elegir una herramienta de web scraping, ten en cuenta factores como la facilidad de uso, la velocidad y el coste. También es importante considerar el tipo de datos que necesitas extraer, ya que es posible que algunas herramientas no sean capaces de gestionar sitios web complejos o dinámicos.
¿Qué herramientas puedes utilizar para extraer datos de la web?
Estas son algunas de las herramientas de web scraping más populares que existen:
Beautiful Soup: Beautiful Soup es una biblioteca de Python que facilita la extracción de datos de archivos HTML y XML. Es una de las herramientas de web scraping más utilizadas y resulta ideal para gestionar sitios web complejos y con un formato deficiente.
Scrapy: Scrapy es otra biblioteca de Python para el scraping web. Es más potente que Beautiful Soup, pero también más compleja. Si tienes experiencia con Python, Scrapy es una opción estupenda para proyectos de scraping web a gran escala.
Octoparse: El extractor Octoparse es una herramienta para Windows destinada a la extracción de datos de la web que no requiere programación. Es fácil de usar y ofrece una interfaz visual para crear flujos de trabajo de extracción de datos.
Parsehub: Parsehub es una herramienta web para el scraping que no requiere programación. Es similar a Octoparse, pero funciona en cualquier sistema operativo que disponga de un navegador web.
WebHarvy: WebHarvy es otra herramienta visual de scraping que no requiere programación. Es fácil de usar y es compatible tanto con Windows como con Mac.
Scraper API: el flexible extractor web de Geonode está diseñado para que el scraping web resulte fácil y eficiente para los desarrolladores, tanto si son principiantes como si tienen mucha experiencia.
Estas son solo algunas de las muchas herramientas de scraping web disponibles. A la hora de elegir una herramienta, es importante tener en cuenta tu nivel de conocimientos técnicos, la envergadura de los proyectos en los que vas a trabajar y tus necesidades específicas. Independientemente de la herramienta que elijas, seguro que descubrirás que el web scraping es una forma valiosa y eficaz de recopilar datos de la web.
¿En qué consiste el proceso de web scraping?
El proceso de web scraping se puede dividir en varios pasos:
- Determinar la página web de destino y los datos que se van a extraer: El primer paso consiste en identificar la página web de la que se quieren extraer datos y los datos específicos que se desean recopilar.
- Analizar el sitio web: Antes de empezar a extraer datos, es importante analizar el sitio web para comprender cómo está estructurado y qué datos están disponibles. Esto puede ayudarte a identificar las herramientas y técnicas adecuadas que debes utilizar para el proceso de extracción.
- Elige una herramienta de extracción de datos o escribe código: Existen muchas herramientas disponibles para la extracción de datos web, tanto de código abierto como de pago. Algunas opciones populares son BeautifulSoup, Scrapy y Selenium. Como alternativa, puedes escribir tu propio código para extraer datos del sitio web utilizando un lenguaje de programación como Python o Java.
- Escribe el código o configura la herramienta de extracción: Una vez que hayas elegido una herramienta o hayas decidido escribir tu propio código, tendrás que configurarla para extraer los datos que deseas del sitio web. Esto puede implicar escribir código para navegar por el sitio web y extraer elementos específicos, o configurar la herramienta de extracción para que identifique los datos que te interesan.
- Ejecuta el rastreador: Una vez configurado tu código o la herramienta de rastreo, puedes ejecutar el rastreador para extraer los datos del sitio web. Dependiendo del tamaño del sitio web y de la cantidad de datos que quieras recopilar, este proceso puede tardar varios minutos o incluso horas.
- Limpia y analiza los datos: El paso final consiste en limpiar y analizar los datos que has recopilado. Esto puede implicar eliminar datos irrelevantes, dar a los datos un formato utilizable y realizar cualquier análisis necesario para obtener información útil a partir de ellos.
Siguiendo estos pasos, podrás extraer datos de sitios web de forma eficaz y utilizarlos para obtener información útil o respaldar tus decisiones empresariales.
Reflexiones finales
Los rastreadores web son herramientas útiles que te ayudan a obtener los datos que necesitas de forma rápida y eficaz. Existen muchos tipos diferentes de rastreadores web y puedes utilizarlos para obtener diversos tipos de datos.
Con las herramientas adecuadas, puedes optimizar el proceso de recopilación y ahorrarte mucho tiempo y esfuerzo. A la hora de elegir una herramienta, es importante tener en cuenta tu nivel de conocimientos técnicos, la envergadura de los proyectos en los que vas a trabajar y tus necesidades específicas.
Si quieres probar una excelente herramienta de scraping web, puedes echar un vistazo a Scraper API de . Puedes probarla gratis y ver si se adapta a ti y a tus necesidades.