Qu'est-ce que le web scraping ?
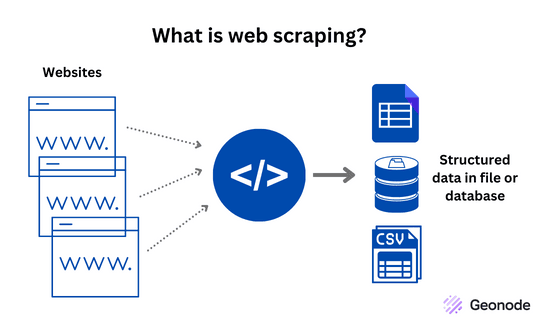
Le web scraping, également appelé « extraction de données web » ou « collecte de données web », désigne le processus consistant à extraire des données de sites web à l'aide de logiciels automatisés. Cette opération peut être effectuée soit manuellement, par exemple en copiant-collant les données à la main, soit automatiquement, par exemple en extrayant des informations à l'aide d'un outil de web scraping.
Le faire à la main demande du temps et des efforts, surtout si vous souhaitez extraire de grands volumes de données. C’est pourquoi la plupart des utilisateurs préfèrent recourir à des outils de web scraping pour effectuer cette tâche à leur place. Cette technologie permet aux particuliers et aux organisations de collecter des informations provenant de multiples sources de manière rapide et efficace.
Quels types de données peut-on extraire du Web ?
Il existe de nombreux types de données que l'on peut extraire du Web, notamment :
Données textuelles. Cela inclut tout, des titres, articles et descriptions de produits aux commentaires, avis et bien plus encore.
Images et vidéos. Vous pouvez extraire des photos et des vidéos de sites web, notamment des images de produits, des infographies, etc.
Données structurées. Ce type de données est organisé selon un format spécifique, tel que des tableaux, des feuilles de calcul et des bases de données. Parmi les exemples de données structurées, on peut citer les fiches produits, les annonces immobilières et les données financières.
Données non structurées. Ce type de données n’est pas organisé selon un format spécifique et peut inclure des éléments tels que des publications sur les réseaux sociaux, des commentaires, etc.
Métadonnées. Ce type de données fournit des informations sur d’autres types de données, telles que la date de la dernière mise à jour d’une page web, l’auteur d’une publication, etc.
En comprenant les différents types de données disponibles pour le web scraping, vous pouvez déterminer quelles données sont les plus utiles pour vos besoins spécifiques et élaborer une stratégie pour extraire efficacement ces données.
Le web scraping est-il légal ?
Le web scraping est légal, même si les sites web ne voient pas d’un très bon œil que des utilisateurs extraient des données de leurs pages. S’ils détectent que vous utilisez un outil de web scraping ou tout autre outil d’automatisation sur leur site, ils bloqueront immédiatement votre compte et mettront votre adresse IP sur liste noire.
Si vous souhaitez en savoir plus sur la légalité du web scraping, vous pouvez lire un article détaillé à ce sujet ici : Légalité et mythes du web scraping.
Comment fonctionnent les outils de web scraping ?
Fondamentalement, le web scraping est un processus qui consiste à envoyer une requête au serveur d’un site web, à télécharger le code HTML, puis à extraire les informations souhaitées. La requête est généralement effectuée à l’aide d’un outil de web scraping ou d’une approche programmatique, par exemple en utilisant un langage de programmation tel que Python.
Une fois le code HTML reçu, l'outil ou le programme de scraping analyse le code pour trouver les données spécifiques que vous souhaitez extraire. Cette opération s'effectue souvent à l'aide d'une technique appelée « extraction de données », qui utilise des règles ou des modèles pour extraire des informations du code HTML.
Les données extraites sont ensuite stockées dans un format structuré, tel qu’une feuille de calcul ou une base de données, en vue d’une analyse ou d’une utilisation ultérieure.
Quels sont les différents types de web scrapers ?
Il existe plusieurs types de web scrapers, chacun doté de ses propres fonctionnalités et capacités. Dans ce guide, nous allons passer en revue les différents types de web scrapers afin que vous puissiez choisir celui qui correspond le mieux à vos besoins.
Les scrapers d'écran simples
Les scrapers d'écran simples constituent le type le plus basique de scrapers web. Ils extraient des données de sites web en copiant-collant les informations du site vers un fichier local. Ils sont généralement utilisés pour des projets à petite échelle et ne nécessitent pas beaucoup de connaissances techniques.
Scrapers d’écran complexes
Les scrapers d’écran complexes sont plus avancés que les scrapers d’écran simples et sont utilisés pour des projets à plus grande échelle. Ils extraient des données de sites web à l’aide de scripts qui automatisent le processus de scraping, le rendant ainsi plus rapide et plus efficace. Les scrapers d’écran complexes utilisent souvent des API pour accéder aux données, ce qui leur permet d’extraire de plus grandes quantités d’informations.
Navigateurs sans interface graphique
Les navigateurs sans interface graphique sont des outils de scraping qui n’utilisent pas d’interface utilisateur graphique. Ils fonctionnent en arrière-plan et extraient les données des sites web sans afficher le site dans une fenêtre de navigateur.
Les navigateurs sans interface sont utiles pour le web scraping car ils sont plus rapides et plus efficaces que les navigateurs web traditionnels, et ils permettent d’extraire des données de sites web sans avoir à charger la page entière.
Robots d’indexation
Les robots d’indexation sont un type de scraper conçu pour parcourir de grands sites web et extraire des informations de plusieurs pages. Ils commencent par une page spécifique, puis suivent les liens vers d’autres pages, en extrayant des informations au fur et à mesure.
Les robots d'indexation sont utilisés pour un large éventail de tâches, allant de la collecte d'informations pour les moteurs de recherche à la surveillance des modifications apportées aux sites web.
Scrapers web développés en interne
Les scrapers web développés en interne sont des outils de scraping créés par des particuliers ou des organisations à l’aide de langages de programmation tels que Python, Ruby ou JavaScript. Cette approche leur permet d’adapter leur scraper web spécifiquement à leurs besoins, qu’il s’agisse d’extraire un site web particulier, un type de données spécifique ou selon une fréquence donnée.
Les scrapers web développés en interne nécessitent généralement davantage d’expertise technique et de temps que l’utilisation d’une solution prête à l’emploi. Cependant, l’avantage de cette approche réside dans le fait que le scraper web ainsi obtenu peut être hautement personnalisé, offrant un meilleur contrôle sur le processus d’extraction et les données obtenues.
Les scrapers sous forme d’extensions de navigateur
Un scraper sous forme d’extension de navigateur est un outil logiciel qui s’intègre directement à votre navigateur web et automatise le processus d’extraction de données à partir de sites web. Ce type de scraper est conçu pour fonctionner de manière transparente au sein de votre navigateur, vous permettant d’accéder facilement aux données dont vous avez besoin sans avoir à basculer entre différents programmes ou applications.
Avec un scraper sous forme d’extension de navigateur, vous pouvez facilement sélectionner les données que vous souhaitez extraire et définir les paramètres de votre extraction. Le scraper se charge ensuite du reste. Il extrait les données dont vous avez besoin et les présente dans un format clair et organisé, ce qui vous fait gagner du temps et vous épargne des efforts par rapport à une extraction manuelle.
Scrapers web à interface utilisateur
Un scraper web à interface utilisateur fonctionne en proposant à l’utilisateur une interface dans laquelle il peut sélectionner les données qu’il souhaite extraire. L’utilisateur peut interagir avec cette interface, sélectionner les données qu’il souhaite extraire, et le scraper se charge du reste. Il peut automatiquement parcourir le site web, extraire les données et les enregistrer dans un format structuré tel que CSV, Excel ou une base de données.
L’un des principaux avantages de l’utilisation d’un scraper web par interface utilisateur est qu’il ne nécessite aucune connaissance en programmation. Il suffit de pointer et de cliquer pour sélectionner les données que vous souhaitez extraire. Cela en fait une excellente option pour ceux qui souhaitent effectuer des tâches de scraping simples sans avoir besoin d’expertise technique.
Un autre avantage des scrapers web basés sur une interface utilisateur réside dans leur facilité d’utilisation. Conçus pour être intuitifs, ils vous permettent de vous lancer rapidement sans avoir à vous familiariser avec un nouveau logiciel. Il suffit de suivre les étapes indiquées pour obtenir vos données en un clin d’œil.
Scrapers web dans le cloud
Un outil de scraping web dans le cloud est un outil qui vous permet d’exécuter des tâches de scraping web sur une infrastructure cloud. Au lieu d’utiliser votre ordinateur pour effectuer le scraping, vous pouvez exploiter la puissance de calcul de serveurs distants dans le cloud. Cela signifie que vous pouvez extraire des données de sites web à grande échelle et traiter des volumes de données plus importants sans vous soucier des limites de votre matériel local.
L’un des principaux avantages des outils de web scraping dans le cloud réside dans la possibilité d’accéder à une quantité pratiquement illimitée de ressources, notamment en matière de stockage, de puissance de calcul et de bande passante. Vous pouvez ainsi extraire les données même des sites web les plus volumineux et les plus complexes sans vous soucier des problèmes de performances.
Un autre avantage réside dans la possibilité d’exécuter des tâches de web scraping 24 heures sur 24, 7 jours sur 7, sans interruption, même si votre ordinateur est éteint. En effet, les outils de web scraping dans le cloud peuvent être configurés pour fonctionner sur des serveurs distants qui restent toujours allumés.
Scrapers Web locaux
Les scrapers web locaux sont un type d’outil de scraping qui s’exécute sur votre ordinateur, plutôt que sur un serveur distant dans le cloud. C’est un bon choix pour les projets de scraping à petite échelle, où vous n’avez besoin d’extraire qu’une quantité limitée de données. Ils constituent également une bonne option si vous avez des préoccupations concernant la confidentialité des données ou si vous devez extraire des données de sites web inaccessibles depuis l’Internet public.
L’un des principaux avantages de l’utilisation d’un outil de web scraping local réside dans sa simplicité de configuration et d’utilisation. Vous n’avez besoin d’aucune connaissance spécialisée ni d’aucune compétence technique pour vous lancer, et vous pouvez commencer à extraire des données immédiatement.
Un autre avantage réside dans le fait que vous disposez d’un contrôle total sur le processus d’extraction. Vous pouvez configurer l’outil pour qu’il extraie les données au format dont vous avez besoin, et vous pouvez également définir la fréquence et le calendrier des tâches d’extraction.
Quels sont les langages de programmation les plus utilisés pour le web scraping ?
De nombreux langages de programmation peuvent être utilisés pour le web scraping, chacun présentant ses avantages et ses inconvénients. Nous allons passer en revue certains des langages de programmation les plus populaires dans ce domaine.
Python : Python est l'un des langages de programmation les plus populaires pour le web scraping. Il bénéficie d'une communauté importante et active, qui a développé de nombreuses bibliothèques et outils spécialement destinés au web scraping. BeautifulSoup et Scrapy comptent parmi les bibliothèques Python les plus utilisées pour le web scraping.
Ruby : Ruby est un autre langage de programmation populaire pour le web scraping. Il bénéficie d’une communauté importante et active, et de nombreuses bibliothèques et outils sont disponibles pour le web scraping. Nokogiri est une bibliothèque Ruby très utilisée pour le web scraping.
JavaScript : JavaScript est un langage très utilisé pour le web scraping, car il est à la base de nombreux sites web. Avec l’essor de Node.js, JavaScript est devenu un choix courant pour le web scraping côté serveur. Puppeteer est une bibliothèque JavaScript très utilisée pour le web scraping.
PHP : PHP est un langage de programmation très utilisé pour le web scraping, car il est largement employé pour la création de sites web. Il existe de nombreuses bibliothèques et outils disponibles pour le web scraping avec PHP. Simple HTML DOM est une bibliothèque PHP très utilisée pour le web scraping.
Java : Java est un langage de programmation très utilisé pour le web scraping en raison de son efficacité et de son évolutivité. Il existe de nombreuses bibliothèques et outils disponibles pour le web scraping avec Java, notamment JSoup et HtmlUnit.
À quoi servent les outils de web scraping ?
Le web scraping est utilisé à des fins diverses, notamment :
Collecte de données : il permet de collecter de grandes quantités de données sur des sites web et de les transformer en informations structurées pouvant être utilisées à des fins d’analyse et de recherche. Ces données peuvent servir à prendre des décisions commerciales éclairées, à suivre les tendances du secteur, et bien plus encore.
Surveillance de la réputation de marque : cette technique permet de surveiller l’opinion des clients en collectant les avis clients accessibles au public. Ces informations peuvent vous aider à préserver, voire à renforcer, votre réputation en ligne.
Annonces immobilières : Peuvent être utilisées pour recueillir des informations sur diverses données immobilières, notamment le prix des biens, leur type, leur emplacement et bien d’autres encore.
Surveillance des prix : Peut être utilisée pour surveiller les prix sur les sites de commerce électronique et suivre les tarifs pratiqués par la concurrence. Ces informations peuvent servir à ajuster votre stratégie tarifaire et à rester compétitif.
Génération de prospects : Permet de collecter des informations sur des clients potentiels et de constituer des listes ciblées à des fins commerciales et marketing.
Surveillance des réseaux sociaux : Permet de surveiller les réseaux sociaux à la recherche de mentions de votre marque, de vos concurrents ou de votre secteur d’activité, et de recueillir des informations et des données précieuses sur votre audience.
Veille tarifaire : peut être utilisée pour collecter et comparer des informations sur les prix des produits à l’échelle mondiale, puis les regrouper en un seul et même endroit.
Veille de l’actualité et des contenus : peut être utilisée pour collecter des informations provenant de multiples sources, y compris des sites d’actualités, et les compiler en un seul et même endroit, ce qui facilite leur accès et leur analyse.
Offres d’emploi : Permet de rassembler les offres d’emploi provenant de divers sites web et de les regrouper en un seul endroit, facilitant ainsi la recherche d’opportunités professionnelles.
Agrégation de voyages : Permet de collecter des informations provenant de nombreux sites web d’hôtels et de compagnies aériennes et de les regrouper en un seul endroit.
Qu'est-ce qu'un outil de web scraping ?
Les outils de web scraping sont des logiciels conçus pour extraire automatiquement des données à partir de sites web. Ils sont utilisés pour collecter des informations à des fins diverses, notamment l'analyse de données, la recherche, le suivi des prix, etc. Nous allons vous présenter l'univers des outils de web scraping et vous expliquer comment ils peuvent vous aider à atteindre vos objectifs.
Comment fonctionnent les outils de web scraping ?
Les outils de web scraping fonctionnent en envoyant une requête à un site web, puis en extrayant les données du code HTML renvoyé par ce dernier. Ces données peuvent ensuite être stockées et analysées pour en tirer des enseignements, ou utilisées à d’autres fins.
Quels sont les avantages d’utiliser un outil de web scraping ?
Les principaux avantages de l’utilisation d’un outil de web scraping sont notamment le gain de temps, la réduction du travail manuel et la collecte de grandes quantités de données provenant de multiples sources. Grâce à un outil de web scraping, vous pouvez collecter rapidement et facilement les données dont vous avez besoin, ce qui vous libère du temps pour d’autres tâches importantes.
Quels sont les différents types d’outils de web scraping ?
Il existe plusieurs types d’outils de web scraping, notamment les scrapers basés sur le cloud, les scrapers locaux et les extensions de navigateur. Chaque type d’outil possède ses propres caractéristiques et avantages, et le choix de l’outil le mieux adapté à vos besoins dépendra de vos besoins et objectifs spécifiques.
Comment choisir un outil de web scraping ?
Lorsque vous choisissez un outil de web scraping, tenez compte de facteurs tels que la facilité d’utilisation, la rapidité et le coût. Il est également important de prendre en considération le type de données que vous devez extraire, car certains outils peuvent ne pas être capables de gérer des sites web complexes ou dynamiques.
Quels outils pouvez-vous utiliser pour extraire des données du Web ?
Voici quelques-uns des outils de web scraping les plus populaires :
Beautiful Soup : Beautiful Soup est une bibliothèque Python qui facilite l’extraction de données à partir de fichiers HTML et XML. C’est l’un des outils de web scraping les plus couramment utilisés ; il est particulièrement adapté aux sites web complexes et mal formatés.
Scrapy : Scrapy est une autre bibliothèque Python dédiée au web scraping. Elle est plus puissante que Beautiful Soup, mais aussi plus complexe. Si vous maîtrisez Python, Scrapy est un excellent choix pour les projets de web scraping à grande échelle.
Octoparse : Octoparse scraper est un outil de scraping web sous Windows qui ne nécessite aucune programmation. Il est facile à utiliser et offre une interface visuelle pour créer des workflows de scraping web.
Parsehub : Parsehub est un outil de scraping en ligne qui ne nécessite aucune programmation. Il est similaire à Octoparse mais fonctionne sur n’importe quel système d’exploitation équipé d’un navigateur web.
WebHarvy : WebHarvy est un autre outil de scraping visuel qui ne nécessite aucune programmation. Il est facile à utiliser et prend en charge Windows et Mac.
Scraper API : le scraper flexible de Geonode est conçu pour rendre le web scraping facile et efficace pour les développeurs, qu’ils soient débutants ou expérimentés.
Ce ne sont là que quelques-uns des nombreux outils de web scraping disponibles. Lors du choix d’un outil, il est important de tenir compte de votre niveau de compétence technique, de l’ampleur des projets sur lesquels vous travaillerez et de vos besoins spécifiques. Quel que soit l’outil que vous choisirez, vous constaterez à coup sûr que le web scraping est un moyen précieux et efficace de collecter des données sur le Web.
En quoi consiste le processus de web scraping ?
Le processus de web scraping peut être décomposé en plusieurs étapes :
- Déterminer le site web cible et les données à extraire : La première étape consiste à identifier le site web à partir duquel vous souhaitez extraire des données, ainsi que les données spécifiques que vous souhaitez collecter.
- Examiner le site web : avant de commencer le scraping, il est important d’examiner le site web pour comprendre sa structure et identifier les données disponibles. Cela peut vous aider à choisir les outils et les techniques adaptés au processus de scraping.
- Choisissez un outil de scraping ou écrivez du code : il existe de nombreux outils de scraping Web, qu’ils soient open source ou payants. Parmi les choix les plus courants, on trouve BeautifulSoup, Scrapy et Selenium. Vous pouvez également écrire votre propre code pour extraire les données du site Web à l’aide d’un langage de programmation tel que Python ou Java.
- Écrivez le code ou configurez l’outil de scraping : Une fois que vous avez choisi un outil ou décidé d’écrire votre propre code, vous devrez le configurer pour extraire les données souhaitées du site web. Cela peut impliquer d’écrire du code pour parcourir le site et extraire des éléments spécifiques, ou de configurer l’outil de scraping afin qu’il identifie les données recherchées.
- Lancer le scraper : Une fois votre code ou votre outil de scraping configuré, vous pouvez lancer le scraper pour extraire les données du site web. En fonction de la taille du site et du volume de données que vous souhaitez collecter, ce processus peut prendre plusieurs minutes, voire plusieurs heures.
- Nettoyer et analyser les données : La dernière étape consiste à nettoyer et à analyser les données que vous avez collectées. Cela peut impliquer de supprimer les données non pertinentes, de les mettre au format utilisable et d’effectuer toutes les analyses nécessaires pour en tirer des enseignements.
En suivant ces étapes, vous pouvez extraire efficacement des données de sites web et les utiliser pour obtenir des informations utiles ou étayer vos décisions commerciales.
Conclusion
Les outils de scraping sont des outils utiles qui vous aident à obtenir rapidement et efficacement les données dont vous avez besoin. Il existe de nombreux types d’outils de scraping et vous pouvez les utiliser pour extraire divers types de données.
Avec les bons outils, vous pouvez optimiser le processus de collecte et gagner beaucoup de temps et d’efforts. Lorsque vous choisissez un outil, il est important de tenir compte de votre niveau de compétences techniques, de l’ampleur des projets sur lesquels vous allez travailler et de vos besoins spécifiques.
Si vous souhaitez tester un excellent outil de web scraping, vous pouvez découvrir Scraper API de . Vous pouvez l'essayer gratuitement et voir s'il répond à vos besoins.