

Scrapyは、インターネット上の誰でも無料で利用できるオープンソースのウェブクローリングフレームワークです。Scrapyは主にウェブクローリングやウェブスクレイピングに使用されます。これは、あらゆるウェブページからデータを抽出するための高速かつ簡単な方法であり、現在はZyteがメンテナンスを行っています。
Scrapyのインストール
Scrapyをインストールするには、Python 3.7以降が必要です。また、システムパッケージとの競合を避けるため、専用のvirtualenvにインストールすることをお勧めします。
お使いのプラットフォームに合わせて、ダウンロードしてください。
Scrapyをインストールするには、AnacondaまたはMinicondaをインストールし、Pythonを起動して、次のコマンドを実行します:
conda install -c conda-forge scrapy
あるいは、次のコマンドを実行することもできます:
pip install Scrapy
Ubuntu システムを使用している場合は、まず以下の依存関係をすべてインストールする必要があります:
sudo apt-get install python3 python3-dev python3-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
macOS システムを使用している場合は、Xcode コマンドラインツールをインストールする必要があります。ターミナルウィンドウを開き、次のコマンドを実行してください:
xcode-select --install
おめでとうございます!お使いのデバイスに Scrapy がインストールされました。それでは、Web サイトのクロールを試みて、データを抽出してみましょう。
Scrapy プロジェクトの開始
新しい Scrapy プロジェクトを開始するには、コードを保存するディレクトリを指定する必要があります。次のコマンドを実行してください:
scrapy startproject scrapetest
このコマンドを実行すると、「scrapetest」という名前のディレクトリが作成され、その中には以下のファイルが含まれます:
_scrapetest/ scrapy.cfg # デプロイ設定ファイル
scrapetest/             # プロジェクトの Python モジュール。ここからコードをインポートします
    __init__.py

    items.py

    middlewares.py

    pipelines.py

    settings.py

    spiders/          # 後でスパイダーを配置するディレクトリ
        __init__.py
_
Scrapy プロジェクトを開始したら、次はスパイダーを作成する必要があります。スパイダーは、Scrapy がウェブページから情報を抽出するために使用するものであるため、必須です。例として、ウェブサイト「quotes.toscrape.com」からデータをスクレイピングします。
まず、次のコードを実行します:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" # スパイダー名は一意である必要があります 作成するスパイダーごとに
def start_requests(self):
    urls = [
        'https://quotes.toscrape.com/page/1/',
        # これらのURLを、
スクレイピングしたいWebページに変更してください 'https://quotes.toscrape.com/page/2/', ] for url in urls: yield scrapy.Request(url=url, callback=self.parse)
def parse(self, response):
    page = response.url.split("/")[-2]
    filename = f'quotes-{page}.html'
    with open(filename, 'wb') as f:
        f.write(response.body)
    self.log(f'ファイル {filename} を保存しました')
_
スパイダーがクロールを開始するには、次のコマンドを実行する必要があります:
scrapy crawl test
すると、「quotes.toscrape.com」のウェブサイトをクロールしたことを示す出力が表示されるはずです。
ウェブページから特定のデータを抽出したい場合は、Pythonのキーワード「yield」を使用し、以下のコードを実行します:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', 'https://quotes.toscrape.com/page/2/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }
_
このコードは、スクレイピングしたウェブページからテキスト、著者、タグを抽出し、それらをログに表示します。
特定のページだけでなく、ウェブサイト内のすべてのページをスクレイピングしたい場合は、次のように実行します:
_import scrapy
class QuotesSpider(scrapy.Spider): name = "test" start_urls = [ 'https://quotes.toscrape.com/page/1/', ]
def parse(self, response):
    for quote in response.css('div.quote'):
        yield {
            'text': quote.css('span.text::text').get(),
            'author': quote.css('small.author::text').get(),
            'tags': quote.css('div.tags a.tag::text').getall(),
        }

    next_page = response.css('li.next a::attr(href)').get()
    if next_page is not None:
        next_page = response.urljoin(next_page)
        yield scrapy.Request(next_page, callback=self.parse)
_
次に、スパイダーが抽出したデータを保存する必要があります。スクレイピングしたデータを保存するには、単に次のコマンドを実行してください:
scrapy crawl test -O test.json
既存のファイルに新しいコンテンツを追加したい場合は、代わりに次のコードを実行してください:
scrapy crawl quotes -o quotes.jsonl
おめでとうございます!Scrapy を使ってデータをスクレイピングし、保存する作業が完了しました。Scrapy によるウェブスクレイピングを確実に成功させるために、さらに追加できることがあります。それは、Scrapy プロキシを利用することです。
Scrapyプロキシの設定
Scrapyプロキシは、すべてのWebリクエストを代行して処理するため、スクレイピング対象のウェブサイトにはプロキシサーバーのIPアドレスのみが表示されます。 あなたのIPアドレスは完全に隠されます。IPアドレスを継続的にローテーションさせ、住宅用プロキシを利用することで、ウェブサイトは、あなたのリクエストがScrapyのようなウェブスクレイピングボットを使用している誰かからのものではなく、本物のユーザーからのものだと錯覚させることができます。
例として、ここではGeonodeプロキシを使用します。Geonodeプロキシの詳細をまだ入手していない場合は、「Geonode を使用したプロキシサーバーの詳細の取得」のセクションに進んでください。
Scrapyでプロキシを設定するには2つの方法があります。
1つ目の方法は、HTTPProxyMiddlewareと呼ばれるScrapyのミドルウェアを利用することです。これにより、プロキシパラメータが自動的にデフォルトのプロキシとして設定されます。
次のように実行できます:
_def start_requests(self): for url in self.start_urls: return Request(url=url, callback=self.parse, headers={"User-Agent": "My UserAgent"}, meta={"proxy": "premium-residential.geonode.com:9001"}) _
2つ目の方法は、独自のミドルウェアを作成することです。この方法はより独立性が高く、自由度も高くなります。
次のように実行できます:
_from w3lib.http import basic_auth_header
DOWNLOADER_MIDDLEWARES = { 'myproject.middlewares.CustomProxyMiddleware': 350, 'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 400, }
class CustomProxyMiddleware(object): def process_request(self, request, spider): request.meta[“proxy”] = "premium-residential.geonode.com:9001" request.headers[“Proxy-Authorization”] = basic_auth_header(“geonode_xbYe9H2LYr”, “9806022c-cd4a-4776-a053-73fee44344dd”) _
おめでとうございます!これで、Scrapyを使ってウェブサイトをスクレイピングする際に、プロキシサーバーが追加されました。プロキシが正常に動作しているか確認したい場合は、https://www.geonode.com/what-is-my-ipにアクセスしてみてください。
Geonode
を使用してプロキシサーバーの詳細を取得する### 手順 1. **Geonode
** にアクセスし、既存のアカウントでログインするか、新規登録を行ってください。
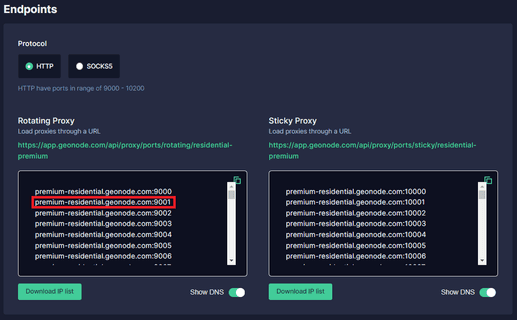
手順 2. ホームページで、**「Residential Services」**をクリックします。

手順 3. **「Endpoints」**が表示されるまで画面を下にスクロールします。
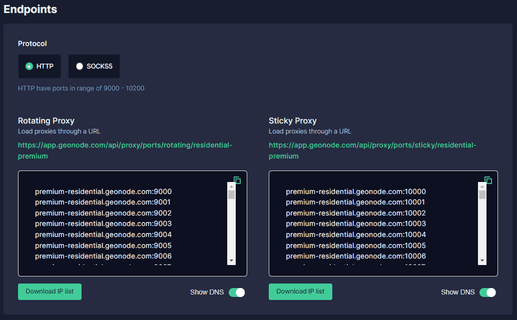
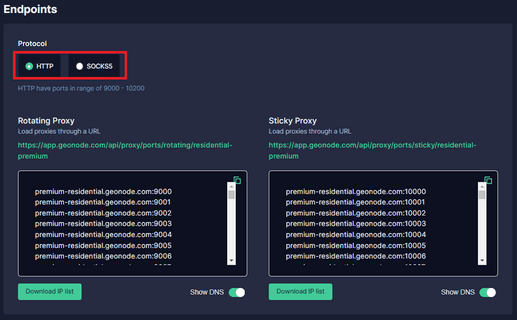
手順 4. 使用する 「プロキシプロトコル」 を選択します:「HTTP プロトコル」 または **「[SOCKS5
プロトコル](https://geonode.com/blog/beginners-guide-to-socks5-proxies)」**。
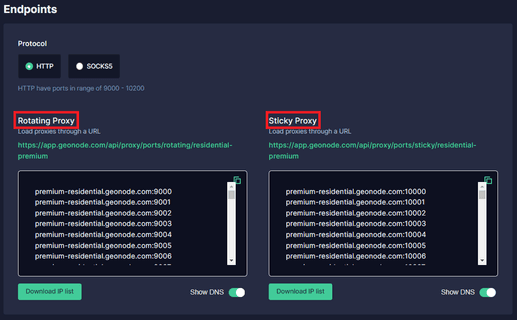
手順 5. 使用する 「セッションタイプ」 を選択します:「ローテーションプロキシ」 または スティッキープロキシ。
ステップ 6. 使用するプロキシを選択します。例として、ハイライト表示されているプロキシ **「premium-residential.geonode
.com:9001」** を使用します。
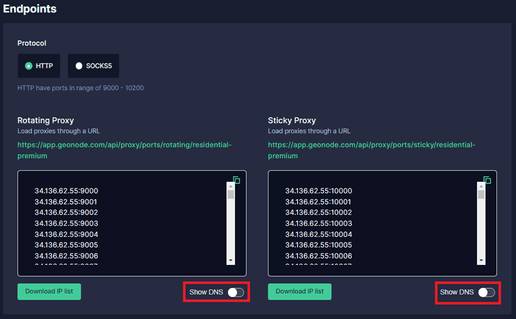
DNSの代わりにIPアドレスを使用したい場合は、「Show DNS」ボタンのチェックを外すだけで、IPアドレスが表示されます。
ステップ 7. 次に、プロキシアカウントの 「認証情報」 が必要です。Geonode
の場合、これはアカウントのホームページに表示されています。
