ウェブスクレイピングとは?
ウェブスクレイピングは、ウェブデータ抽出やウェブハーベスティングとも呼ばれ、自動化されたソフトウェアを使用してウェブサイトからデータを抽出するプロセスです。手動で行う場合(手作業でデータをコピー&ペーストするなど)もあれば、自動で行う場合(ウェブスクレイパーを通じて情報を抽出するなど)もあります。
手作業で行うには、特に大量のデータをスクレイピングする場合、時間と労力がかかります。そのため、多くのユーザーはウェブスクレイパーを利用して作業を代行させることを好みます。この技術により、個人や組織は複数の情報源から迅速かつ効率的に情報を収集することができます。
ウェブからどのようなデータをスクレイピングできますか?
ウェブからスクレイピングできるデータには、以下のようなさまざまな種類があります。
テキストデータ。これには、見出し、記事、商品説明から、コメント、レビューなど、あらゆるものが含まれます。
画像や動画。 ウェブサイトから写真や動画をスクレイピングできます。これには、商品画像やインフォグラフィックなどが含まれます。
構造化データ。この種のデータは、表、スプレッドシート、データベースなど、特定の形式で整理されています。構造化データの例としては、商品リスト、不動産物件情報、財務データなどが挙げられます。
非構造化データ。この種のデータは特定の形式で整理されておらず、ソーシャルメディアの投稿やコメントなどが含まれます。
メタデータ。この種のデータは、ウェブページの最終更新日や投稿の著者など、他の種類のデータに関する情報を提供します。
ウェブスクレイピングで利用可能なさまざまなデータの種類を理解することで、特定のニーズに最も役立つデータを特定し、そのデータを効果的にスクレイピングするための戦略を立てることができます。
ウェブスクレイピングは合法か?
ウェブスクレイピングは合法ですが、ウェブサイト運営側は、ユーザーが自分のサイトをスクレイピングすることにはあまり好意的ではありません。もし運営側が、あなたがそのサイトでウェブスクレイパーやその他の自動化ツールを使用していることを検知した場合、直ちにあなたのアカウントを凍結し、IPアドレスをブラックリストに登録するでしょう。
ウェブスクレイピングの合法性について詳しく知りたい場合は、こちらの詳細な記事をご覧ください:ウェブスクレイピングの合法性と誤解。
ウェブスクレイパーはどのように機能するのでしょうか?
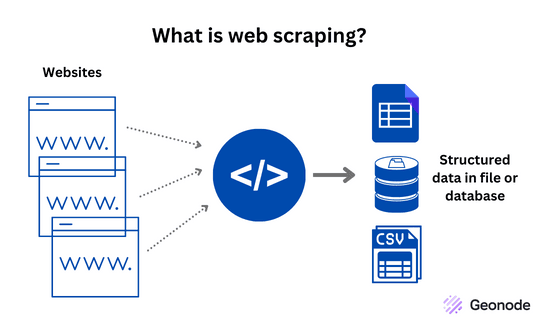
基本的に、ウェブスクレイピングとは、ウェブサイトのサーバーにリクエストを送信し、HTMLコードをダウンロードした後、目的の情報を抽出するプロセスです。リクエストは通常、ウェブスクレイパーツールを使用するか、Pythonなどのプログラミング言語を用いたプログラム的な手法で行われます。
HTMLコードを受信すると、ウェブスクレイパーツールやプログラムはそのコードを解析し、抽出したい特定のデータを見つけ出します。これは多くの場合、「データ抽出」と呼ばれる手法を用いて行われ、ルールやパターンに基づいてHTMLコードから情報を抽出します。
抽出されたデータは、その後の分析や利用のために、スプレッドシートやデータベースなどの構造化された形式で保存されます。
ウェブスクレイパーにはどのような種類があるか?
ウェブスクレイパーにはいくつかの種類があり、それぞれ独自の機能や性能を備えています。このガイドでは、さまざまな種類のウェブスクレイパーについて解説しますので、ご自身のニーズに合ったものを選ぶ参考にしてください。
シンプルなスクリーンスクレイパー
シンプルなスクリーンスクレイパーは、ウェブスクレイパーの中でも最も基本的なタイプです。ウェブサイトから情報をコピーしてローカルファイルに貼り付けることで、データを抽出します。通常、小規模なプロジェクトで使用され、高度な技術知識を必要としません。
高度なスクリーンスクレイパー
高度なスクリーンスクレイパーは、シンプルなスクリーンスクレイパーよりも高度で、大規模なプロジェクトに使用されます。スクリプトを使用してスクレイピングプロセスを自動化することで、ウェブサイトからデータを抽出し、より高速かつ効率的に処理します。高度なスクリーンスクレイパーは、APIを使用してデータにアクセスすることが多く、これにより大量の情報を抽出することが可能です。
ヘッドレスブラウザ
ヘッドレスブラウザは、グラフィカルユーザーインターフェースを使用しないウェブスクレイパーです。バックグラウンドで動作し、ブラウザウィンドウにウェブサイトを表示することなく、ウェブサイトからデータを抽出します。
ヘッドレスブラウザは、従来のウェブブラウザよりも高速かつ効率的であり、ページ全体を読み込むことなくウェブサイトからデータを抽出できるため、ウェブスクレイピングに有用です。
ウェブクローラー
ウェブクローラーは、大規模なウェブサイトを巡回し、複数のページから情報を抽出するように設計されたウェブスクレイパーの一種です。特定のページから開始し、リンクをたどって他のページへ移動しながら、その過程で情報を抽出していきます。
ウェブクローラーは、検索エンジン向けの情報収集から、ウェブサイトの変更状況の監視に至るまで、幅広いタスクに利用されています。
自作のウェブスクレイパー
自作のウェブスクレイパーとは、個人や組織がPython、Ruby、JavaScriptなどのプログラミング言語を使用して自ら作成するウェブスクレイピングツールのことです。このアプローチにより、特定のウェブサイトのスクレイピング、データの種類、頻度など、ニーズに合わせてウェブスクレイパーを細かく調整することが可能です。
自作のウェブスクレイパーは、既製のソリューションを使用する場合に比べ、通常、より高度な技術的専門知識と時間を必要とします。しかし、このアプローチの利点は、作成されたウェブスクレイパーを高度にカスタマイズできることであり、スクレイピングプロセスや生成されるデータをより細かく制御できる点にあります。
ブラウザ拡張機能型ウェブスクレイパー
ブラウザ拡張機能型ウェブスクレイパーとは、ウェブブラウザに直接統合され、ウェブサイトからのデータスクレイピングプロセスを自動化するソフトウェアツールです。このタイプのスクレイパーは、ブラウザ内でシームレスに動作するように設計されており、異なるプログラムやアプリケーションを切り替えることなく、必要なデータに簡単にアクセスできます。
ブラウザ拡張機能型のウェブスクレイパーを使えば、スクレイピングしたいデータを簡単に選択し、スクレイピングのパラメータを設定できます。あとはスクレイパーが自動的に処理を行います。必要なデータを抽出し、整理された見やすい形式で表示するため、手動でのスクレイピングに比べて時間と労力を節約できます。
ユーザーインターフェース型ウェブスクレイパー
UIウェブスクレイパーは、ユーザーがスクレイピングしたいデータを選択できるインターフェースを提供することで機能します。 ユーザーはインターフェースを操作して抽出したいデータを選択するだけで、残りの作業はスクレイパーが自動的に行います。ウェブサイトを自動的に巡回し、データを抽出して、CSV、Excel、またはデータベースなどの構造化された形式で保存します。
UIウェブスクレイパーを利用する主な利点の一つは、コーディングの知識が不要であることです。抽出したいデータをポイント&クリックするだけで選択できます。そのため、技術的な専門知識がなくても簡単なスクレイピング作業を行いたい方にとって、最適な選択肢となります。
UIウェブスクレイパーのもう一つの利点は、その使いやすさです。ユーザーフレンドリーに設計されており、新しいソフトウェアを習得する必要なく、すぐに使い始めることができます。手順に従うだけで、あっという間にデータを取得できます。
クラウドウェブスクレイパー
クラウド型ウェブスクレイパーとは、クラウドベースのインフラ上でウェブスクレイピングタスクを実行できるツールです。スクレイピングを自分のコンピュータで行う代わりに、クラウド上のリモートサーバーの処理能力を活用できます。これにより、ローカルハードウェアの制限を気にすることなく、大規模なウェブサイトのスクレイピングや大量のデータ処理が可能になります。
クラウドWebスクレイパーを利用する主な利点の一つは、ストレージ、処理能力、帯域幅など、事実上無制限のリソースにアクセスできることです。これにより、パフォーマンスの問題を心配することなく、最大規模で最も複雑なウェブサイトであってもスクレイピングを行うことができます。
もう一つの利点は、たとえ自分のコンピュータが電源オフの状態であっても、24時間365日、中断することなくウェブスクレイピングタスクを実行できることです。これは、クラウド型ウェブスクレイパーを、常に電源が入った状態のリモートサーバー上で実行するように設定できるためです。
ローカルWebスクレイパー
ローカルWebスクレイパーは、クラウド上のリモートサーバーではなく、自分のコンピュータ上で動作するWebスクレイピングツールの一種です。抽出するデータ量が限られている小規模なWebスクレイピングプロジェクトには適しています。 また、データのプライバシーが懸念される場合や、一般のインターネットからはアクセスできないウェブサイトをスクレイピングする必要がある場合にも適しています。
ローカルWebスクレイパーを使用する主な利点の一つは、設定や使用が簡単であることです。 開始するために専門的な知識や技術的なスキルは必要なく、すぐにデータのスクレイピングを開始できます。
もう一つの利点は、スクレイピングプロセスを完全に制御できることです。必要な形式でデータを抽出するようにスクレイパーを設定できるほか、スクレイピングタスクの実行頻度やスケジュールも設定可能です。
ウェブスクレイピングでよく使われるプログラミング言語にはどのようなものがありますか?
ウェブスクレイピングには多くのプログラミング言語が利用可能で、それぞれに長所と短所があります。ここでは、ウェブスクレイピングで特に人気のあるプログラミング言語をいくつか紹介します。
Python:Pythonは、ウェブスクレイピングにおいて最も人気のあるプログラミング言語の一つです。大規模で活発なコミュニティがあり、ウェブスクレイピング専用のライブラリやツールが数多く開発されています。BeautifulSoupとScrapyは、ウェブスクレイピングで最も広く使用されているPythonライブラリの2つです。
Ruby: Rubyも、ウェブスクレイピングで人気のあるプログラミング言語の一つです。大規模で活発なコミュニティがあり、ウェブスクレイピング用のライブラリやツールが数多く利用可能です。Nokogiriは、ウェブスクレイピングで人気のあるRubyライブラリです。
JavaScript: JavaScriptは、多くのウェブサイトの基盤として使用されているため、ウェブスクレイピングでも人気のある言語です。 Node.jsの台頭に伴い、JavaScriptはサーバーサイドのウェブスクレイピングにおいても人気のある選択肢となっています。Puppeteerは、ウェブスクレイピング用の有名なJavaScriptライブラリです。
PHP: PHPは、ウェブサイトの構築に広く使用されているため、ウェブスクレイピングで人気のあるプログラミング言語です。 PHP を使ったウェブスクレイピングには、多くのライブラリやツールが利用可能です。Simple HTML DOM は、ウェブスクレイピング用の一般的な PHP ライブラリです。
Java: Java は、その効率性と拡張性から、ウェブスクレイピングに広く利用されているプログラミング言語です。Java を使ったウェブスクレイピングには、JSoup や HtmlUnit など、多くのライブラリやツールが利用可能です。
ウェブスクレイパーは何に使われるのか?
ウェブスクレイピングは、以下のようなさまざまな目的で利用されています。
データ収集:ウェブサイトから大量のデータを収集し、分析や調査に活用できる構造化された情報に変換するために使用できます。 このデータは、情報に基づいたビジネス上の意思決定や業界動向の追跡などに活用できます。
ブランドモニタリング:一般に公開されている顧客レビューを収集し、顧客の意見をモニタリングするために利用できます。この情報は、オンライン上の評判を維持し、さらには向上させるのに役立ちます。
不動産物件情報: 物件価格、物件タイプ、物件の所在地など、さまざまな不動産データに関する情報を収集するために利用できます。
価格モニタリング:ECサイト上の価格を監視し、競合他社の価格動向を追跡するために利用できます。この情報は、価格戦略を調整し、競争力を維持するために活用できます。
リードジェネレーション:見込み顧客に関する情報を収集し、営業やマーケティングを目的としたターゲットリストを作成するために利用できます。
ソーシャルメディアモニタリング:ソーシャルメディア上で自社ブランド、競合他社、または業界に関する言及を監視し、オーディエンスに関する貴重な洞察やデータを収集するために利用できます。
価格インテリジェンス:世界中の製品価格情報を収集・比較し、それらを一か所にまとめることができます。
ニュースおよびコンテンツモニタリング:ニュースサイトを含む複数の情報源から情報を収集し、一か所にまとめることで、アクセスや分析を容易にします。
求人情報:さまざまなウェブサイトから求人情報を収集し、一か所にまとめて、求人情報を簡単に見つけられるようにします。
旅行情報の集約:多くのホテルや航空会社のウェブサイトから情報を収集し、一か所にまとめて表示します。
ウェブスクレイピングツールとは?
ウェブスクレイピングツールとは、ウェブサイトからデータを自動的に抽出するために設計されたソフトウェアプログラムのことです。データ分析、調査、価格監視など、さまざまな目的で情報を収集するために利用されます。ここでは、ウェブスクレイピングツールの世界をご紹介し、それらがどのように目標達成に役立つかを解説します。
ウェブスクレイピングツールはどのように機能するのでしょうか?
ウェブスクレイピングツールは、ウェブサイトへリクエストを送信し、ウェブサイトから返されるHTMLコードからデータを抽出することで機能します。このデータは、洞察を得るために保存・分析したり、その他の目的に利用したりすることができます。
ウェブスクレイピングツールを使用するメリットは何ですか?
ウェブスクレイピングツールを利用する主なメリットには、時間の節約、手作業の軽減、複数のソースからの大量のデータ収集などが挙げられます。ウェブスクレイピングツールを使えば、必要なデータを迅速かつ簡単に収集でき、他の重要な業務に充てる時間を確保できます。
ウェブスクレイピングツールにはどのような種類がありますか?
ウェブスクレイピングツールには、クラウドベースのスクレイパー、ローカルスクレイパー、ブラウザ拡張機能など、いくつかの種類があります。各ツールには独自の機能と利点があり、どのツールが適しているかは、具体的なニーズや目標によって異なります。
ウェブスクレイピングツールの選び方は?
ウェブスクレイピングツールを選ぶ際は、使いやすさ、処理速度、コストなどの要素を考慮してください。また、スクレイピングが必要なデータの種類も重要な検討事項です。ツールによっては、複雑または動的なウェブサイトを処理できない場合があるためです。
ウェブスクレイピングにはどのようなツールが利用できますか?
以下に、利用可能な最も人気のあるウェブスクレイピングツールをいくつか紹介します:
Beautiful Soup:Beautiful Soupは、HTMLやXMLファイルからデータを簡単にスクレイピングできるPythonライブラリです。最も一般的に使用されているウェブスクレイピングツールの一つであり、複雑でフォーマットが乱れたウェブサイトの処理に最適です。
Scrapy:Scrapyもウェブスクレイピング用のPythonライブラリです。Beautiful Soupよりも強力ですが、その分複雑でもあります。Pythonの経験がある方なら、大規模なウェブスクレイピングプロジェクトにScrapyは最適な選択肢です。
Octoparse: Octoparseスクレイパーは、コーディングを必要としないWindowsベースのウェブスクレイピングツールです。使いやすく、ウェブスクレイピングのワークフローを構築するためのビジュアルインターフェースを備えています。
Parsehub: Parsehubは、コーディングを必要としないWebベースのWebスクレイピングツールです。Octoparseと似ていますが、WebブラウザがあればどのOSでも動作します。
WebHarvy: WebHarvyも、コーディングを必要としないビジュアル型のWebスクレイピングツールです。 使いやすく、WindowsとMacの両方に対応しています。
Scraper API: Geonodeの柔軟なウェブスクレイパーは、初心者からベテランまで、あらゆる開発者がウェブスクレイピングを簡単かつ効率的に行えるように設計されています。
これらは、数あるウェブスクレイピングツールの一部に過ぎません。 ツールを選ぶ際には、自身の技術レベル、取り組むプロジェクトの規模、そして具体的なニーズを考慮することが重要です。どのツールを選んだとしても、ウェブスクレイピングはウェブからデータを収集するための価値ある効率的な方法であることに間違いありません。
ウェブスクレイピングのプロセスとは?
ウェブスクレイピングのプロセスは、いくつかのステップに分けられます:
- 対象となるウェブサイトとスクレイピングするデータを特定する:最初のステップは、データを抽出したいウェブサイトと、収集したい具体的なデータを特定することです。
- ウェブサイトの調査:スクレイピングを開始する前に、ウェブサイトの構造や利用可能なデータを把握するために調査を行うことが重要です。これにより、スクレイピングプロセスに適切なツールや手法を選定するのに役立ちます。
- スクレイピングツールの選択、またはコードの作成:ウェブスクレイピングには、オープンソースのものから有料のものまで、多くのツールが利用可能です。代表的なものには、BeautifulSoup、Scrapy、Seleniumなどがあります。あるいは、PythonやJavaなどのプログラミング言語を使用して、ウェブサイトをスクレイピングするためのコードを自作することもできます。
- コードを記述するか、スクレイピングツールを設定する:ツールを選定するか、コードを記述することに決めたら、ウェブサイトから必要なデータを抽出できるよう設定を行う必要があります。これには、ウェブサイトをナビゲートして特定の要素を抽出するためのコードを記述したり、必要なデータを特定するようにスクレイピングツールを設定したりすることが含まれます。
- スクレイパーを実行する:コードやスクレイピングツールの設定が完了したら、スクレイパーを実行してウェブサイトからデータを抽出します。ウェブサイトの規模や収集したいデータの量によっては、この処理に数分から数時間かかる場合があります。
- データのクリーニングと分析: 最後のステップは、収集したデータのクリーニングと分析です。これには、無関係なデータの削除、データを実用的な形式に整えること、そしてデータから洞察を得るために必要な分析を行うことが含まれます。
これらの手順に従うことで、ウェブサイトから効果的にデータをスクレイピングし、そのデータを活用して洞察を得たり、ビジネスの意思決定を支援したりすることができます。
まとめ
ウェブスクレイパーは、必要なデータを迅速かつ効率的に取得するのに役立つ便利なツールです。ウェブスクレイパーにはさまざまな種類があり、それらを活用することで多種多様なデータを取得することができます。
適切なツールを使えば、データ収集プロセスを最適化し、時間と労力を大幅に節約できます。ツールを選ぶ際には、自身の技術レベル、取り組むプロジェクトの規模、そして具体的なニーズを考慮することが重要です。
優れたウェブスクレイピングツールを試してみたい場合は、GeonodeのScraper APIをチェックしてみてください。無料で試用して、ご自身やニーズに合っているかどうかを確認できます。